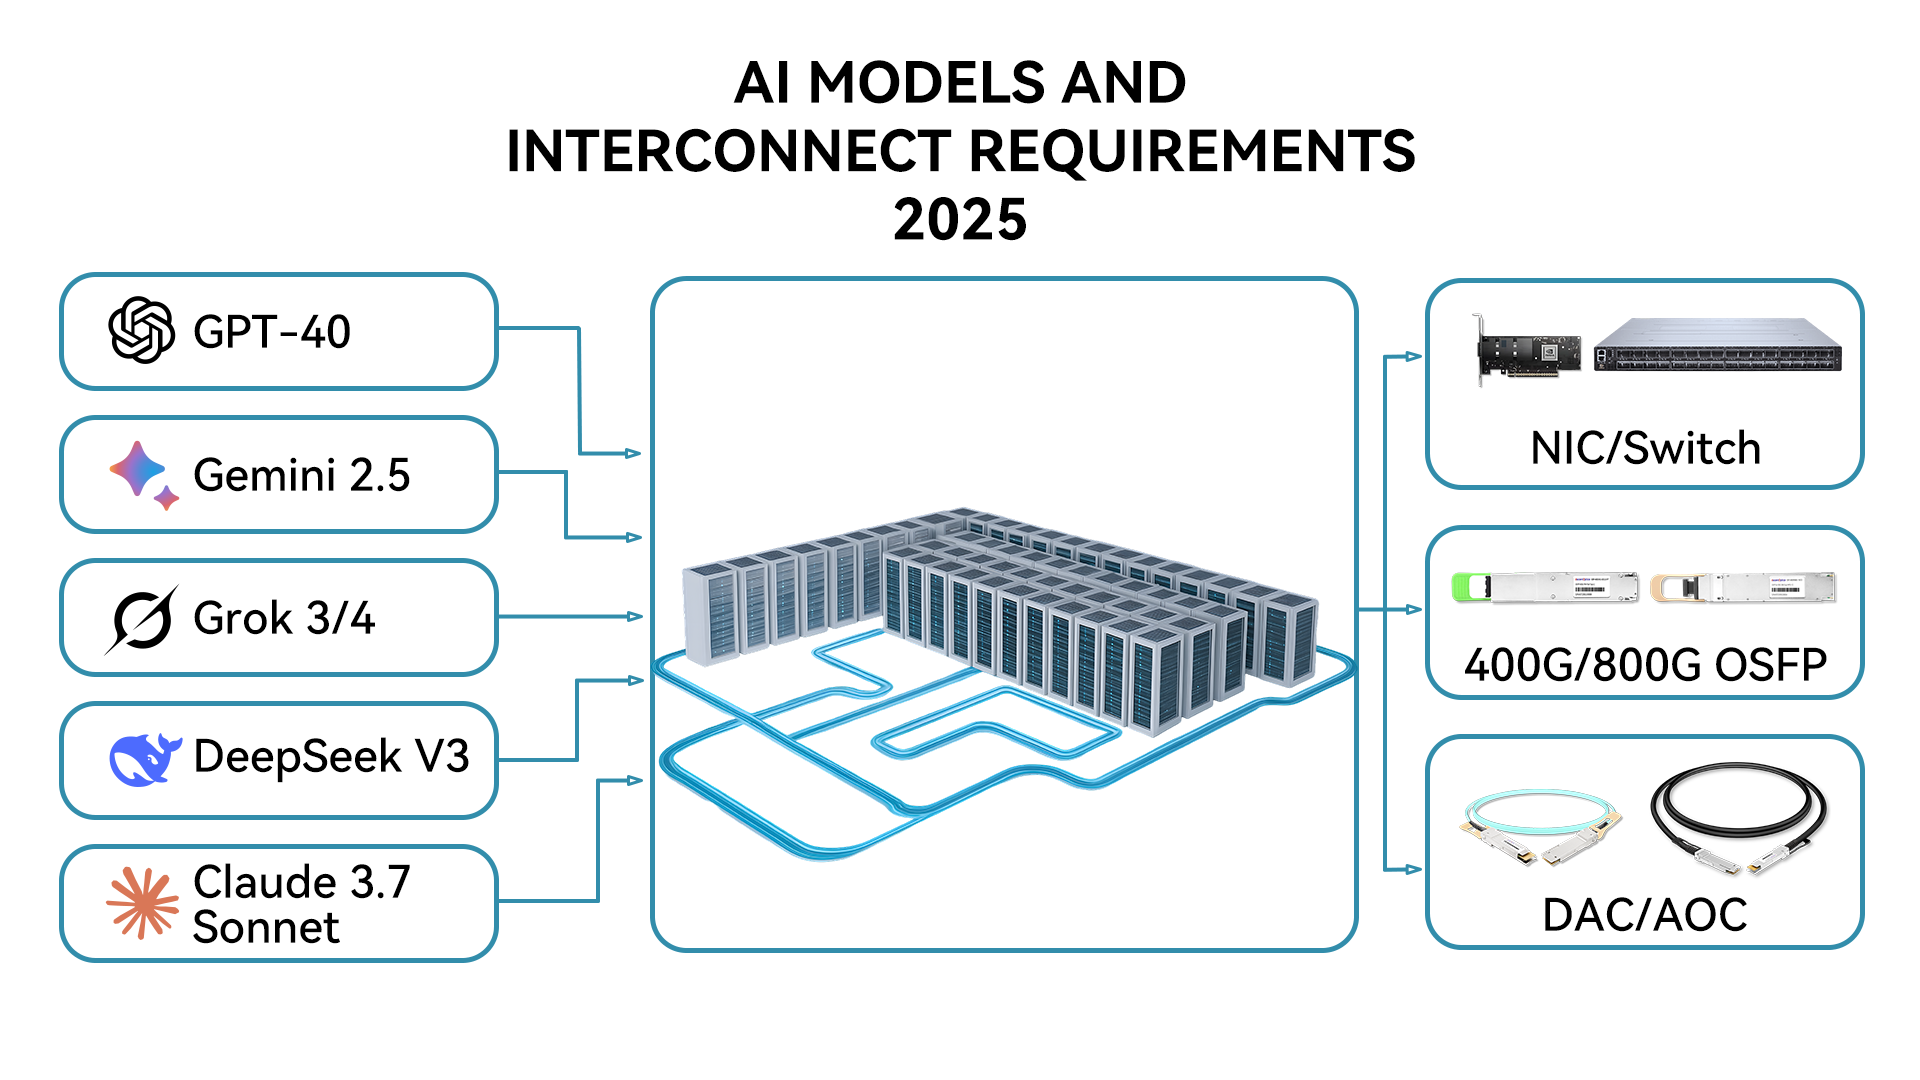
2025 yılında, yapay zekanın (YZ) hızlı gelişimi veri merkezi mimarilerini yeniden şekillendiriyor. Çok modlu büyük dil modellerinden açık ve verimli çerçevelere kadar YZ, inovasyonun temel itici gücü haline geldi. YZ modellerinin ölçeği, yüz milyonlarca parametreden trilyon seviyesine kadar genişliyor ve eğitim, paralel olarak binlerce hatta on binlerce GPU'yu içeriyor. Örneğin, OpenAI'nin GPT -4o ve benzeri modeller, verimli çıkarım ve eğitim sağlamak için gerçek zamanlı veri senkronizasyonu gerektiriyor. Bu, yalnızca TB/s seviyesinde veri aktarım hızı değil, aynı zamanda darboğazları ortadan kaldırmak için mikrosaniye seviyesinde gecikme ve yüksek güvenilirlik de gerektiriyor.
Bu bağlamda, geleneksel 100G/200G ağ bağlantıları artık gereksinimleri karşılayamıyor. 400G/800G OSFP optik modülleri daha kompakt ve verimli bir bağlantı çözümü sunarken, DAC (Doğrudan Bağlantı Kablosu) ve AOC (Aktif Optik Kablo) kısa mesafeli bağlantılar için tercih edilen seçenekler olup, maliyet ve güç tüketimini etkili bir şekilde optimize ediyor. Yapay zeka artık yalnızca algoritmik inovasyonla ilgili değil, fiziksel altyapıyla derinlemesine entegre edilmiş sistem düzeyinde bir mühendislik çalışması.
En Son Yapay Zeka Modellerine ve Hesaplama Taleplerine Genel Bakış
2025'teki yapay zeka manzarası, çok yönlülük ve açık kaynaklı inovasyonla şekillenecek. Birkaç önde gelen model, bu gelişmelerin bağlantı taleplerini nasıl yeniden şekillendirdiğini vurguluyor:
GPT-4o (Açık AI)
Metin, görüntü ve konuşmada güçlü çok modlu işleme yetenekleriyle tanınan GPT-4o, binlerce GPU arasında senkronize eğitime dayanır. Her GPU, yüzlerce GB/sn hızında veri alışverişi gerektirir ve herhangi bir ara bağlantı darboğazı, eğitim süresini önemli ölçüde uzatabilir.
Claude 3.7 Sone (Antropik)
Kodlama ve karmaşık akıl yürütme görevlerinde uzmanlaşmış olan Claude 3.7 Sonnet, verimli çıkarımlar için gerçek zamanlı veri akışlarına ihtiyaç duyar. Ultra düşük gecikmeli ara bağlantılar olmazsa olmazdır ve 800G optik modüller yaklaşık 5 pJ/bit enerji verimliliği sağlar.
İkizler 2.5 (Google)
Çok modlu çıkarım ve bilimsel araştırma uygulamalarında mükemmellik sunan Gemini 2.5, yüksek bant genişliği ve büyük ölçekli dağıtık iletişime vurgu yapar. Performansı büyük ölçüde DWDM sistemlerine ve yüksek hızlı Ethernet bağlantılarına bağlıdır.
Grok 3/4 (xAI)
Dahili ses modu ve verimli çıkarım yetenekleriyle Grok 3/4, genellikle GB200 kümelerinde kullanılır. Her GPU, iki kat daha fazla performans elde etmek için 800 GbE arayüz gerektirir.
Lama 3 / DeepSeek V3 (Meta / DeepSeek)
Açık kaynaklı modellerin önde gelen temsilcileri olan Llama 3 ve DeepSeek V3, yüksek performans ve özelleştirilebilirliğe vurgu yapar. Dağıtık eğitimleri, 400G/800G ara bağlantılarına dayanır ve genel verimliliği %20-25 oranında artırır.
yapay zeka modeli
Geliştirici
Ana Özellikler
Hesaplama ve Bağlantı Gereksinimleri
GPT-4o
OpenAI
Çok modlu (metin, resim, konuşma); gelişmiş muhakeme; o1/o3 varyantlarını destekler
Eğitim sırasında GPU başına veri değişiminin yüzlerce GB/s'ye ulaşmasıyla büyük ölçekli GPU küme senkronizasyonu gerektirir; ara bağlantı darboğazları eğitim süresini 2-3 kat uzatabilir.
Claude 3.7 Sonesi
Antropik
Kodlama ve karmaşık görevlerde güçlü; maliyet açısından verimli
Çıkarım, gerçek zamanlı veri akışına dayanır ve eş zamanlı sorguları desteklemek için ultra düşük gecikmeli ara bağlantılar gerektirir; 800G optikler enerji maliyetini ~5 pJ/bit'e düşürebilir.
İkizler 2.5
Google
Verimli çok modlu işleme; geliştiriciler ve araştırmacılar için optimize edilmiştir
Eğitimde paralel hesaplama vurgulanmakta olup, DWDM (Yoğun Dalga Boyu Bölmeli Çoğullama) çoklu dalga boyu iletimini idare etmek için yüksek bant genişliğine odaklanan ara bağlantı gereksinimleri bulunmaktadır.
Grok 3/4
xAI
Verimli çıkarım, ses modu desteği, açık kaynaklı kullanım
Genellikle büyük ölçekli kümelerde (örneğin GB200) dağıtılır ve her GPU'nun 800 kat performans ölçeklemesi elde etmek için 2 GbE bağlantısına ihtiyacı vardır.
Lama 3 / DeepSeek V3
Meta / Derin Arama
Açık kaynaklı, yüksek performanslı, özelleştirilebilir eğitim
Dağıtık eğitim, düğümler arası iletişime dayanır ve 400G/800G ara bağlantıları genel verimliliği yaklaşık %25 oranında artırır.
Bu modellerin ortak bir özelliği vardır: Sık sık "Hepimiz" iletişimi gerektiren Uzman Karışımı (MoE) veya benzeri mimarilere dayanırlar. GPT-4o gibi ultra büyük modellerin eğitimi petabayt düzeyinde veri alışverişlerini gerektirebilir ve yetersiz ara bağlantılar ağ maliyetlerini %70'ten fazla artırabilir.
Yapay Zeka Hesaplamasında Bağlantı Zorlukları
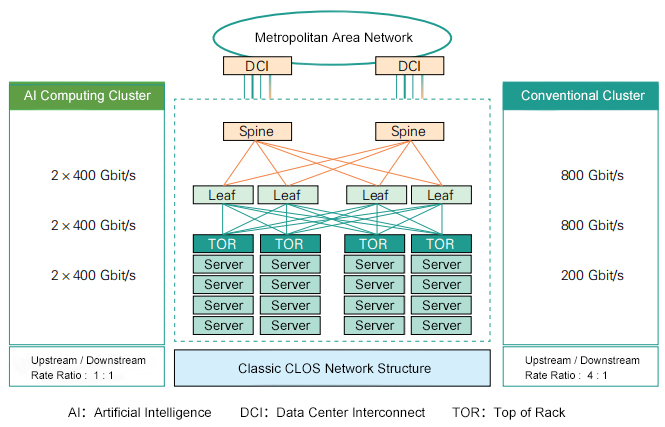
Yapay zeka eğitimi ve çıkarımının merkezinde, devasa GPU kümelerinin senkronizasyonu yer alır. Örneğin, bir NVIDIA GB200 kümesinde, her GPU, CPU darboğazlarını önlemek için PCIe Gen800 doğrudan iletişimini desteklemek adına 2 GbE (400×6 GbE) bağlantı gerektirir. Başlıca zorluklar şunlardır:
Yüksek Bant Genişliği Talebi:Yapay zeka iş yükleri, model parametre senkronizasyonu için saniyede terabaytlarca veri aktarımı gerektirir.
Ultra Düşük Gecikme SüresiClaude gibi modellerle kod oluşturma gibi çıkarım görevleri, mikrosaniye düzeyinde yanıt gerektirir. Küçük gecikmeler bile eğitim süresini iki katına çıkarabilir.
Ölçeklenebilirlik: Yüzlerce ila on binlerce GPU, yalnızca gerekli düğümler arasında bağlantıların kurulduğu, yalnızca Raylı ağlar için destek gerektirir.
Enerji Verimliliği ve Maliyet: Yapay zeka veri merkezleri büyük miktarda güç tüketiyor ve ara bağlantı verimliliğinin artırılması %50'ye kadar enerji tasarrufu sağlayabilir.
Yapay Zeka için Temel Bağlantı Çözümleri: OSFP, DAC ve AOC
1. OSFP Optik Modülleri
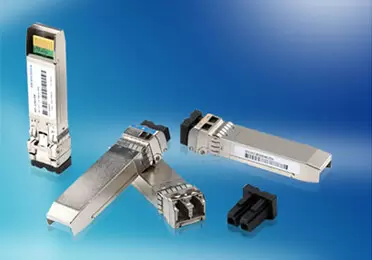
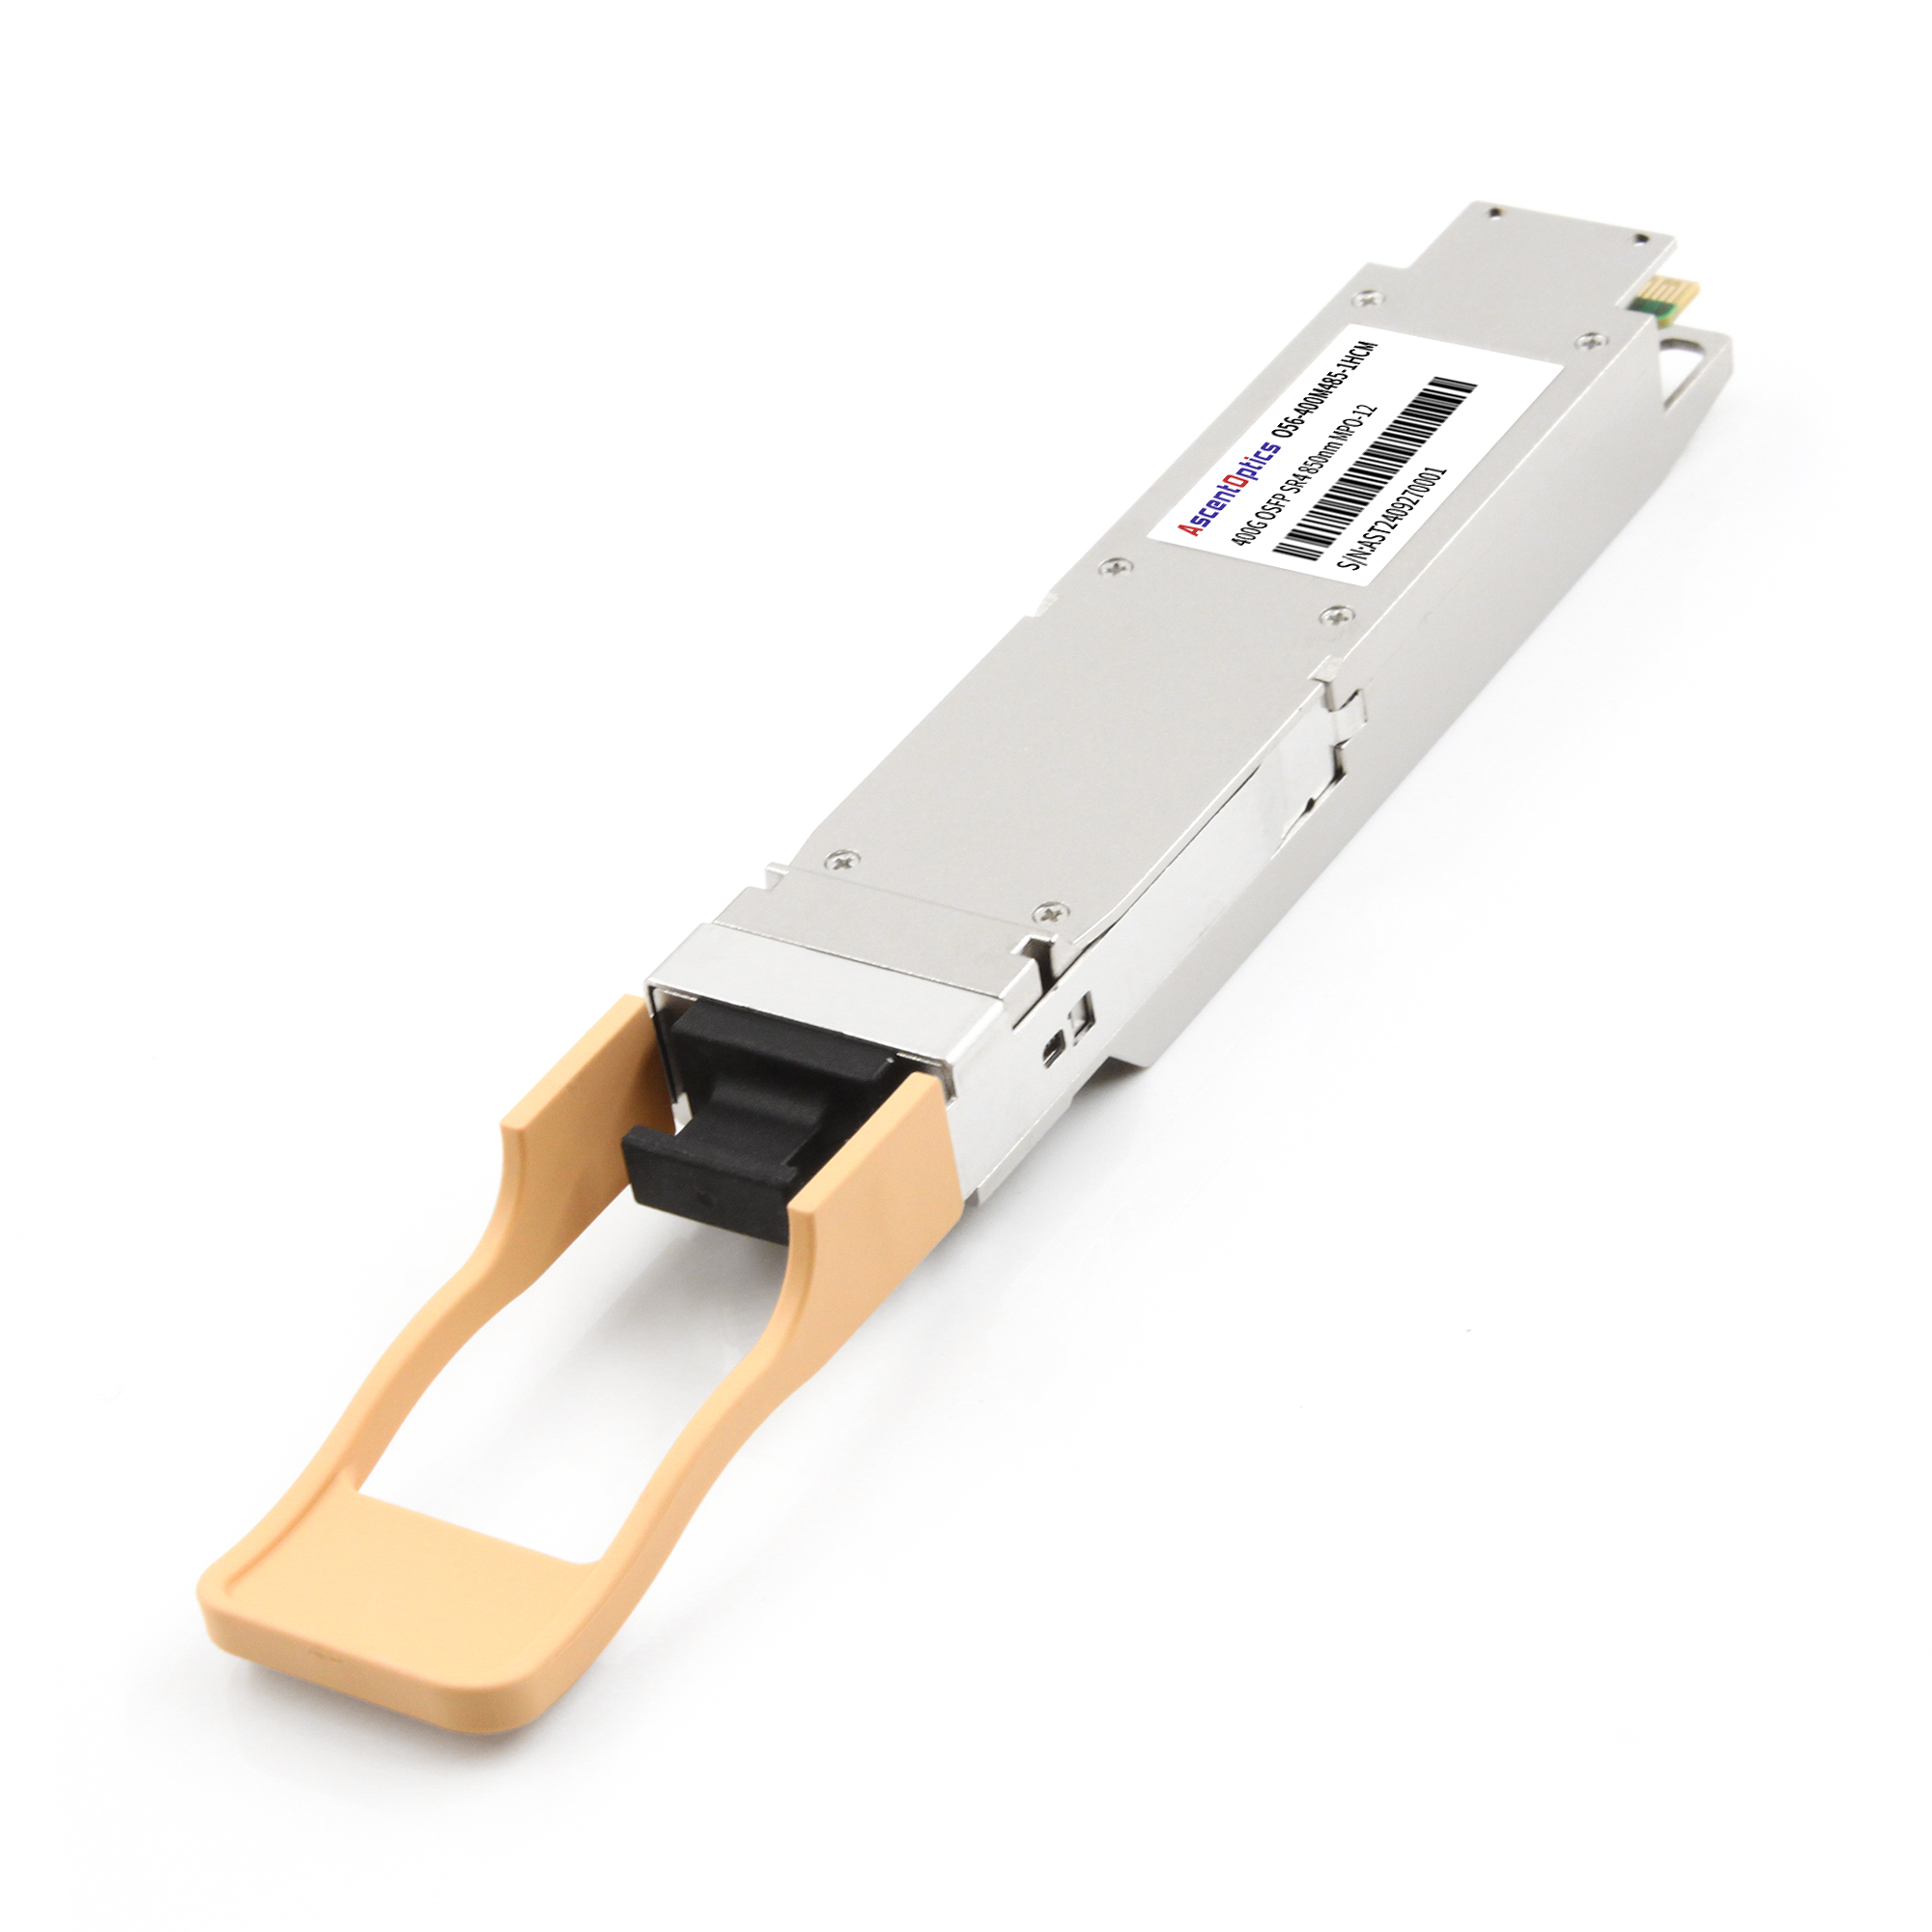
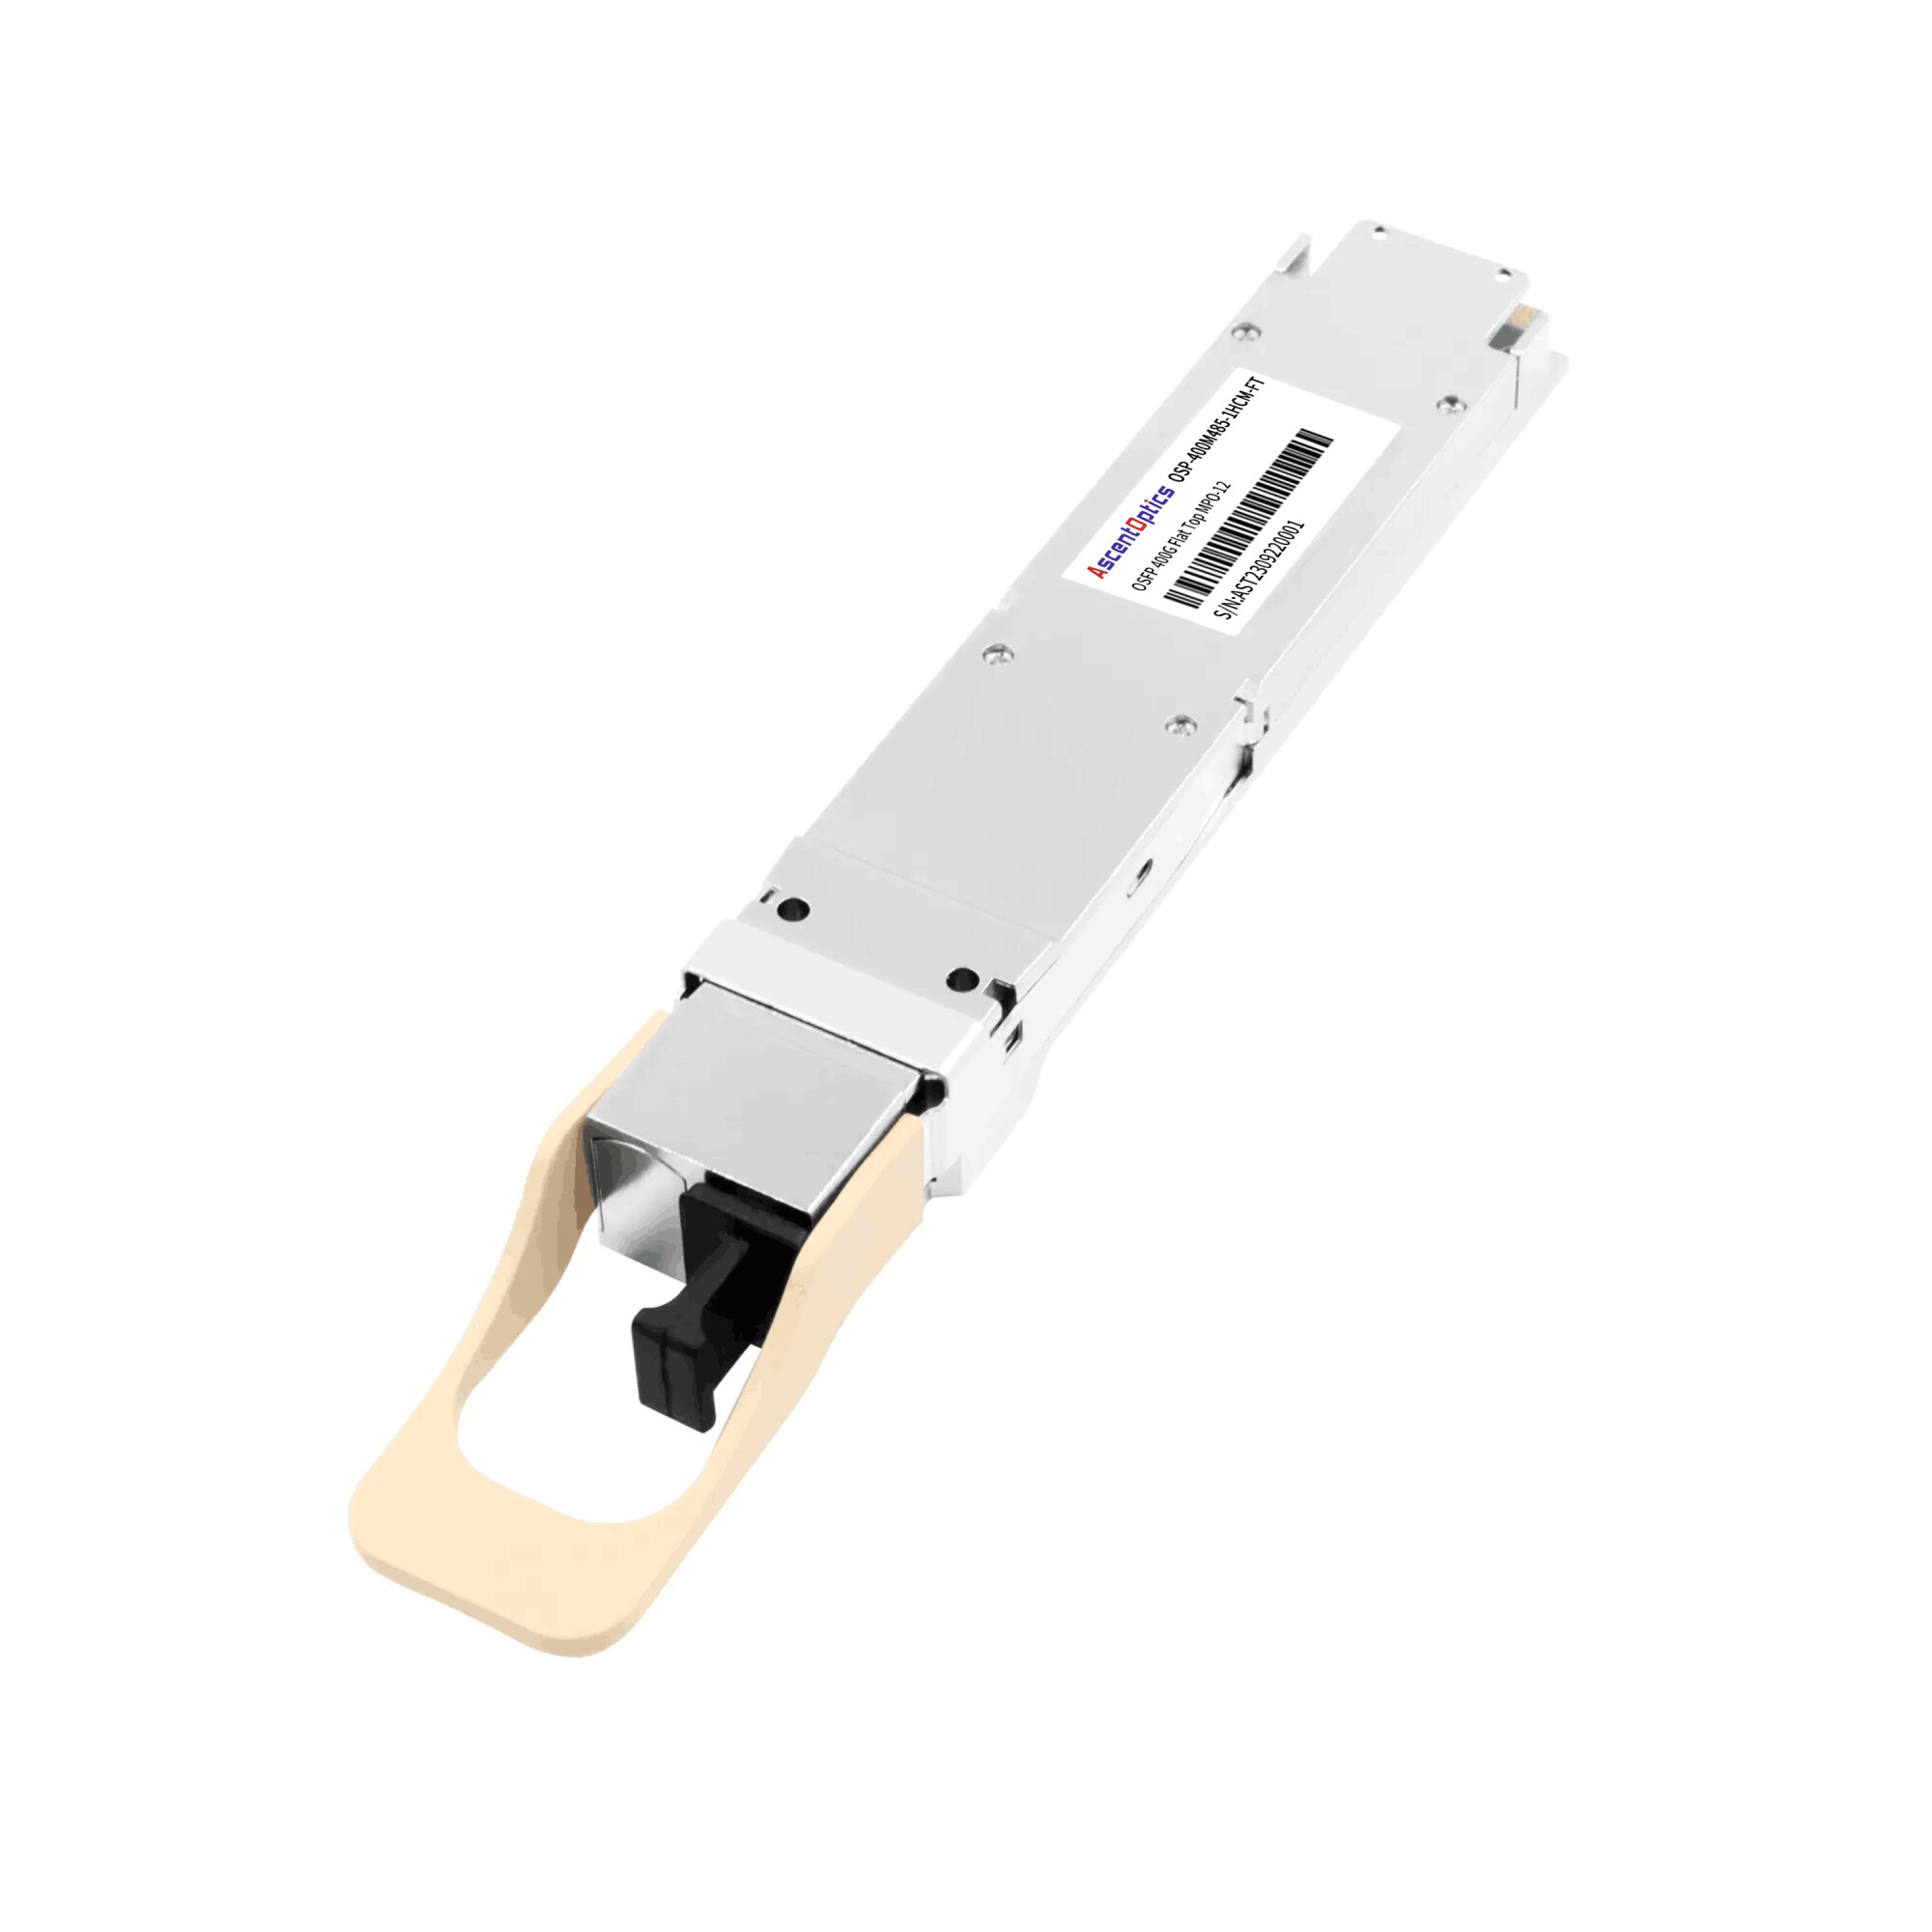
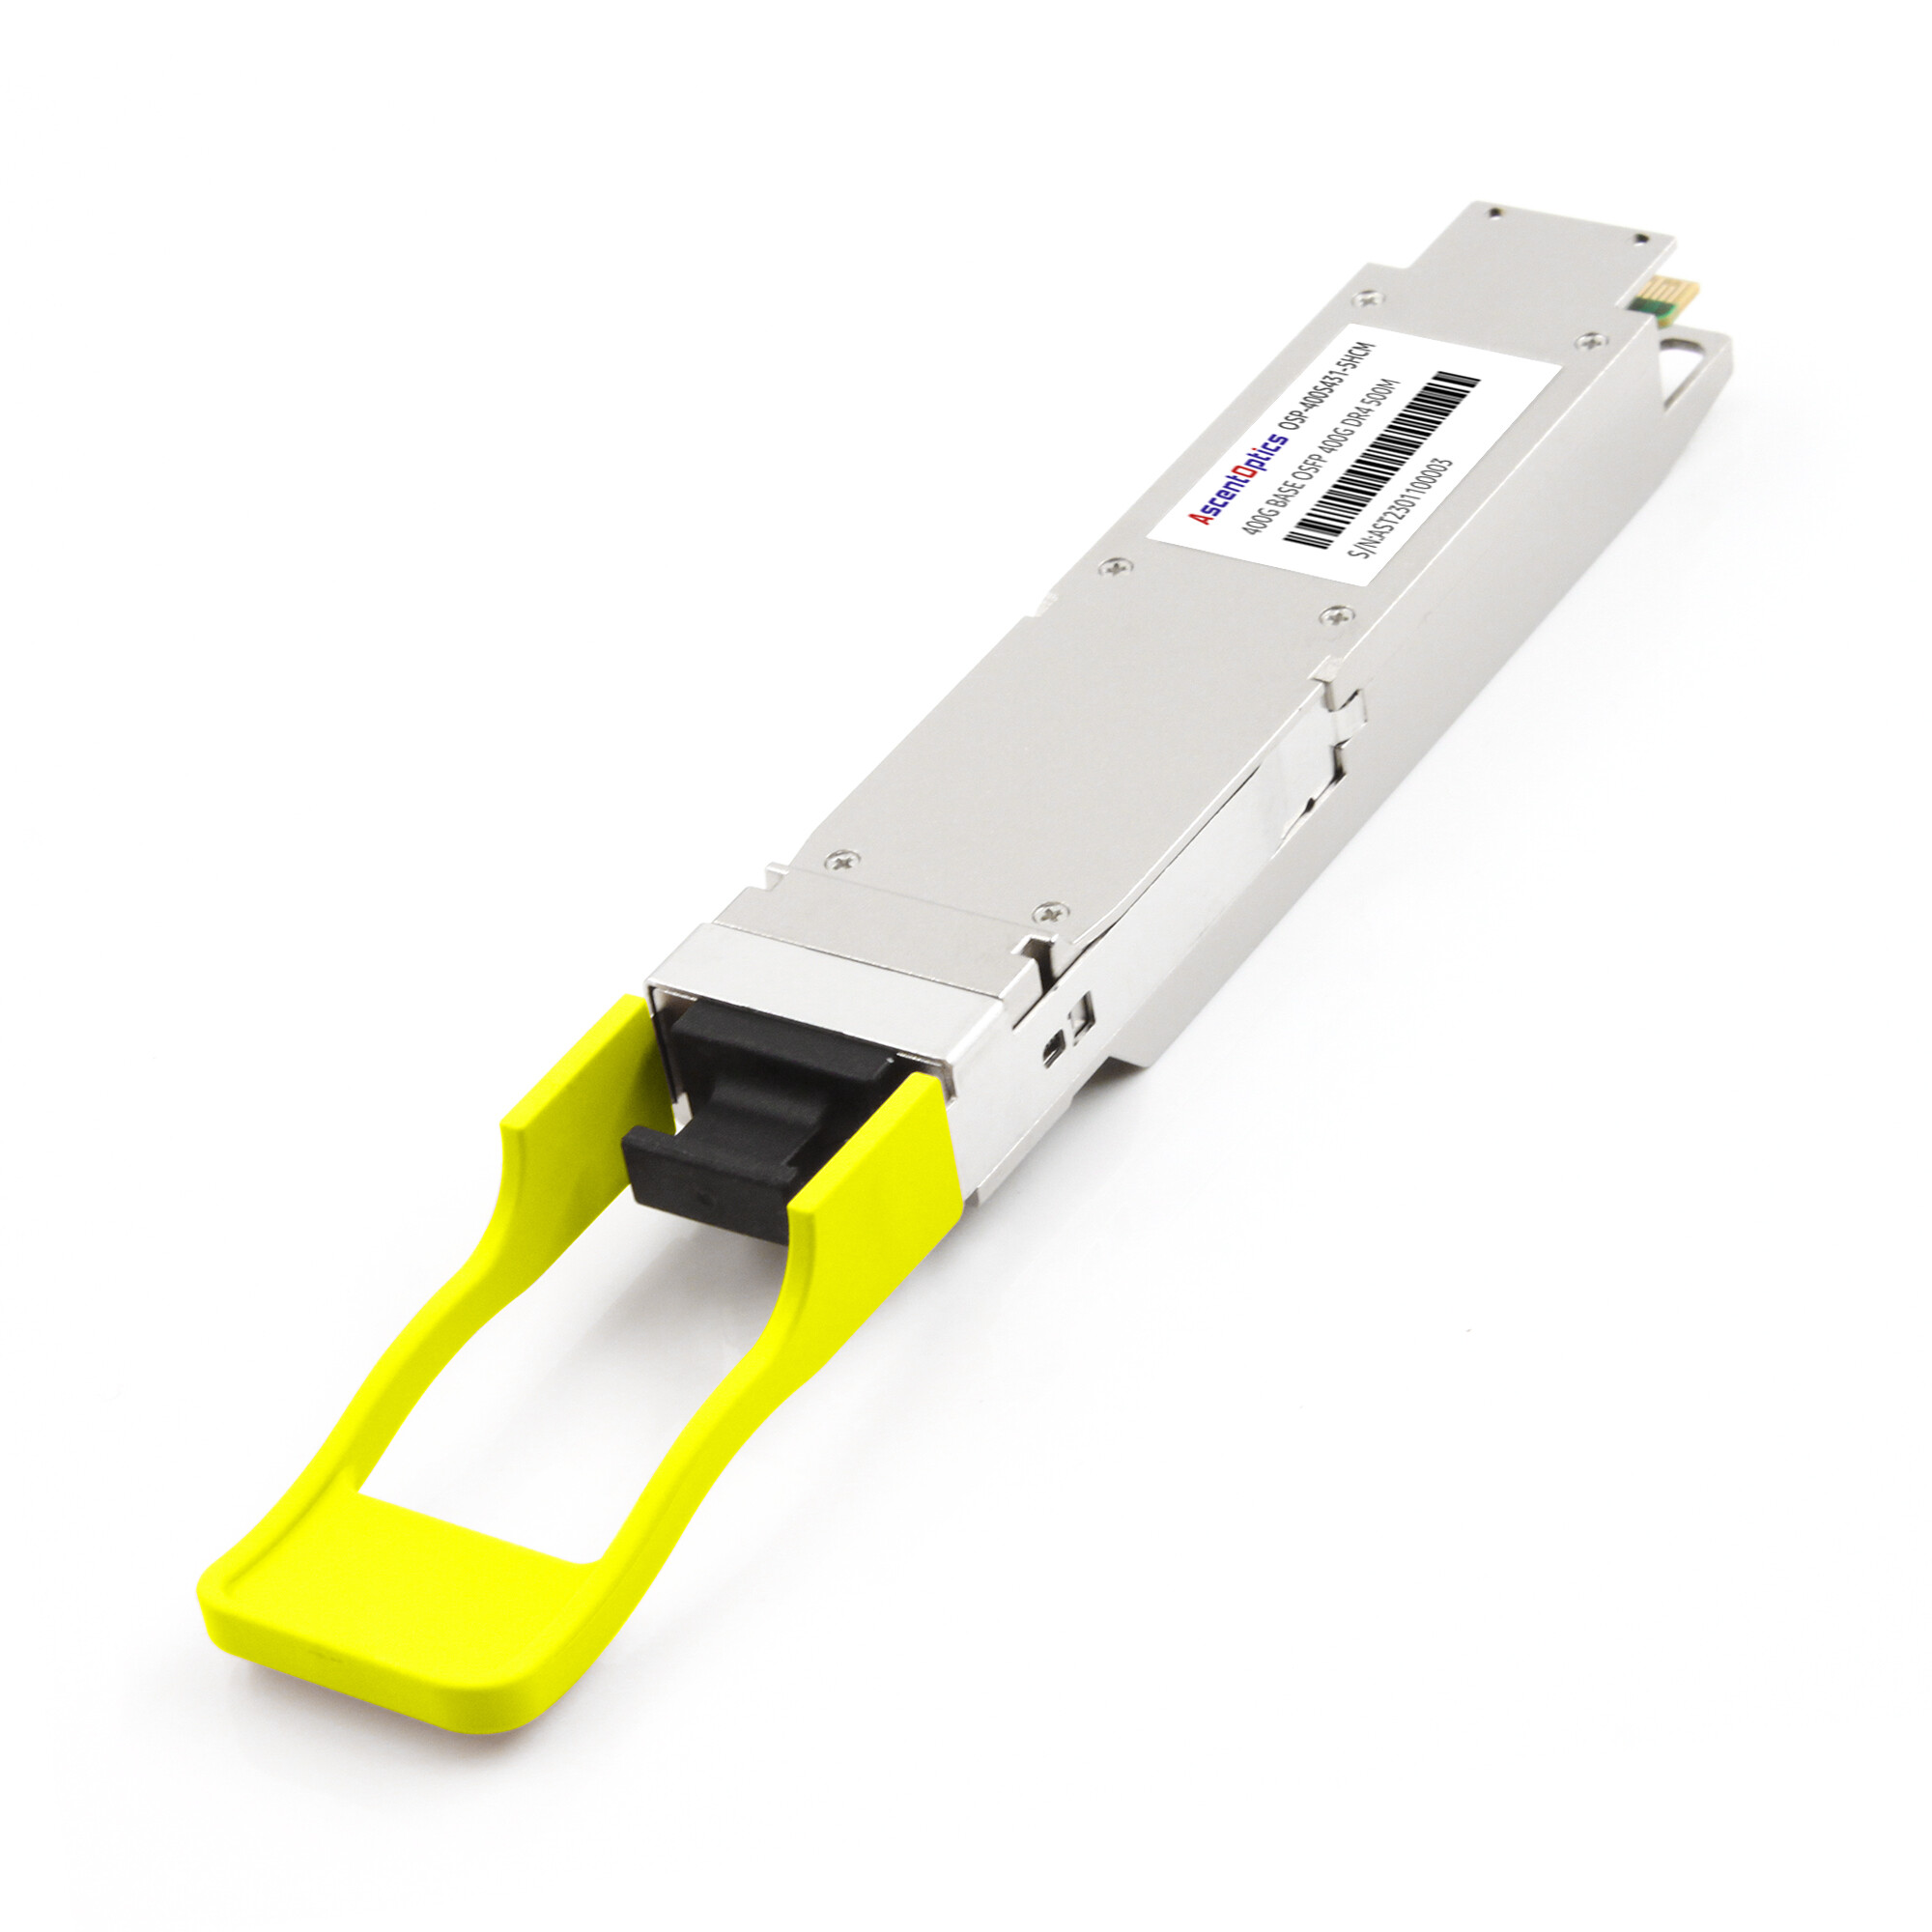
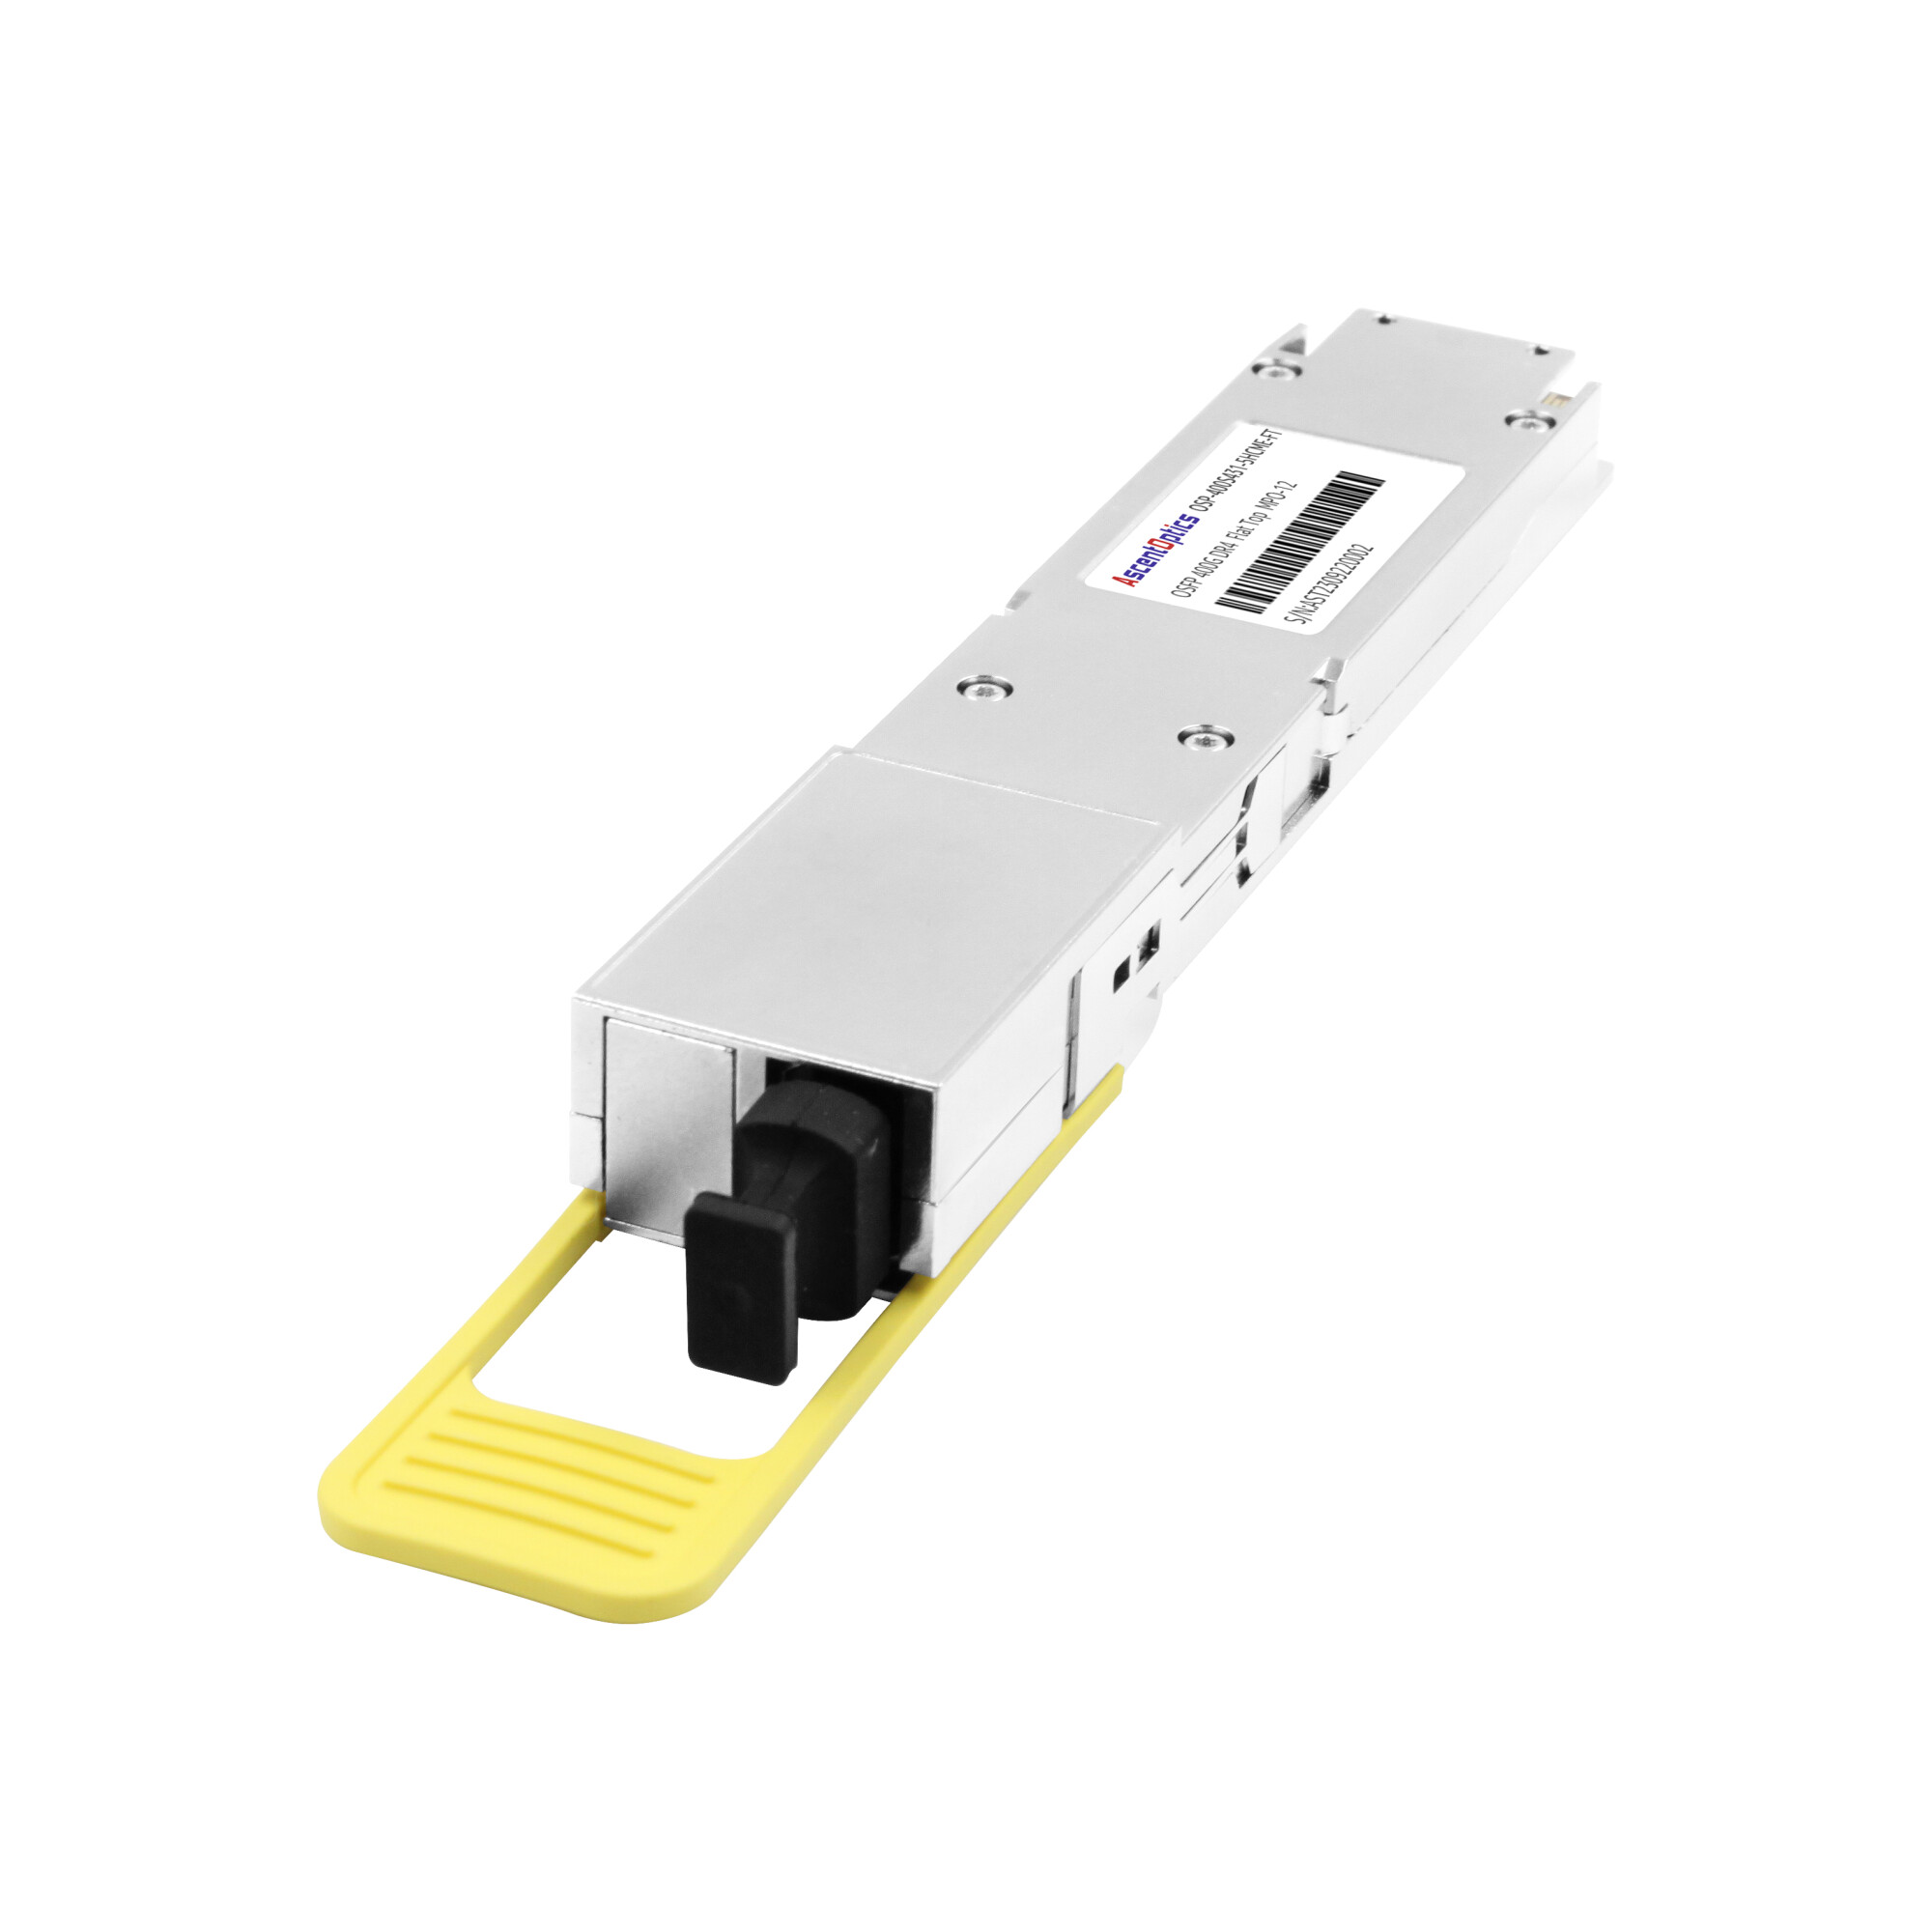
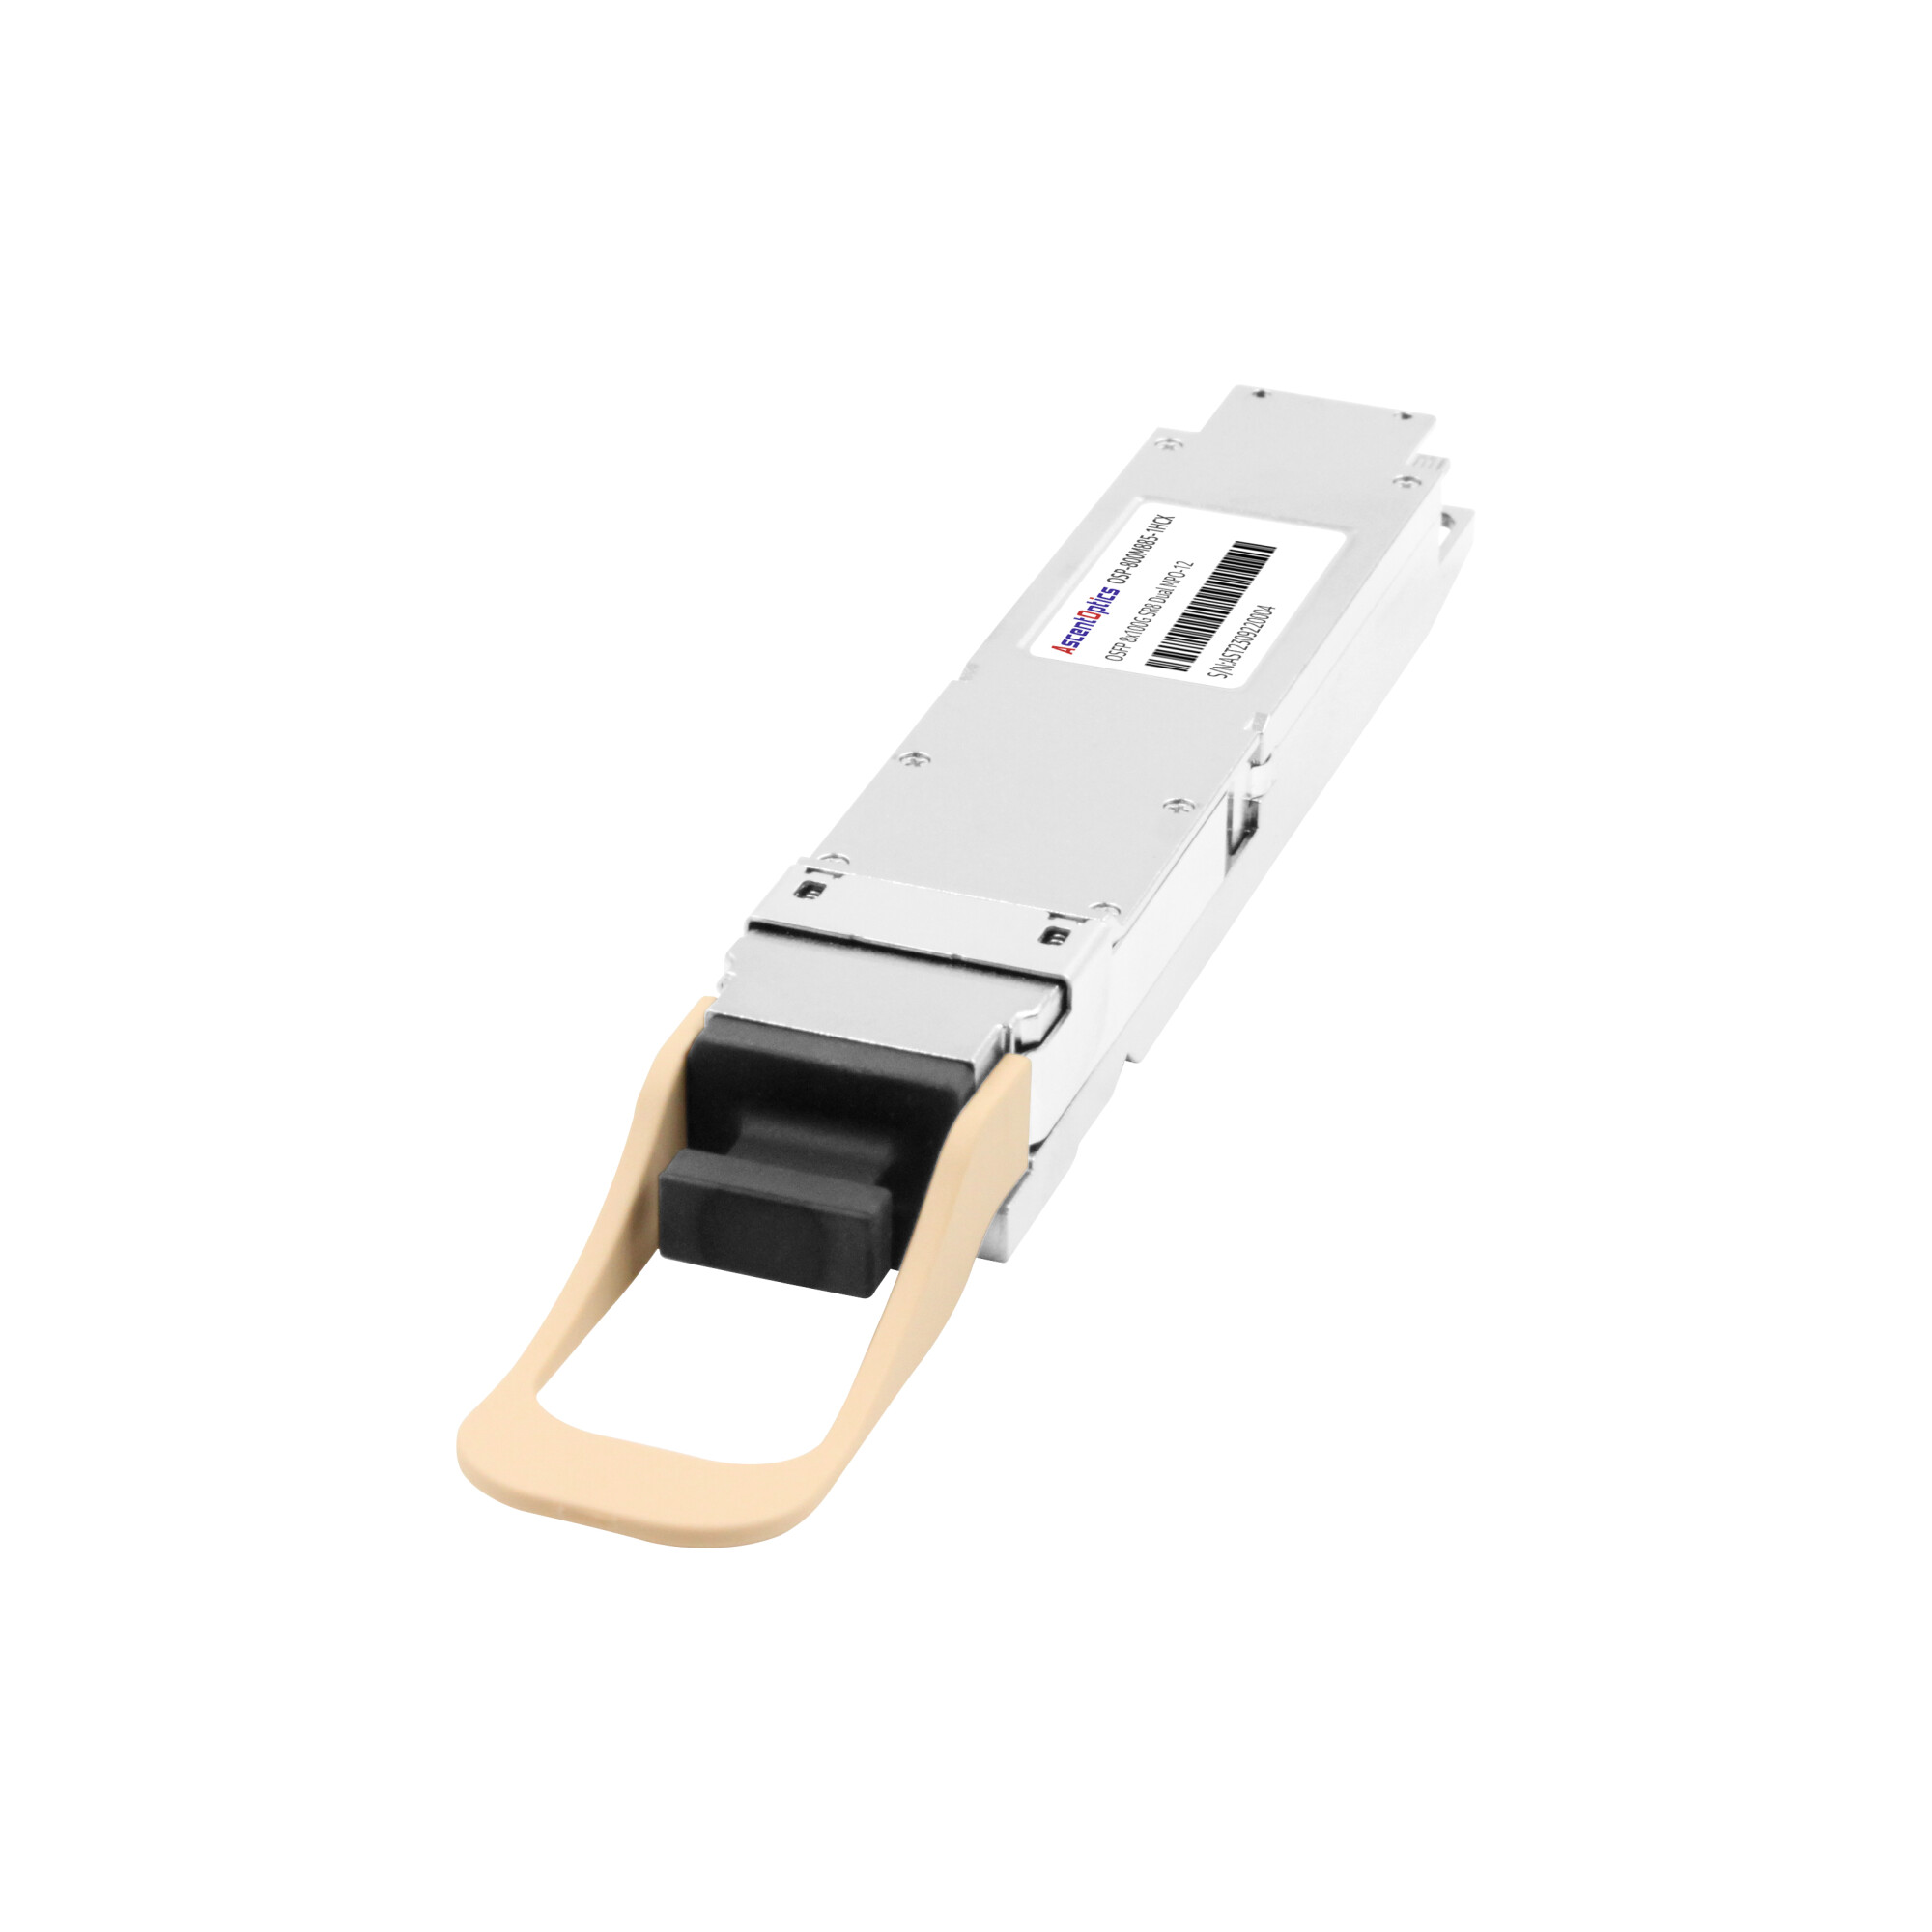
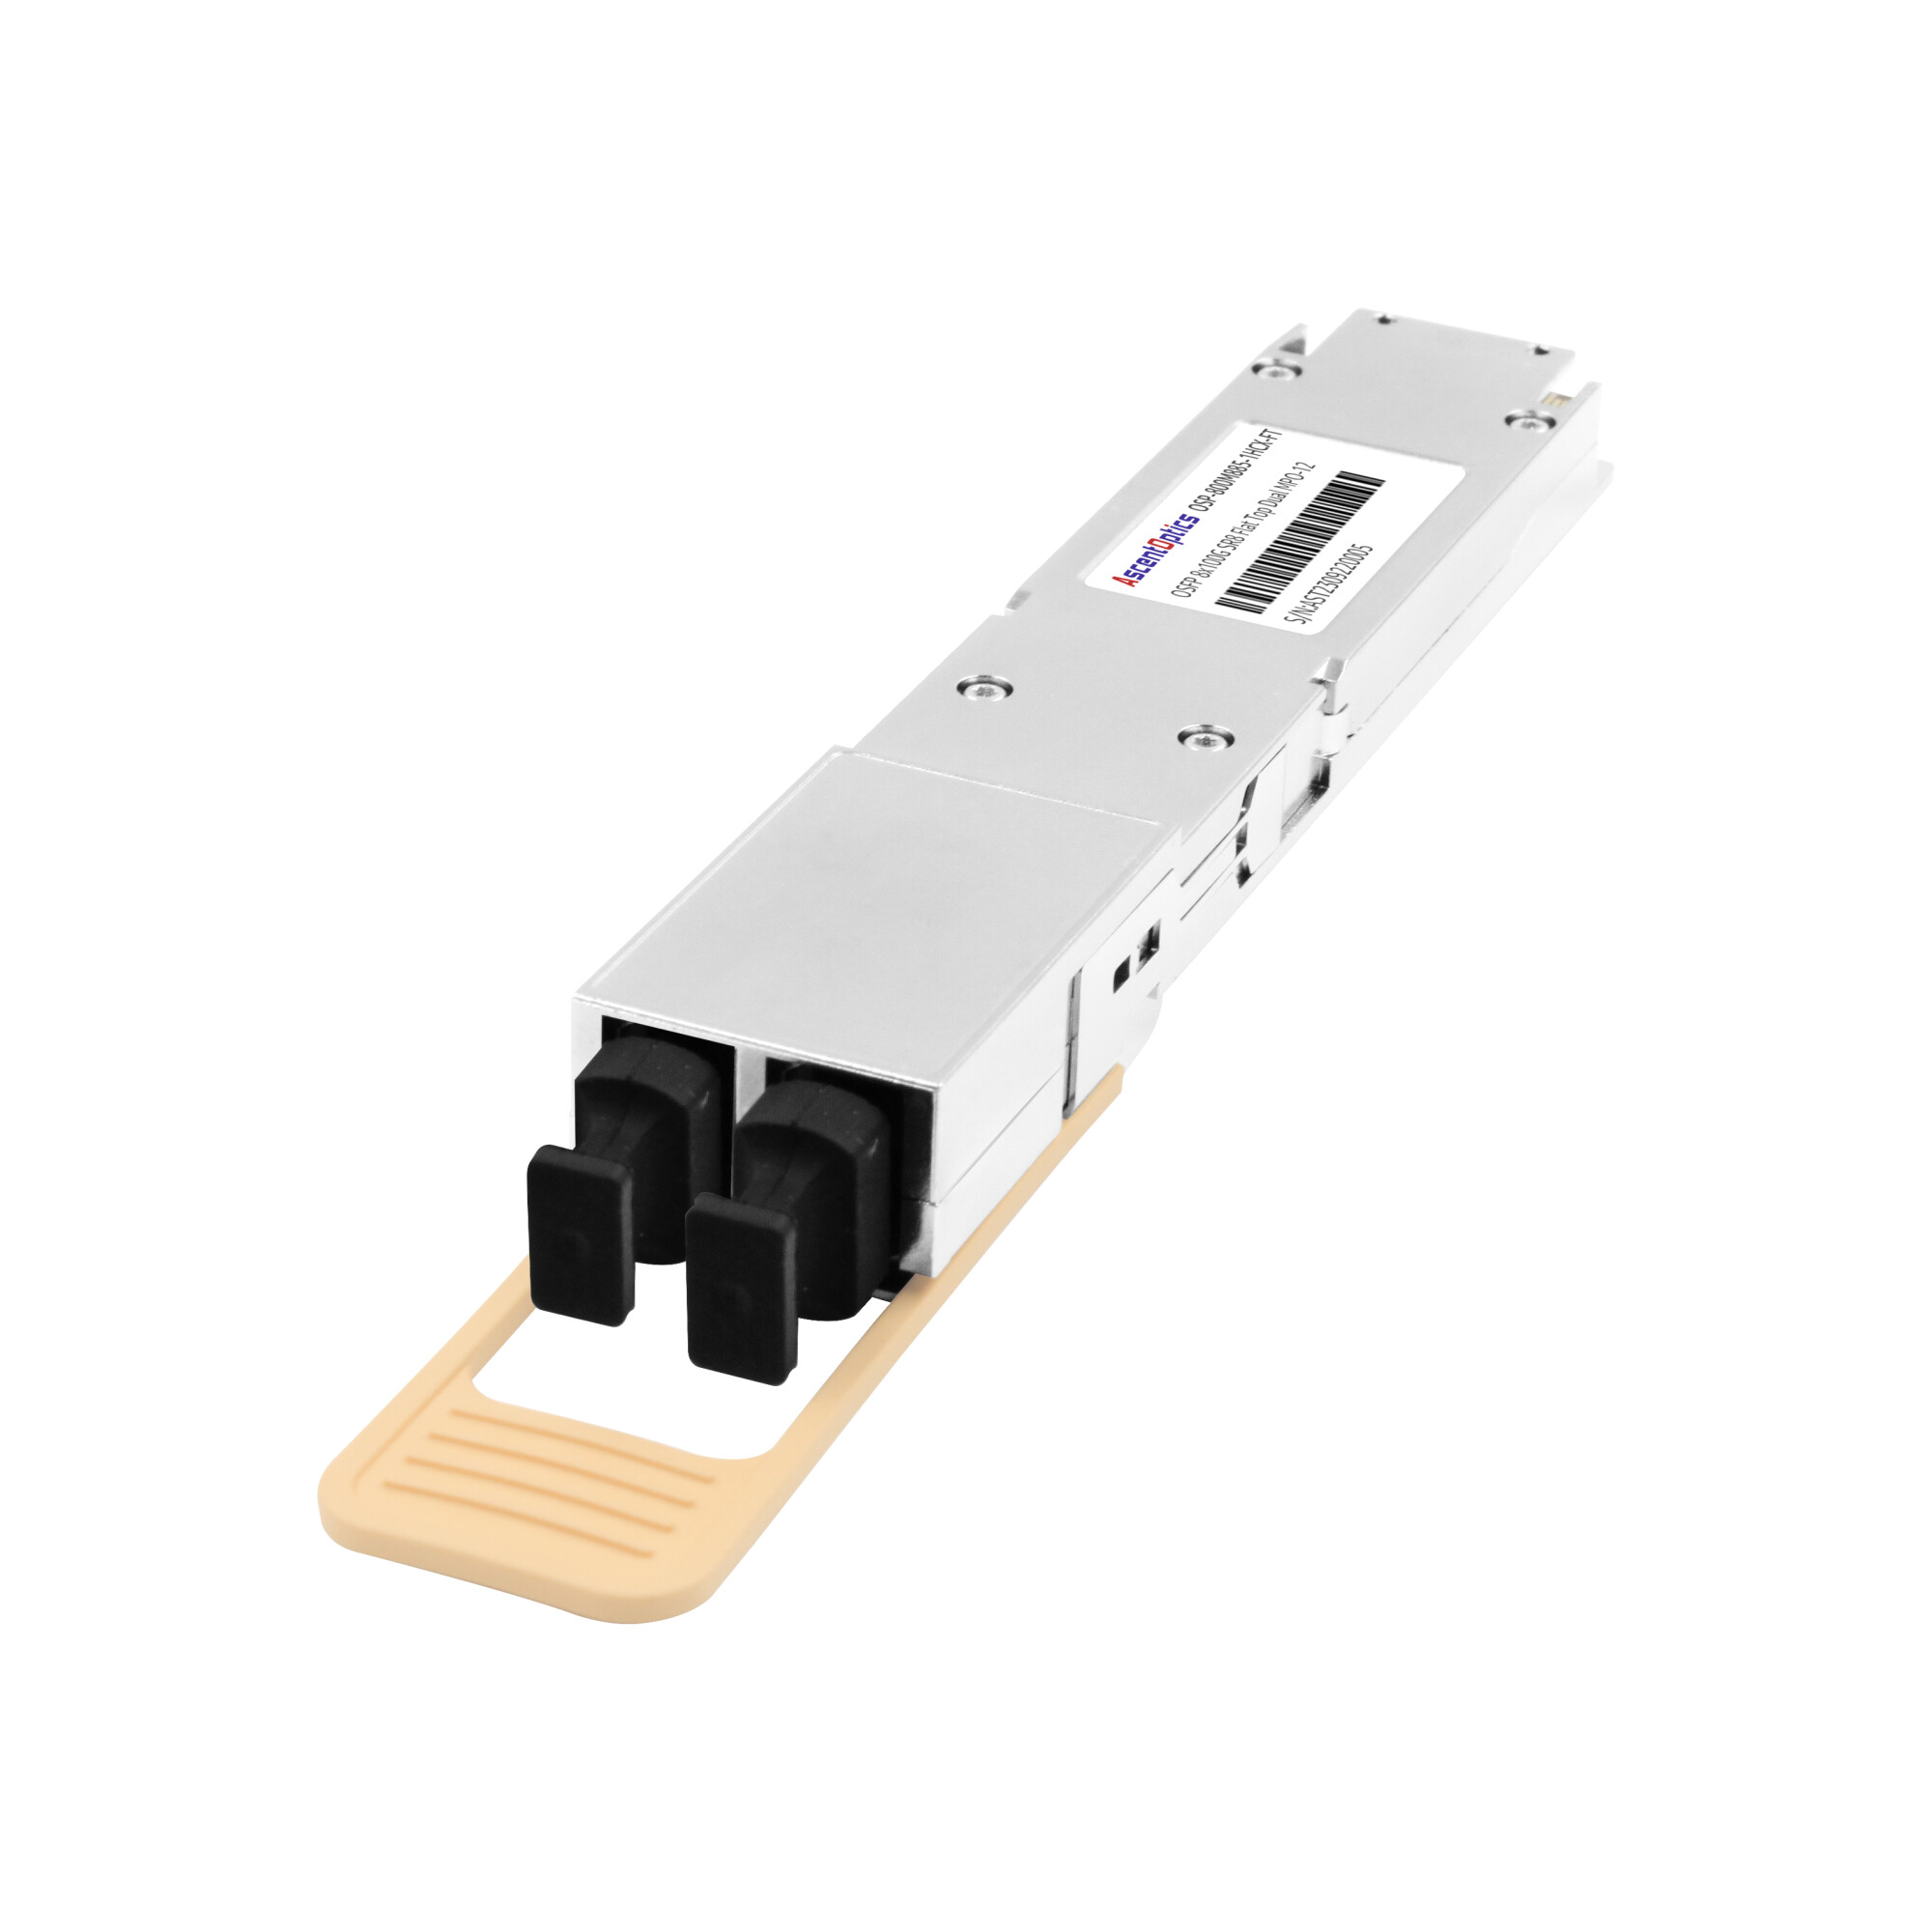
Optik Küçük Form Faktörlü Takılabilir (OSFP), 400G/800G hızlarını destekler ve silikon fotonik (SiPh) veya EML modülatörlerinden yararlanır. Yapay zeka uygulamalarında, OSFP modülleri uzun menzilli iletim (>100 m) için kullanılır ve 4 Tbps'ye kadar çift yönlü bağlantı sağlar. Örneğin, Intel'in OCI yonga setleri düşük güç tüketimi (~5 pJ/bit) elde etmek için DWDM kullanır.
2. DAC (Doğrudan Bağlantı Kablosu)
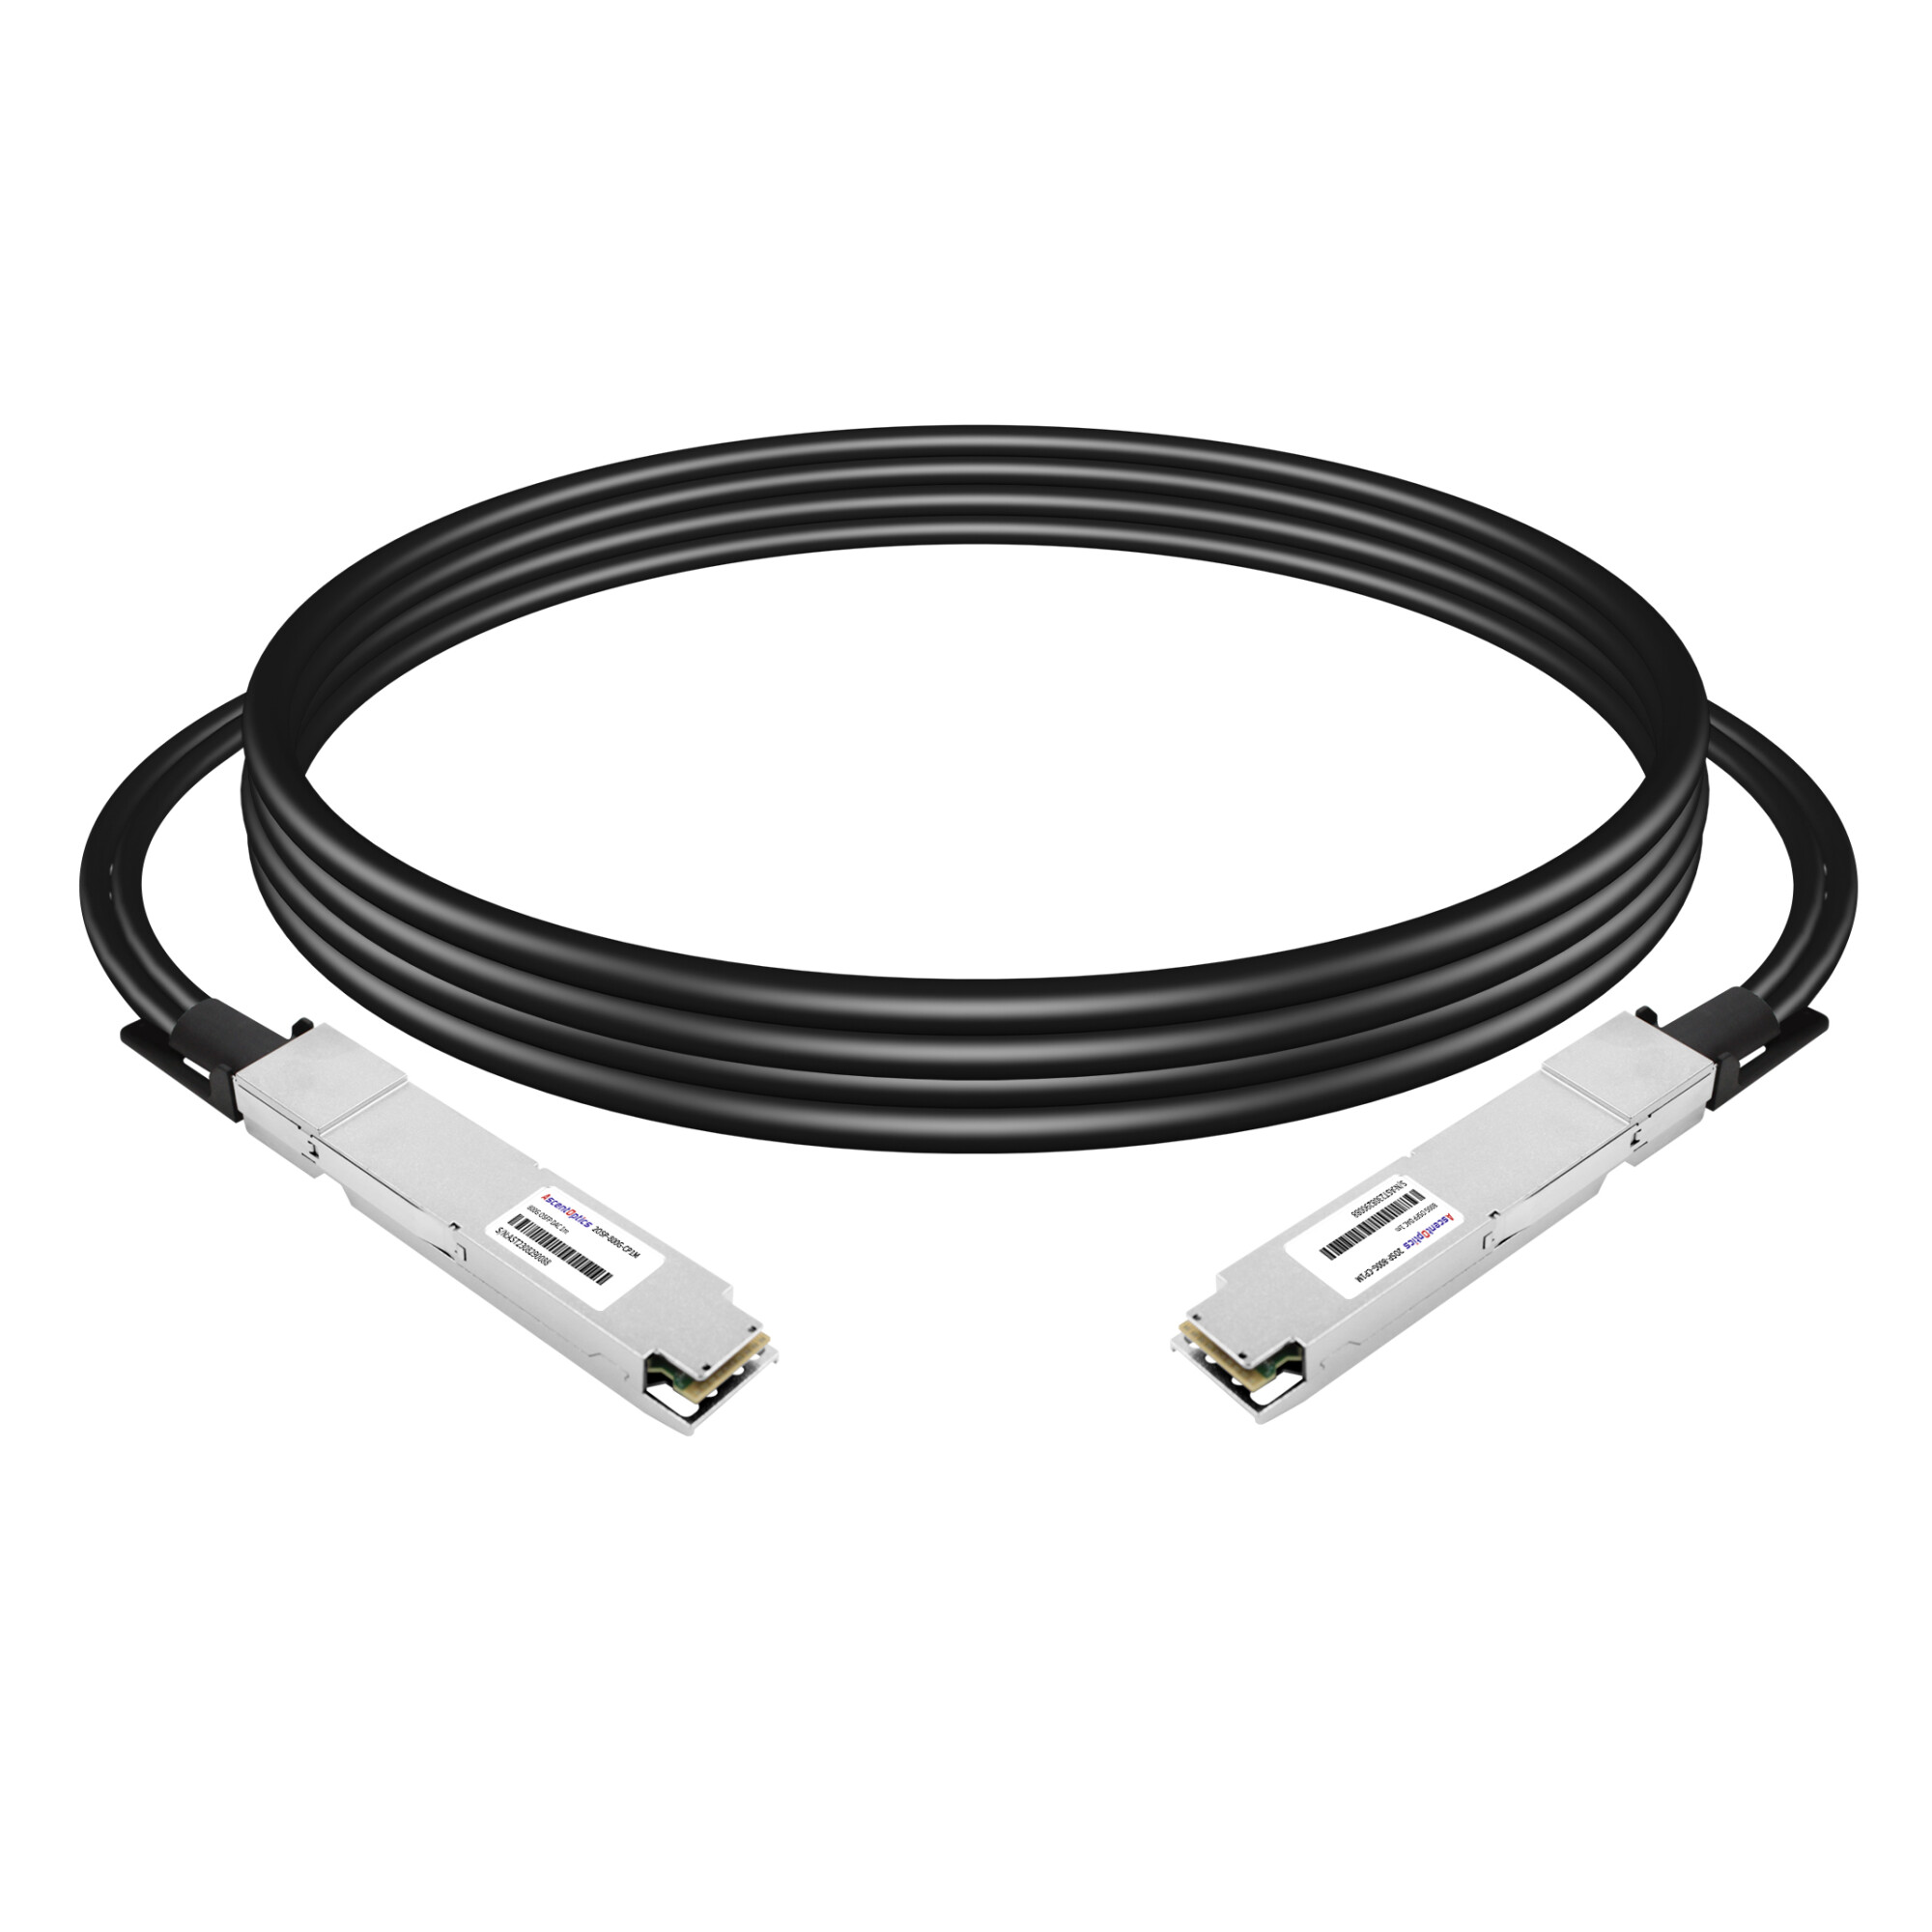
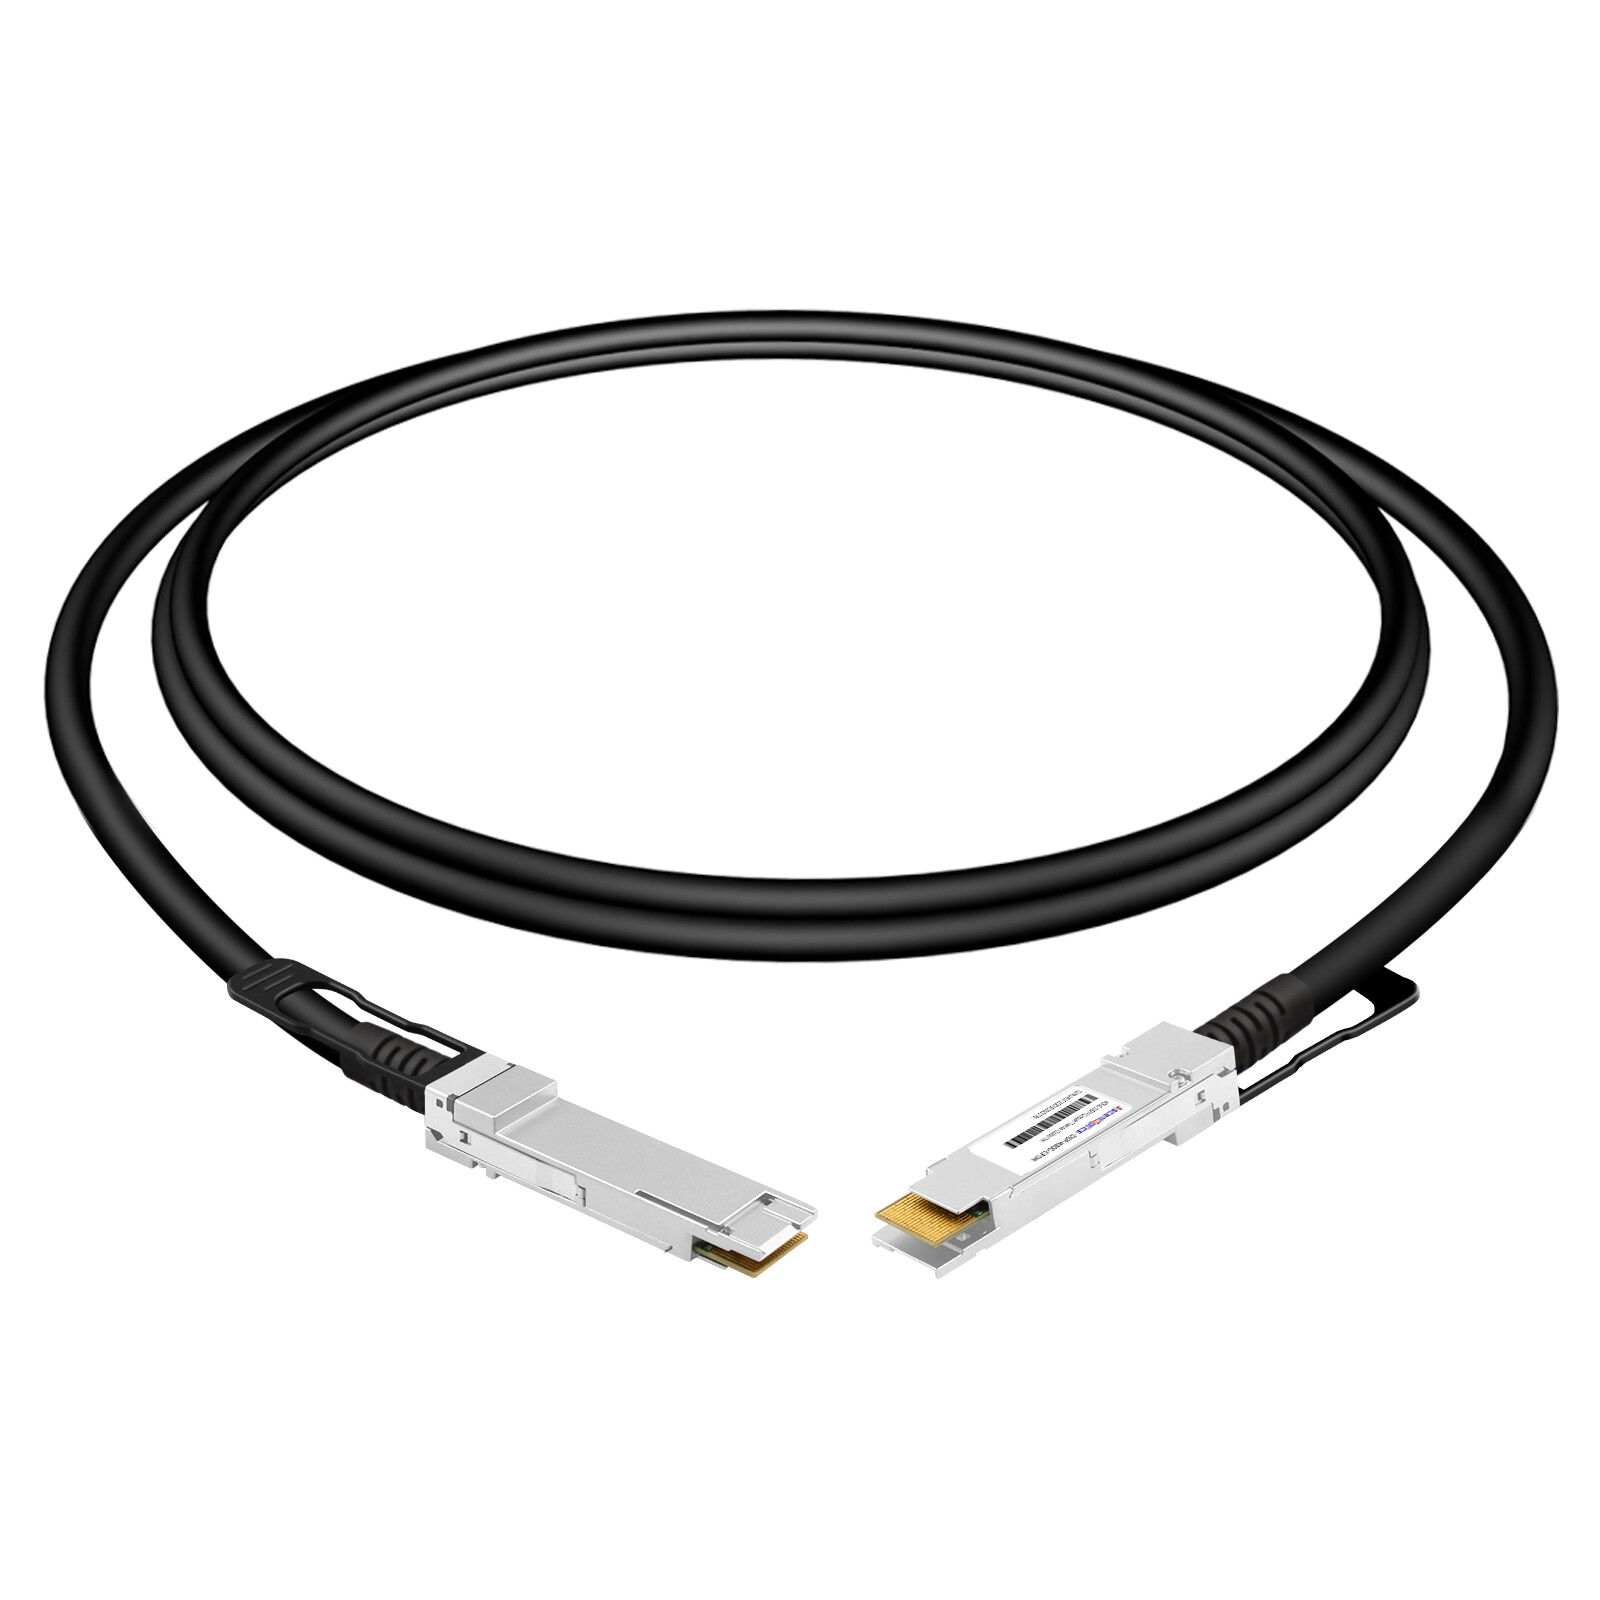
Kısa menzilli (<7 m) raf içi bağlantılar için tasarlanmış bakır tabanlı bir çözüm olan DAC, optik-elektrik dönüşümü gerektirmeden uygun maliyetli bir seçenek sunar. Yapay zeka kümelerinde, AMD Pensando Pollara 400 NIC gibi çözümler, veri aktarımlarını hızlandırmak için RDMA'yı (Uzaktan Doğrudan Bellek Erişimi) desteklerken 400 Gbps bant genişliği sağlamak için DAC'leri kullanır.
3. AOC (Aktif Optik Kablo)
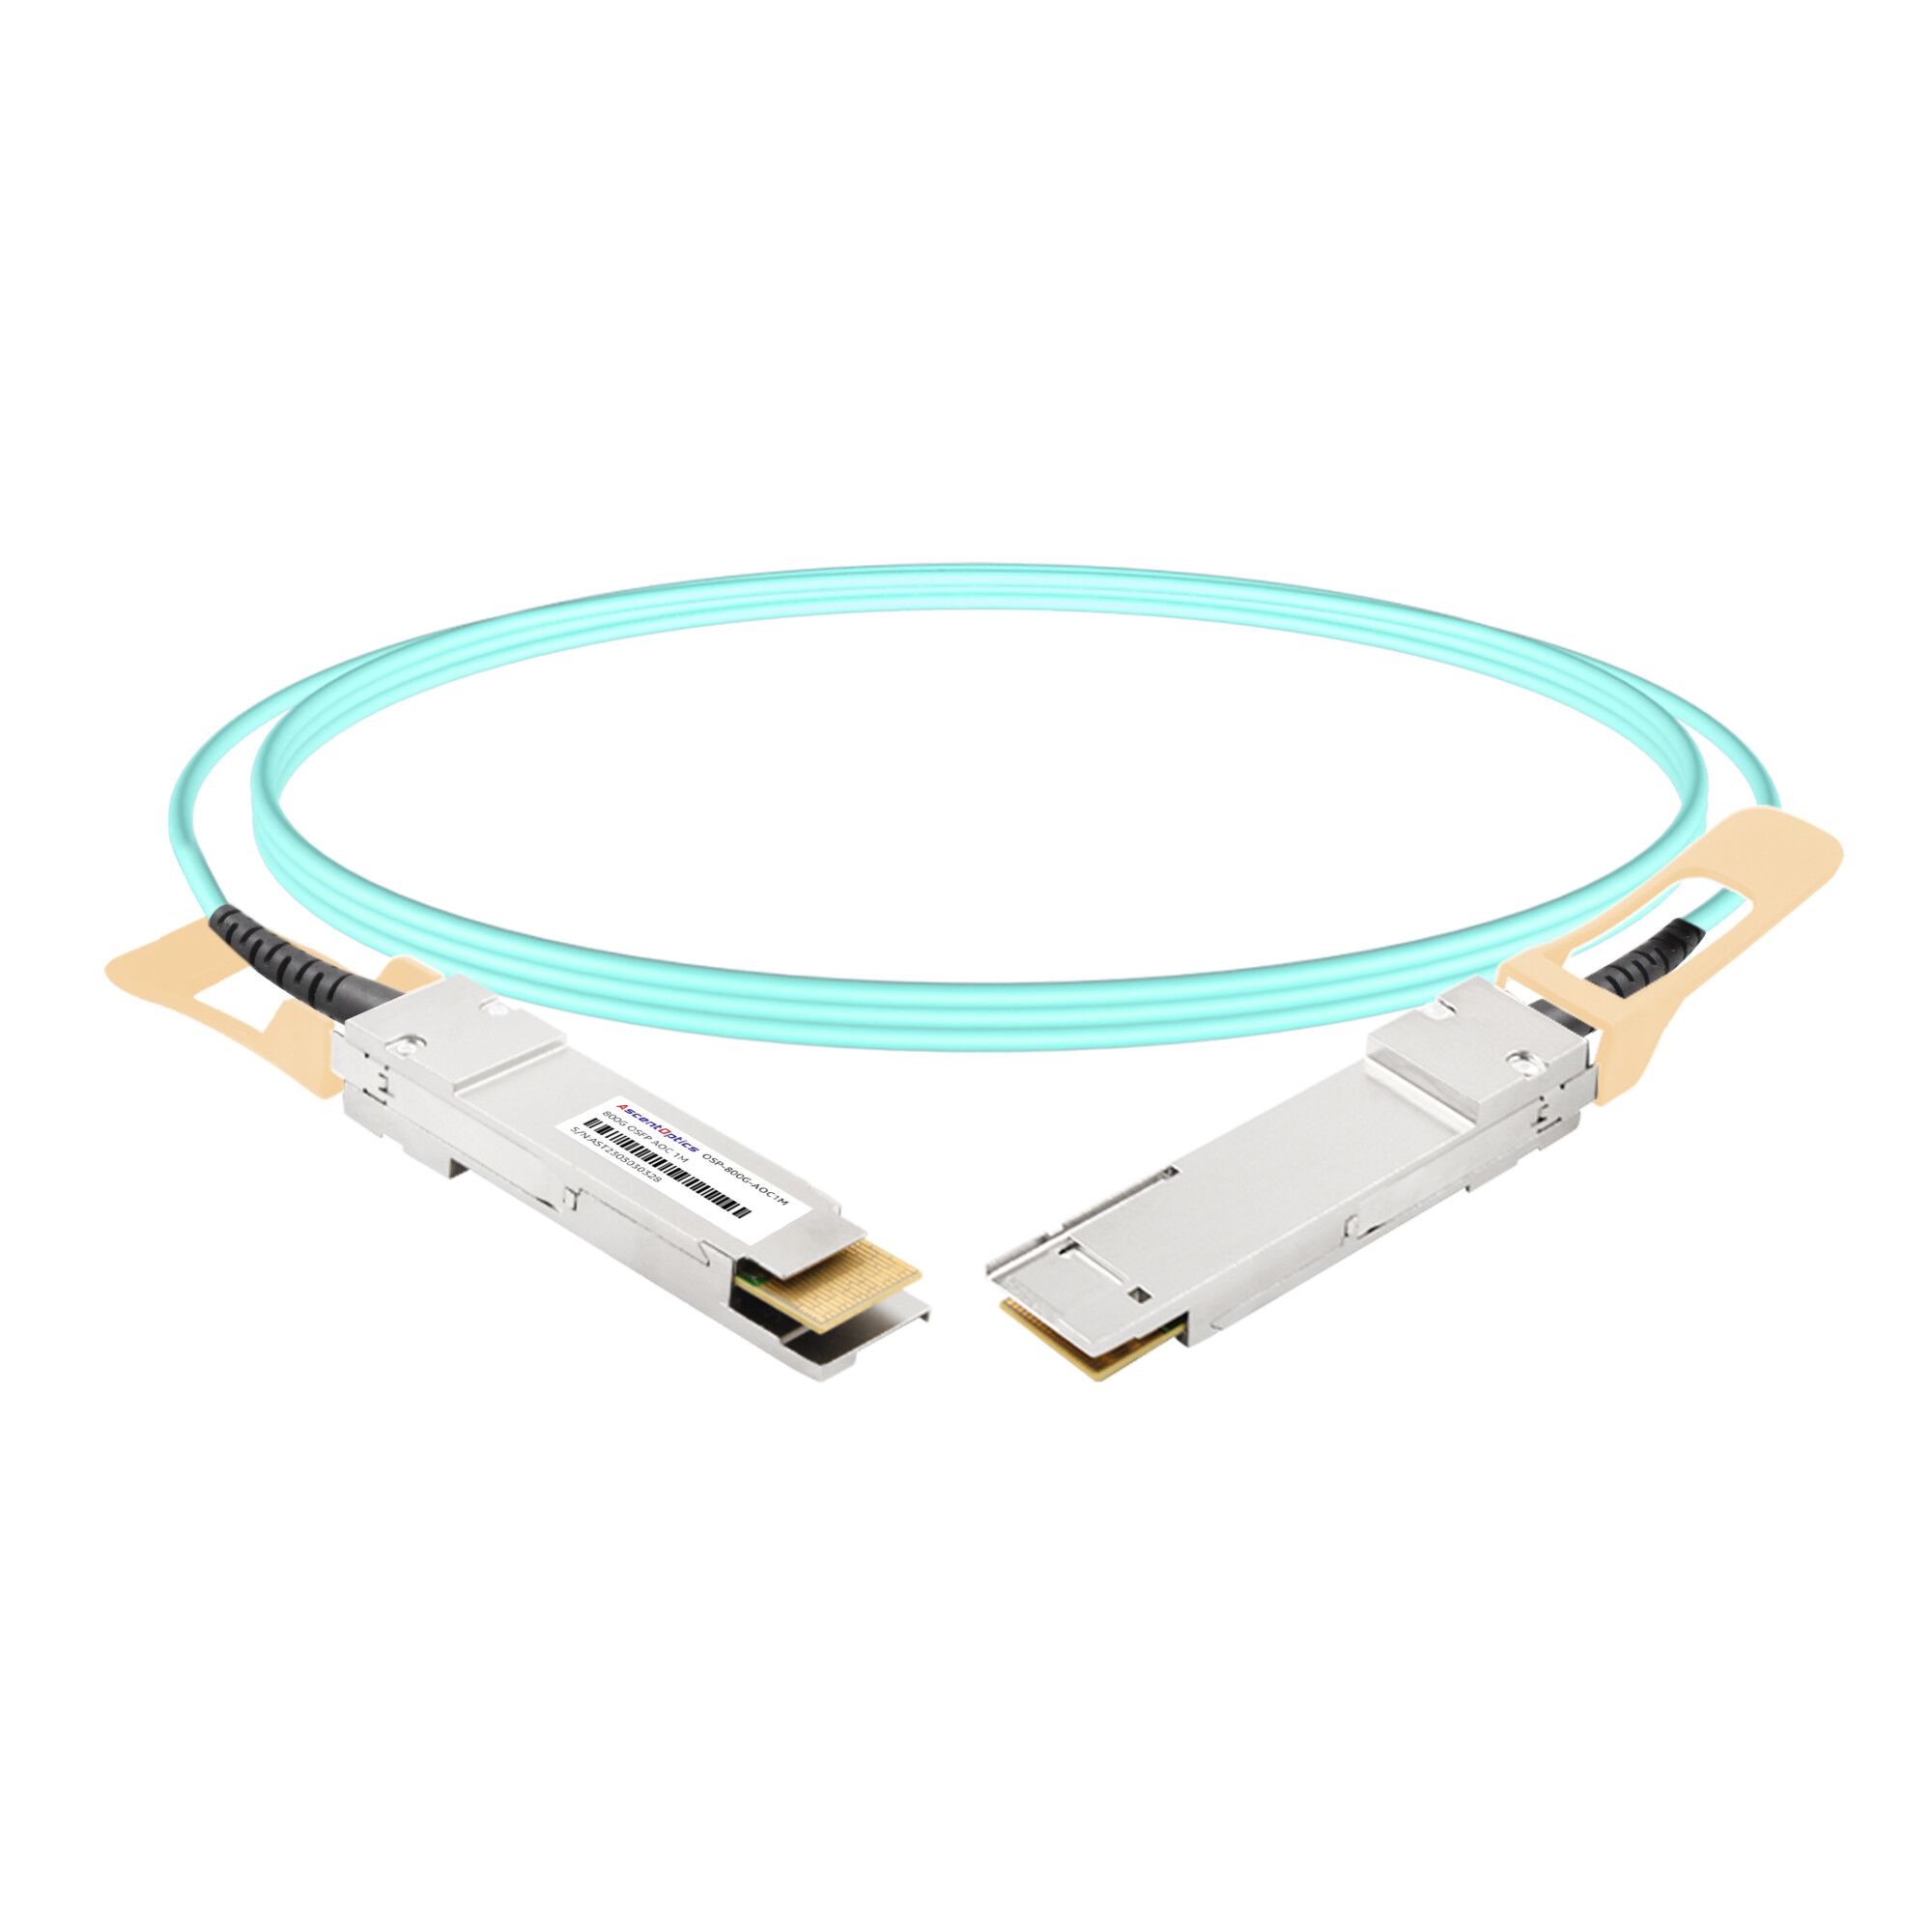
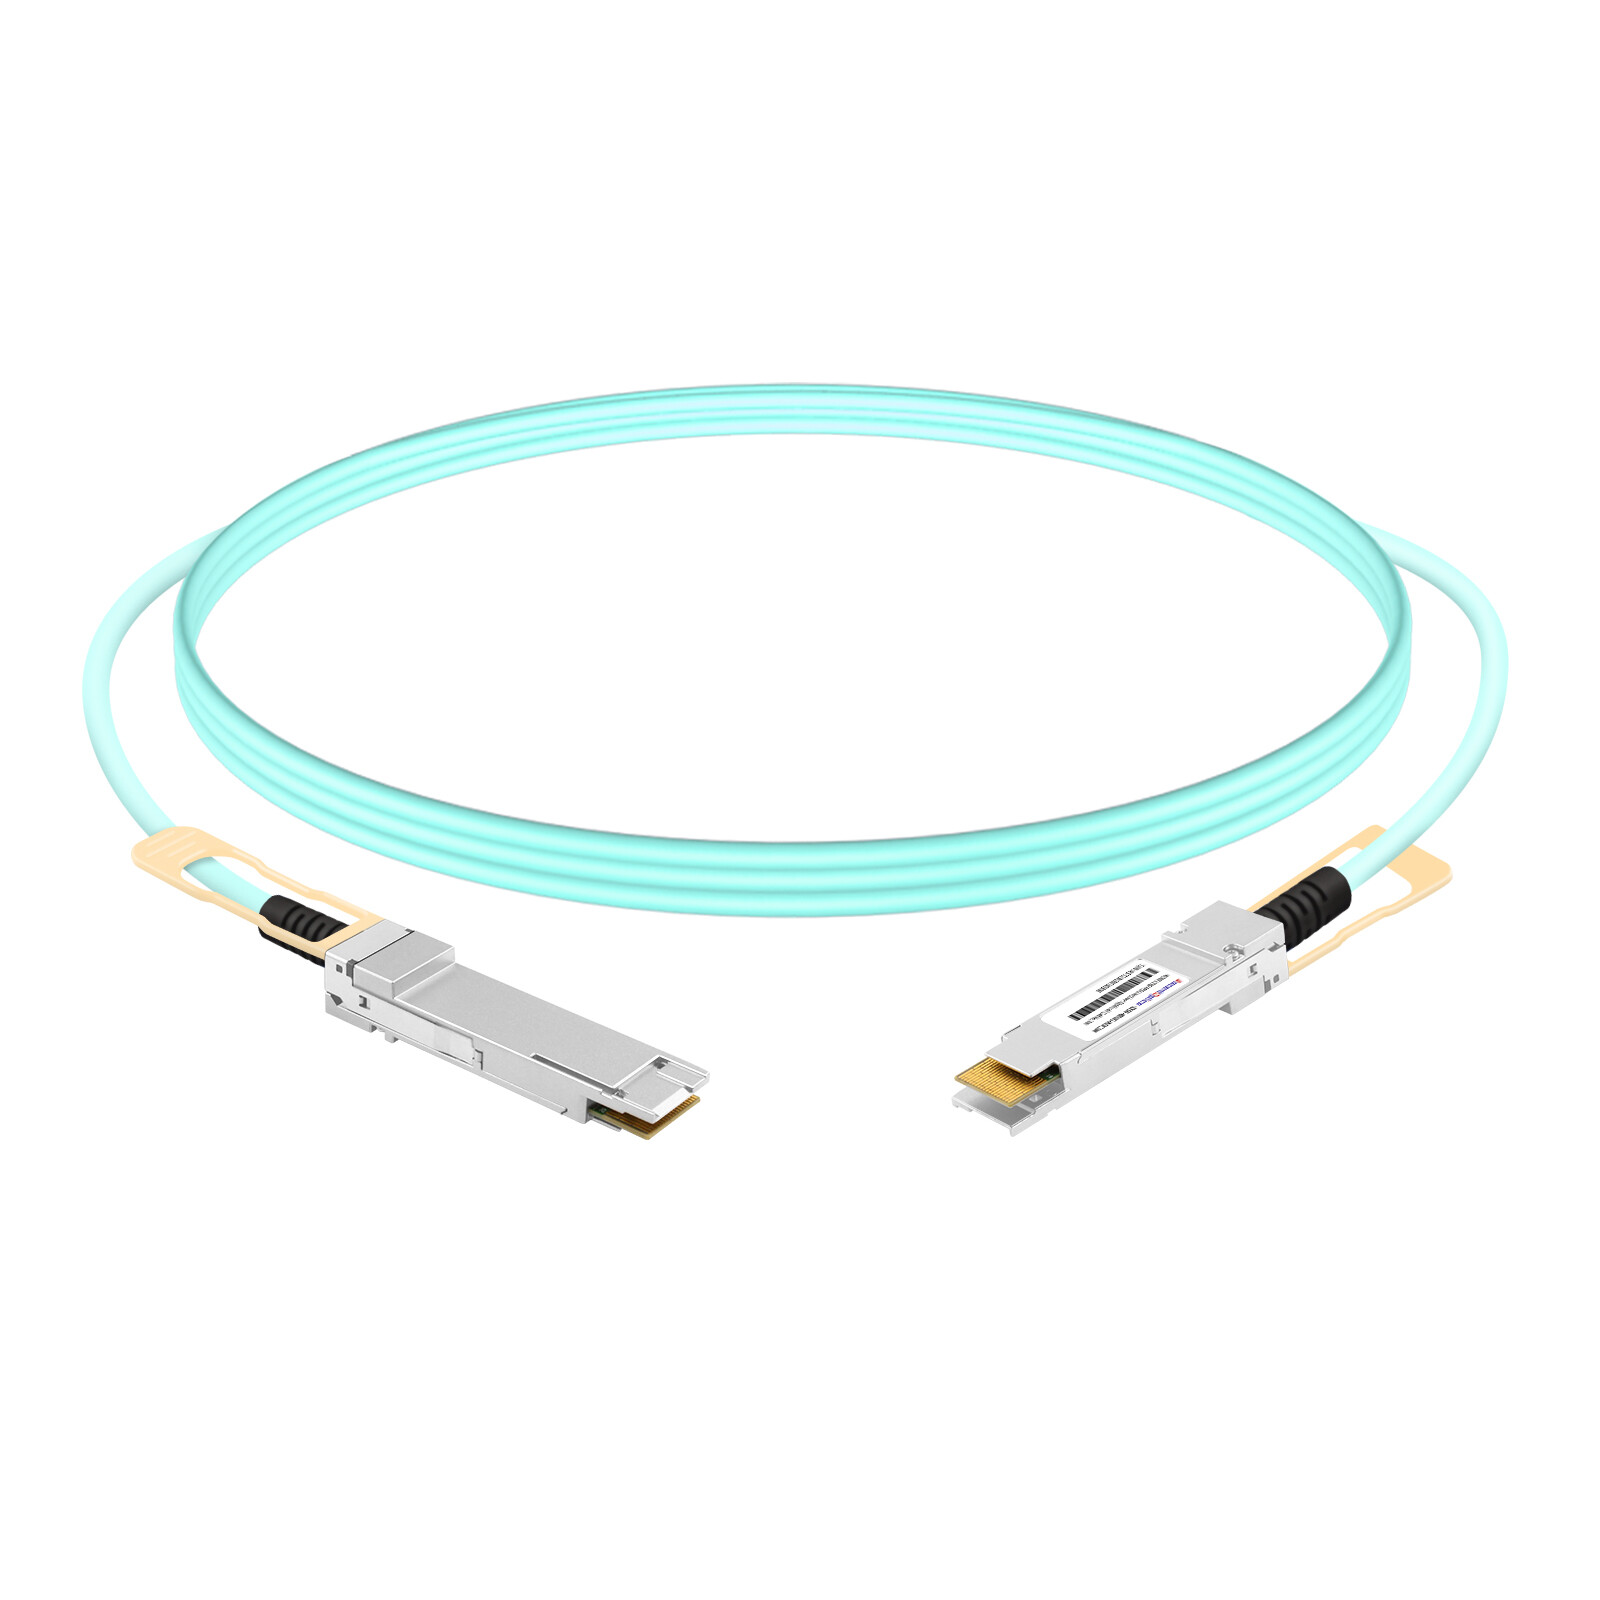
Entegre optik alıcı-vericilere sahip AOC'ler, orta menzilli (7-100 m) bağlantılar için uygundur. Daha yüksek güvenilirlik sağlar ve port kontaminasyonunun önlenmesine yardımcı olur. Yapay zeka ortamlarında AOC'ler, 800G veri merkezi dağıtımlarını destekleyen paralel kablolama için yaygın olarak kullanılır.
Pratik uygulamalarda bu teknolojiler doğrudan yapay zeka performansını artırır:
Eğitim aşaması: Örneğin, Llama 3'ün dağıtılmış eğitiminde, GPU'lar arasında düşük gecikmeli iletişimi sağlamak ve kullanım verimliliğini artırmak için 400G SR4 modülleri kullanılmaktadır.
Çıkarım aşaması: Gemini 2.5'in gerçek zamanlı işleme yeteneği, 3200 Gbps veri aktarımını sağlamak için 800G AOC'ye dayanmaktadır.
Örnek olay incelemesi: OpenAI'nin Stargate kümesi, her GPU'da 8 adet OSFP portu bulunan özel 800 GbE ağ kartları kullanıyor ve bu da ağ performansında 2 kat artış sağlıyor. AMD'nin Vulcano ağ kartı 800 Gbps verim sağlıyor ve UC 1.0 standardını destekliyor.
Açık kaynak ve ölçeklenebilirlik: Örneğin, DeepSeek V3, bağlantıları optimize etmek ve köprüleme maliyetlerini düşürmek için RDMA'yı kullanır.
Pratik uygulamalarda, bu ara bağlantı teknolojileri genellikle birlikte kullanılır: DAC ve AOC, bitişik raflar içinde veya arasında kısa mesafeli bağlantılar için en uygunudur ve düşük maliyet, düşük gecikme süresi ve ölçeklenebilir basitleştirilmiş kablolama sunar. OSFP optik modülleri ise, öncelikle raflar arası veya hatta veri salonları arası bağlantılar için kullanılır ve daha uzun mesafelerde daha yüksek bant genişliği, kararlılık ve ölçeklenebilirlik sunar. Bu katmanlı yaklaşım, veri merkezlerinin maliyet, güç tüketimi ve performansı dengelemesine olanak tanıyarak büyük ölçekli yapay zeka kümelerinin eğitim ve çıkarım taleplerini destekler.
Özetle, yüksek hızlı ara bağlantı teknolojilerinin gelişmiş yapay zeka modelleriyle entegrasyonu, veri merkezi inovasyonunun yeni dönemini şekillendiriyor. En yeni yapay zeka modellerinin 400G/800G ara bağlantılarıyla birleştirilmesi, yalnızca teknolojik sinerjiyi göstermekle kalmıyor, aynı zamanda altyapının yapay zeka ekosistemindeki kritik rolünü de vurguluyor. Ara bağlantı teknolojisi, yapay zekanın yalnızca bir destekleyicisi değil, aynı zamanda gelecekteki gelişiminin de temel taşıdır.