Nel 2025, il rapido sviluppo dell'intelligenza artificiale (IA) sta rimodellando le architetture dei data center. Dai modelli linguistici multimodali di grandi dimensioni ai framework aperti ed efficienti, l'IA è diventata la principale forza trainante dell'innovazione. La scala dei modelli di IA si sta espandendo da centinaia di milioni di parametri a livelli di trilioni, con l'addestramento che coinvolge migliaia o addirittura decine di migliaia di GPU in parallelo. Ad esempio, GPT-4o di OpenAI e modelli simili richiedono la sincronizzazione dei dati in tempo reale per consentire un'inferenza e un addestramento efficienti. Ciò richiede non solo un throughput di dati a livello di TB/s, ma anche una latenza a livello di microsecondi e un'elevata affidabilità per eliminare eventuali colli di bottiglia.
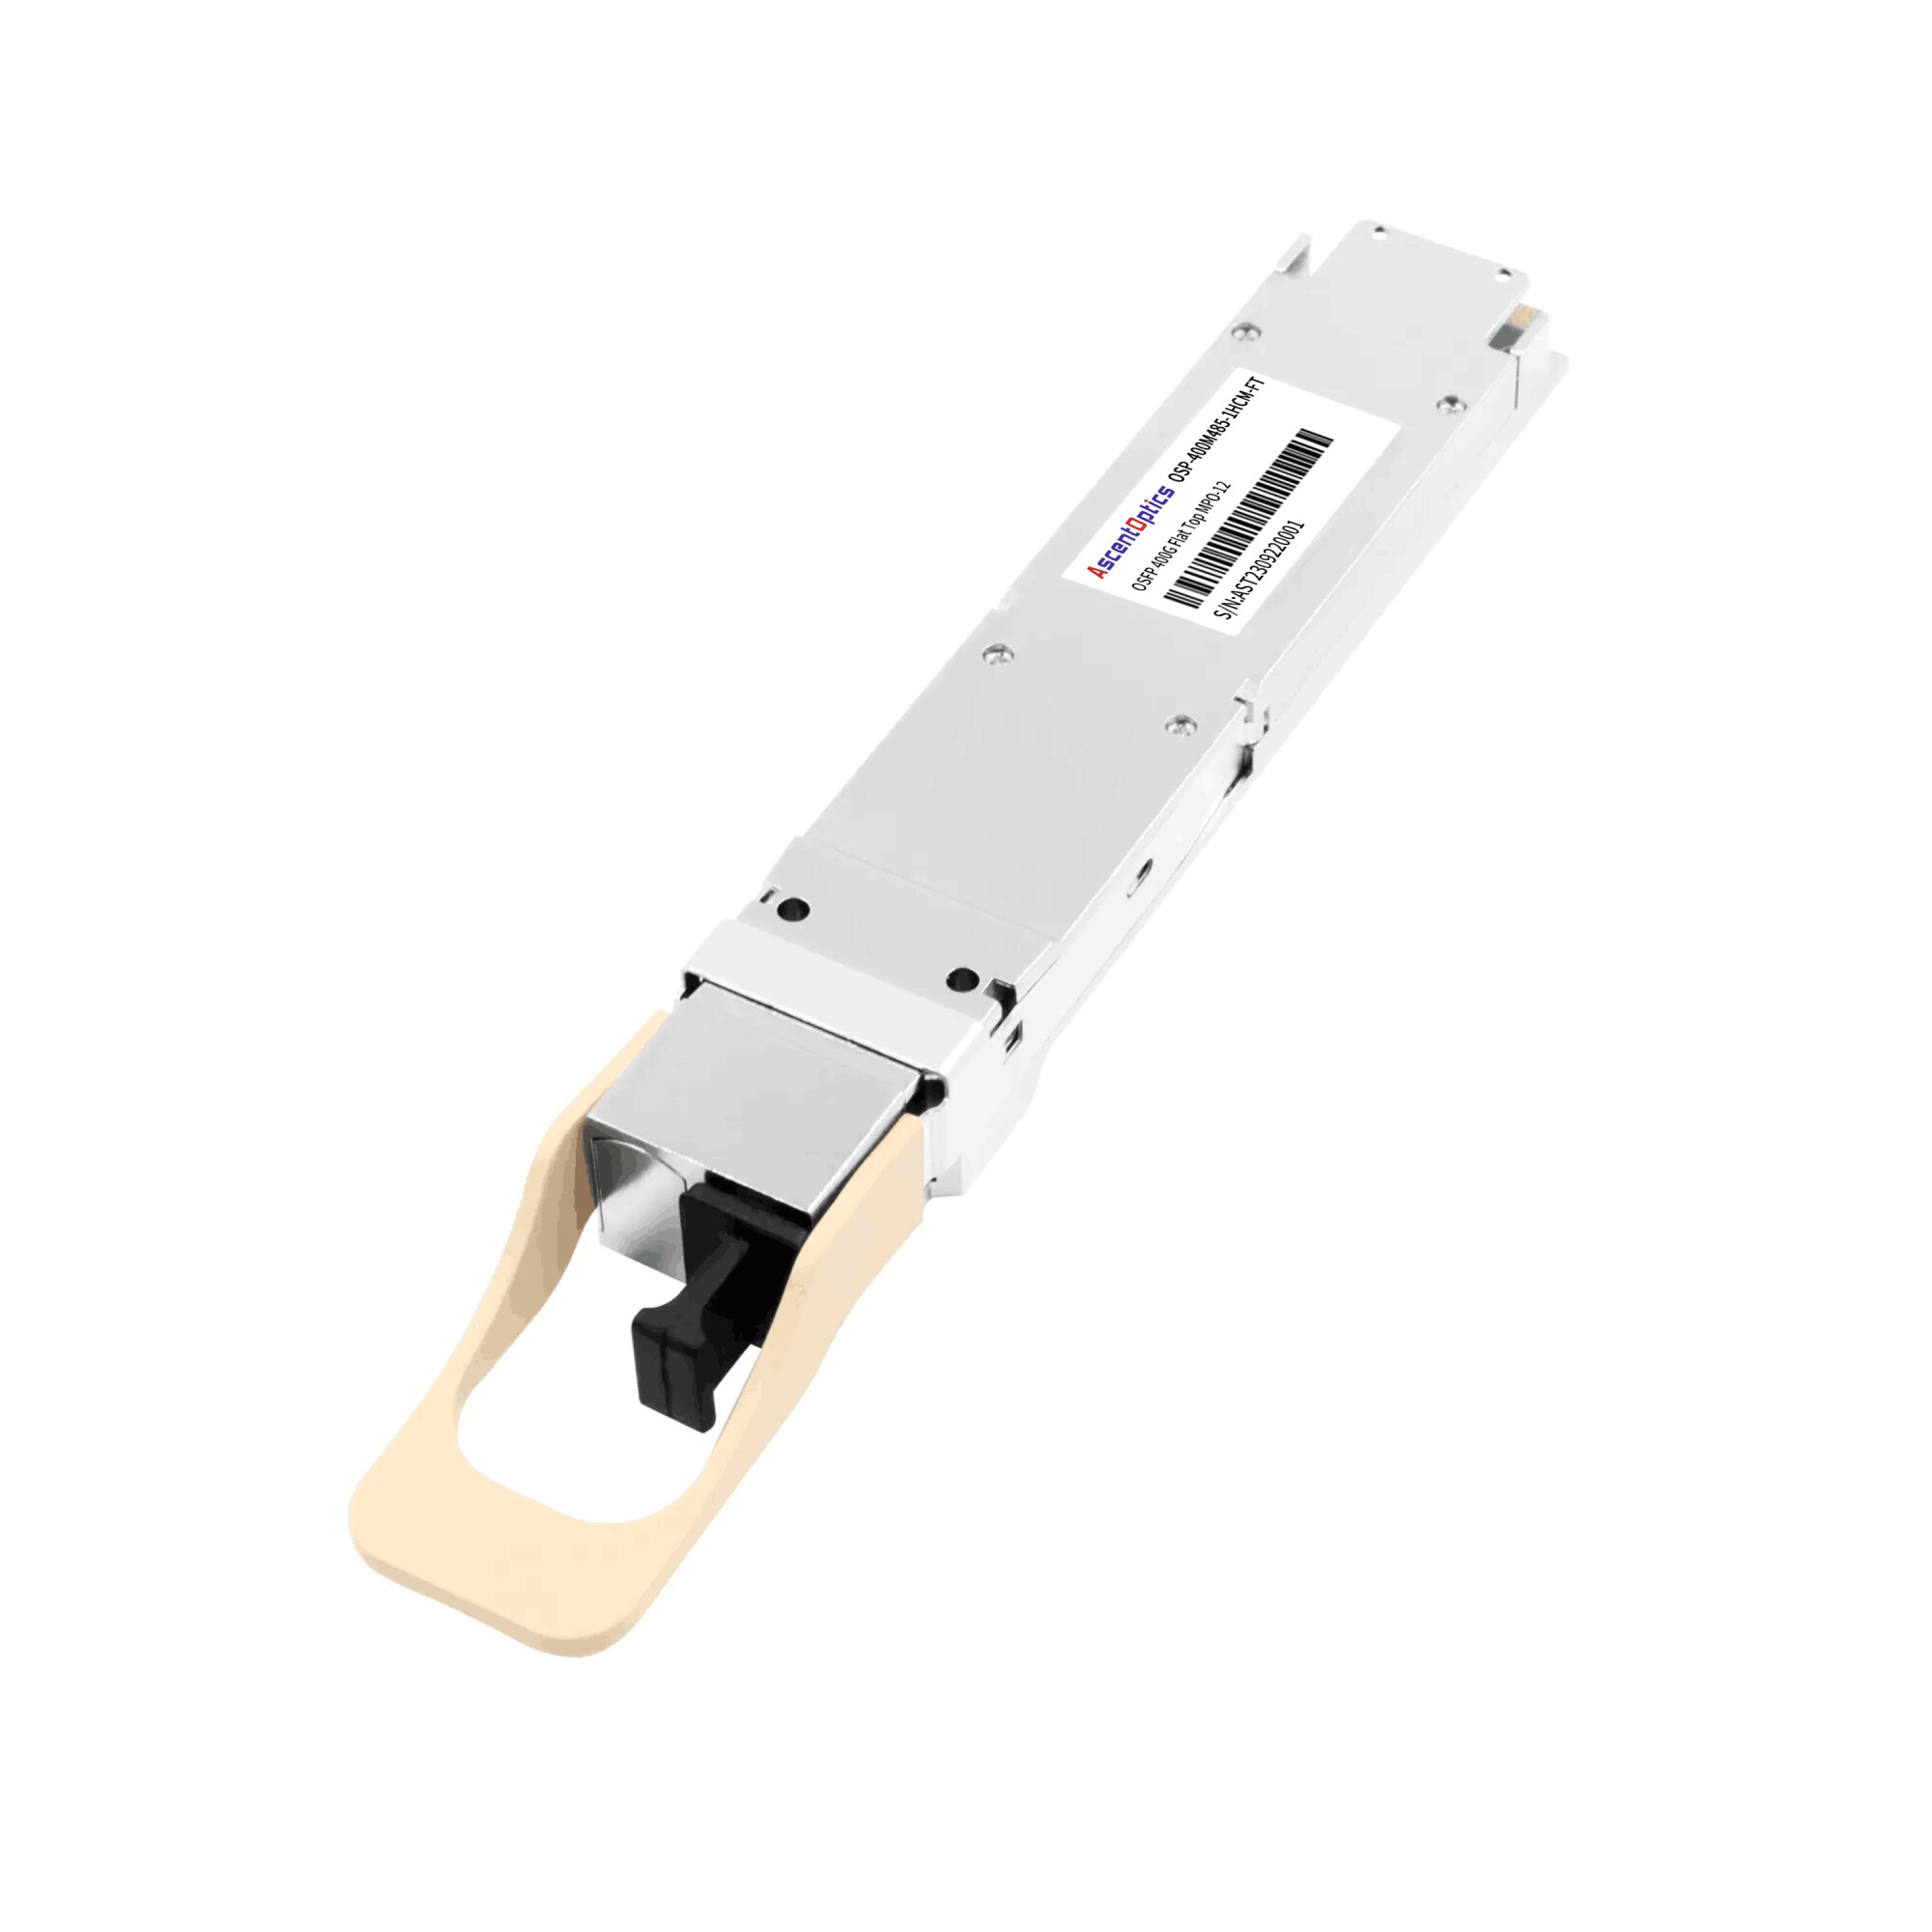
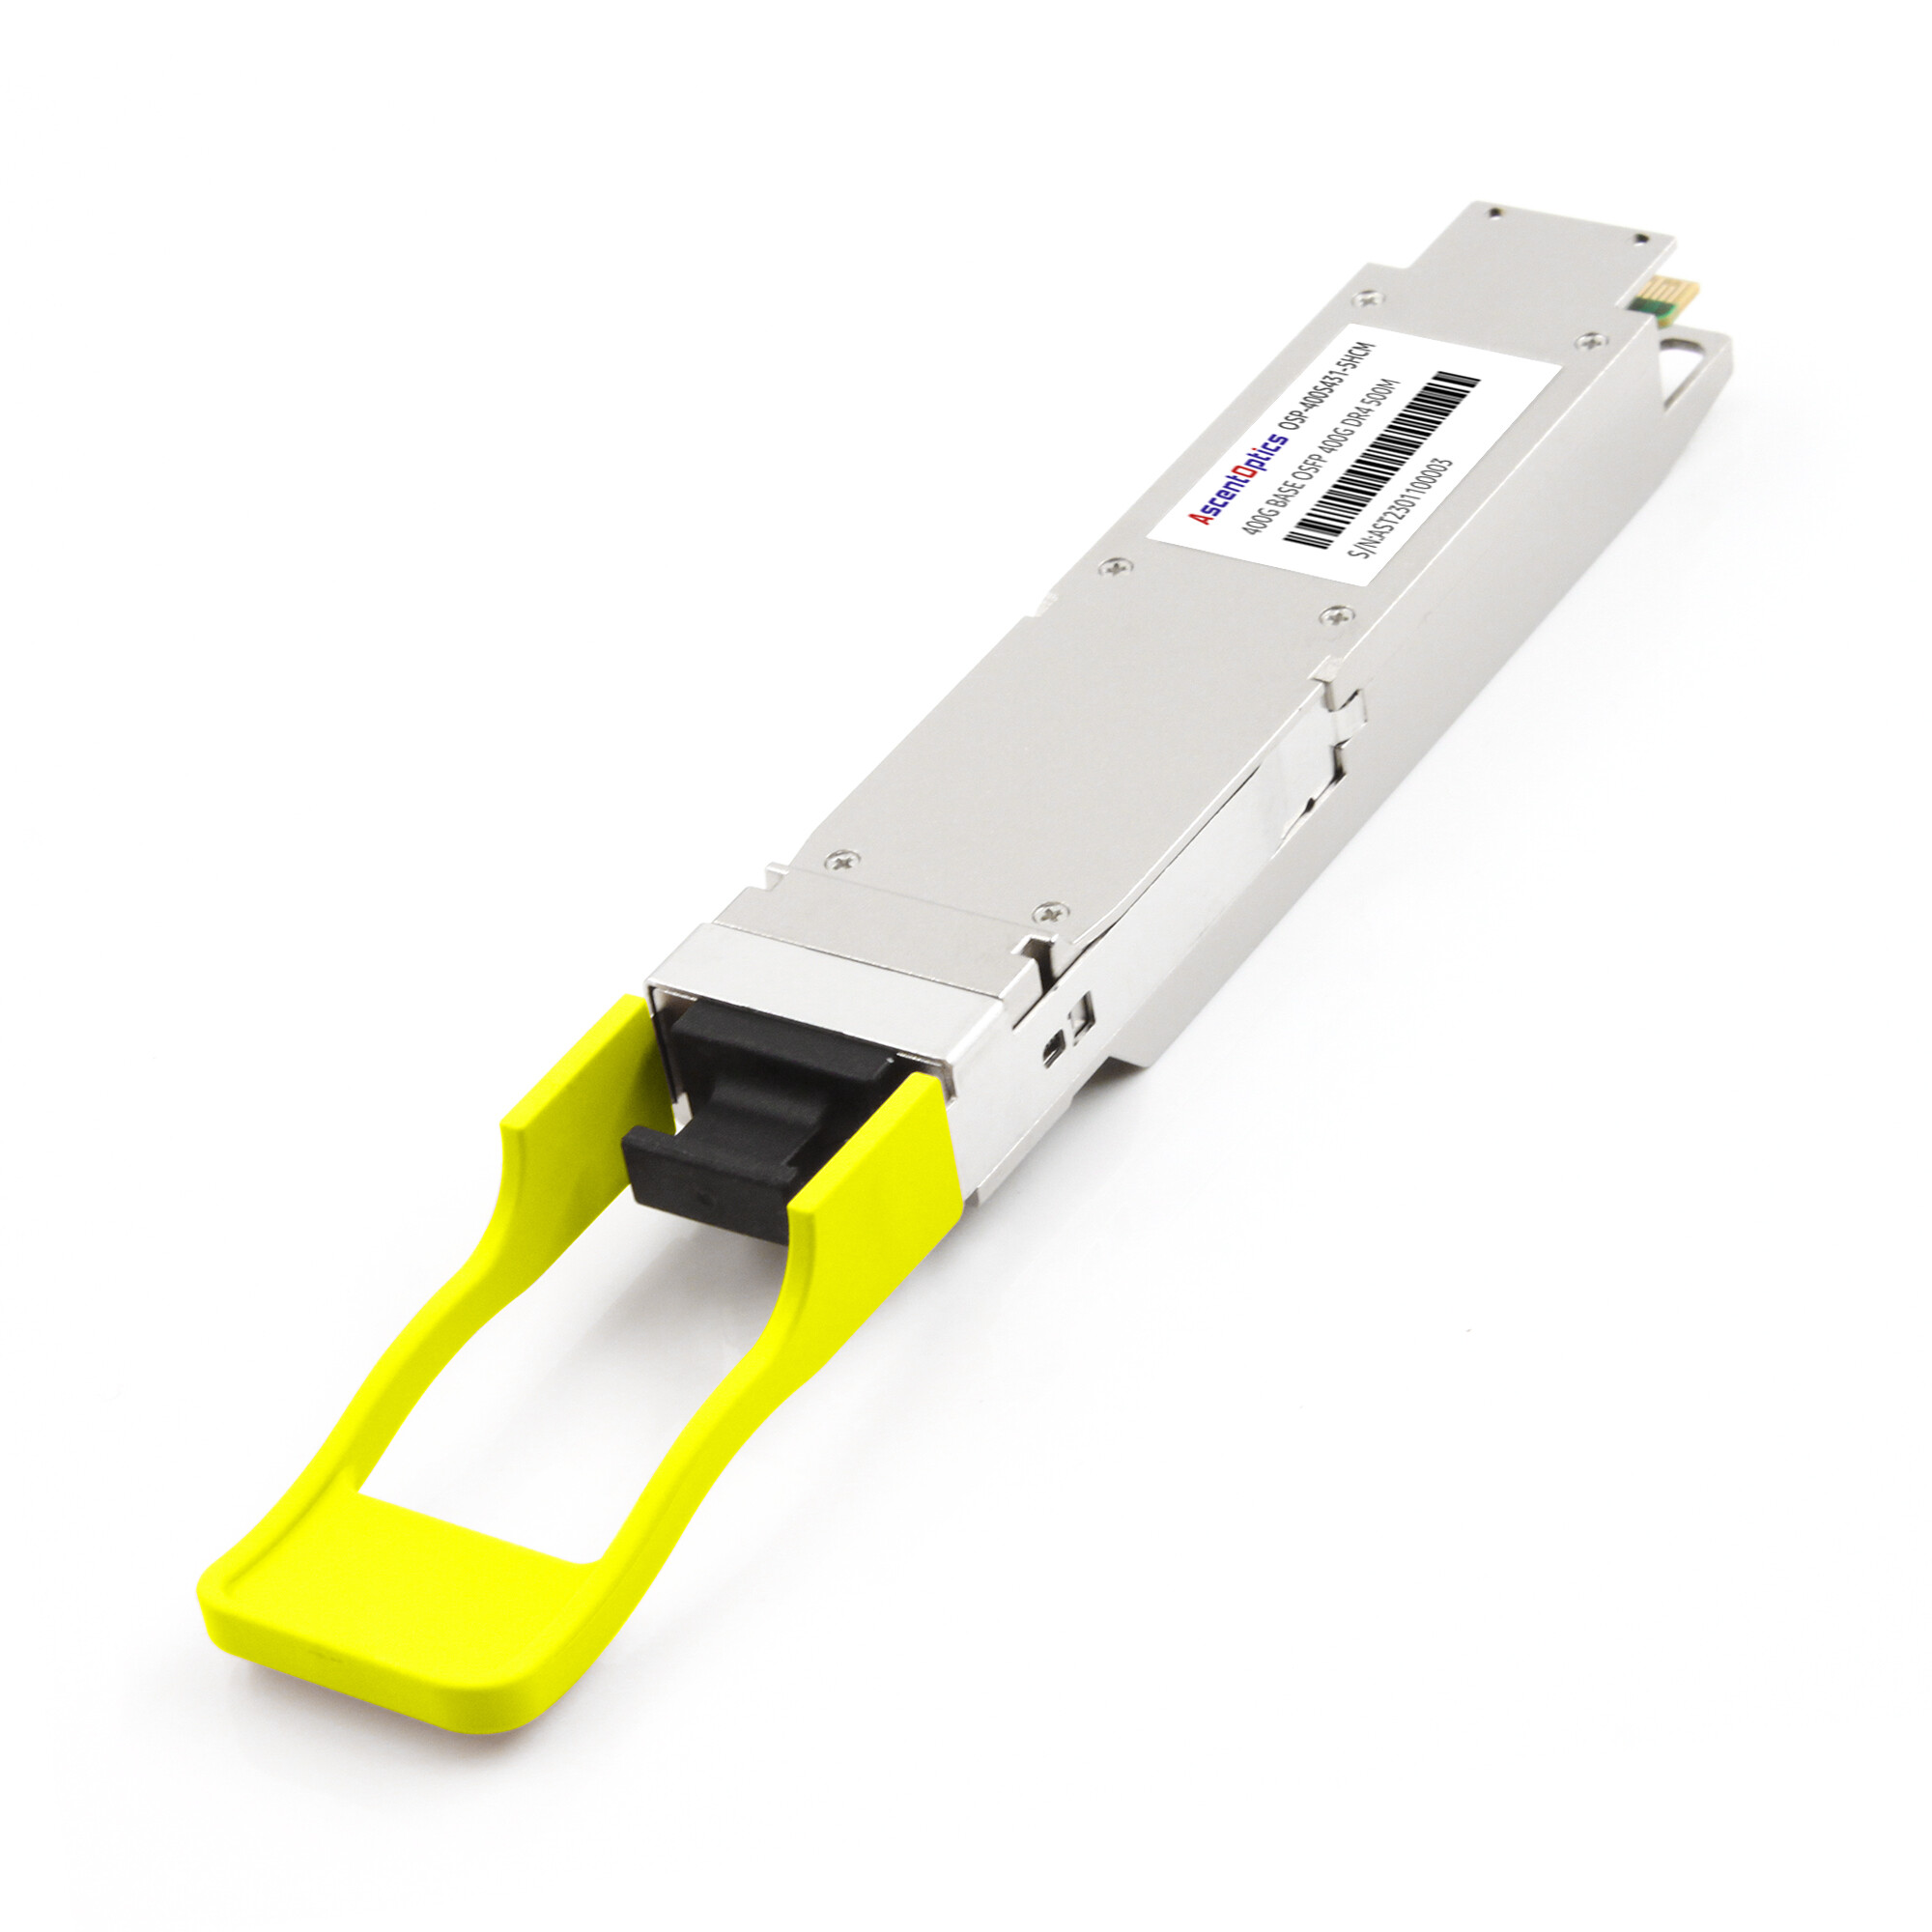
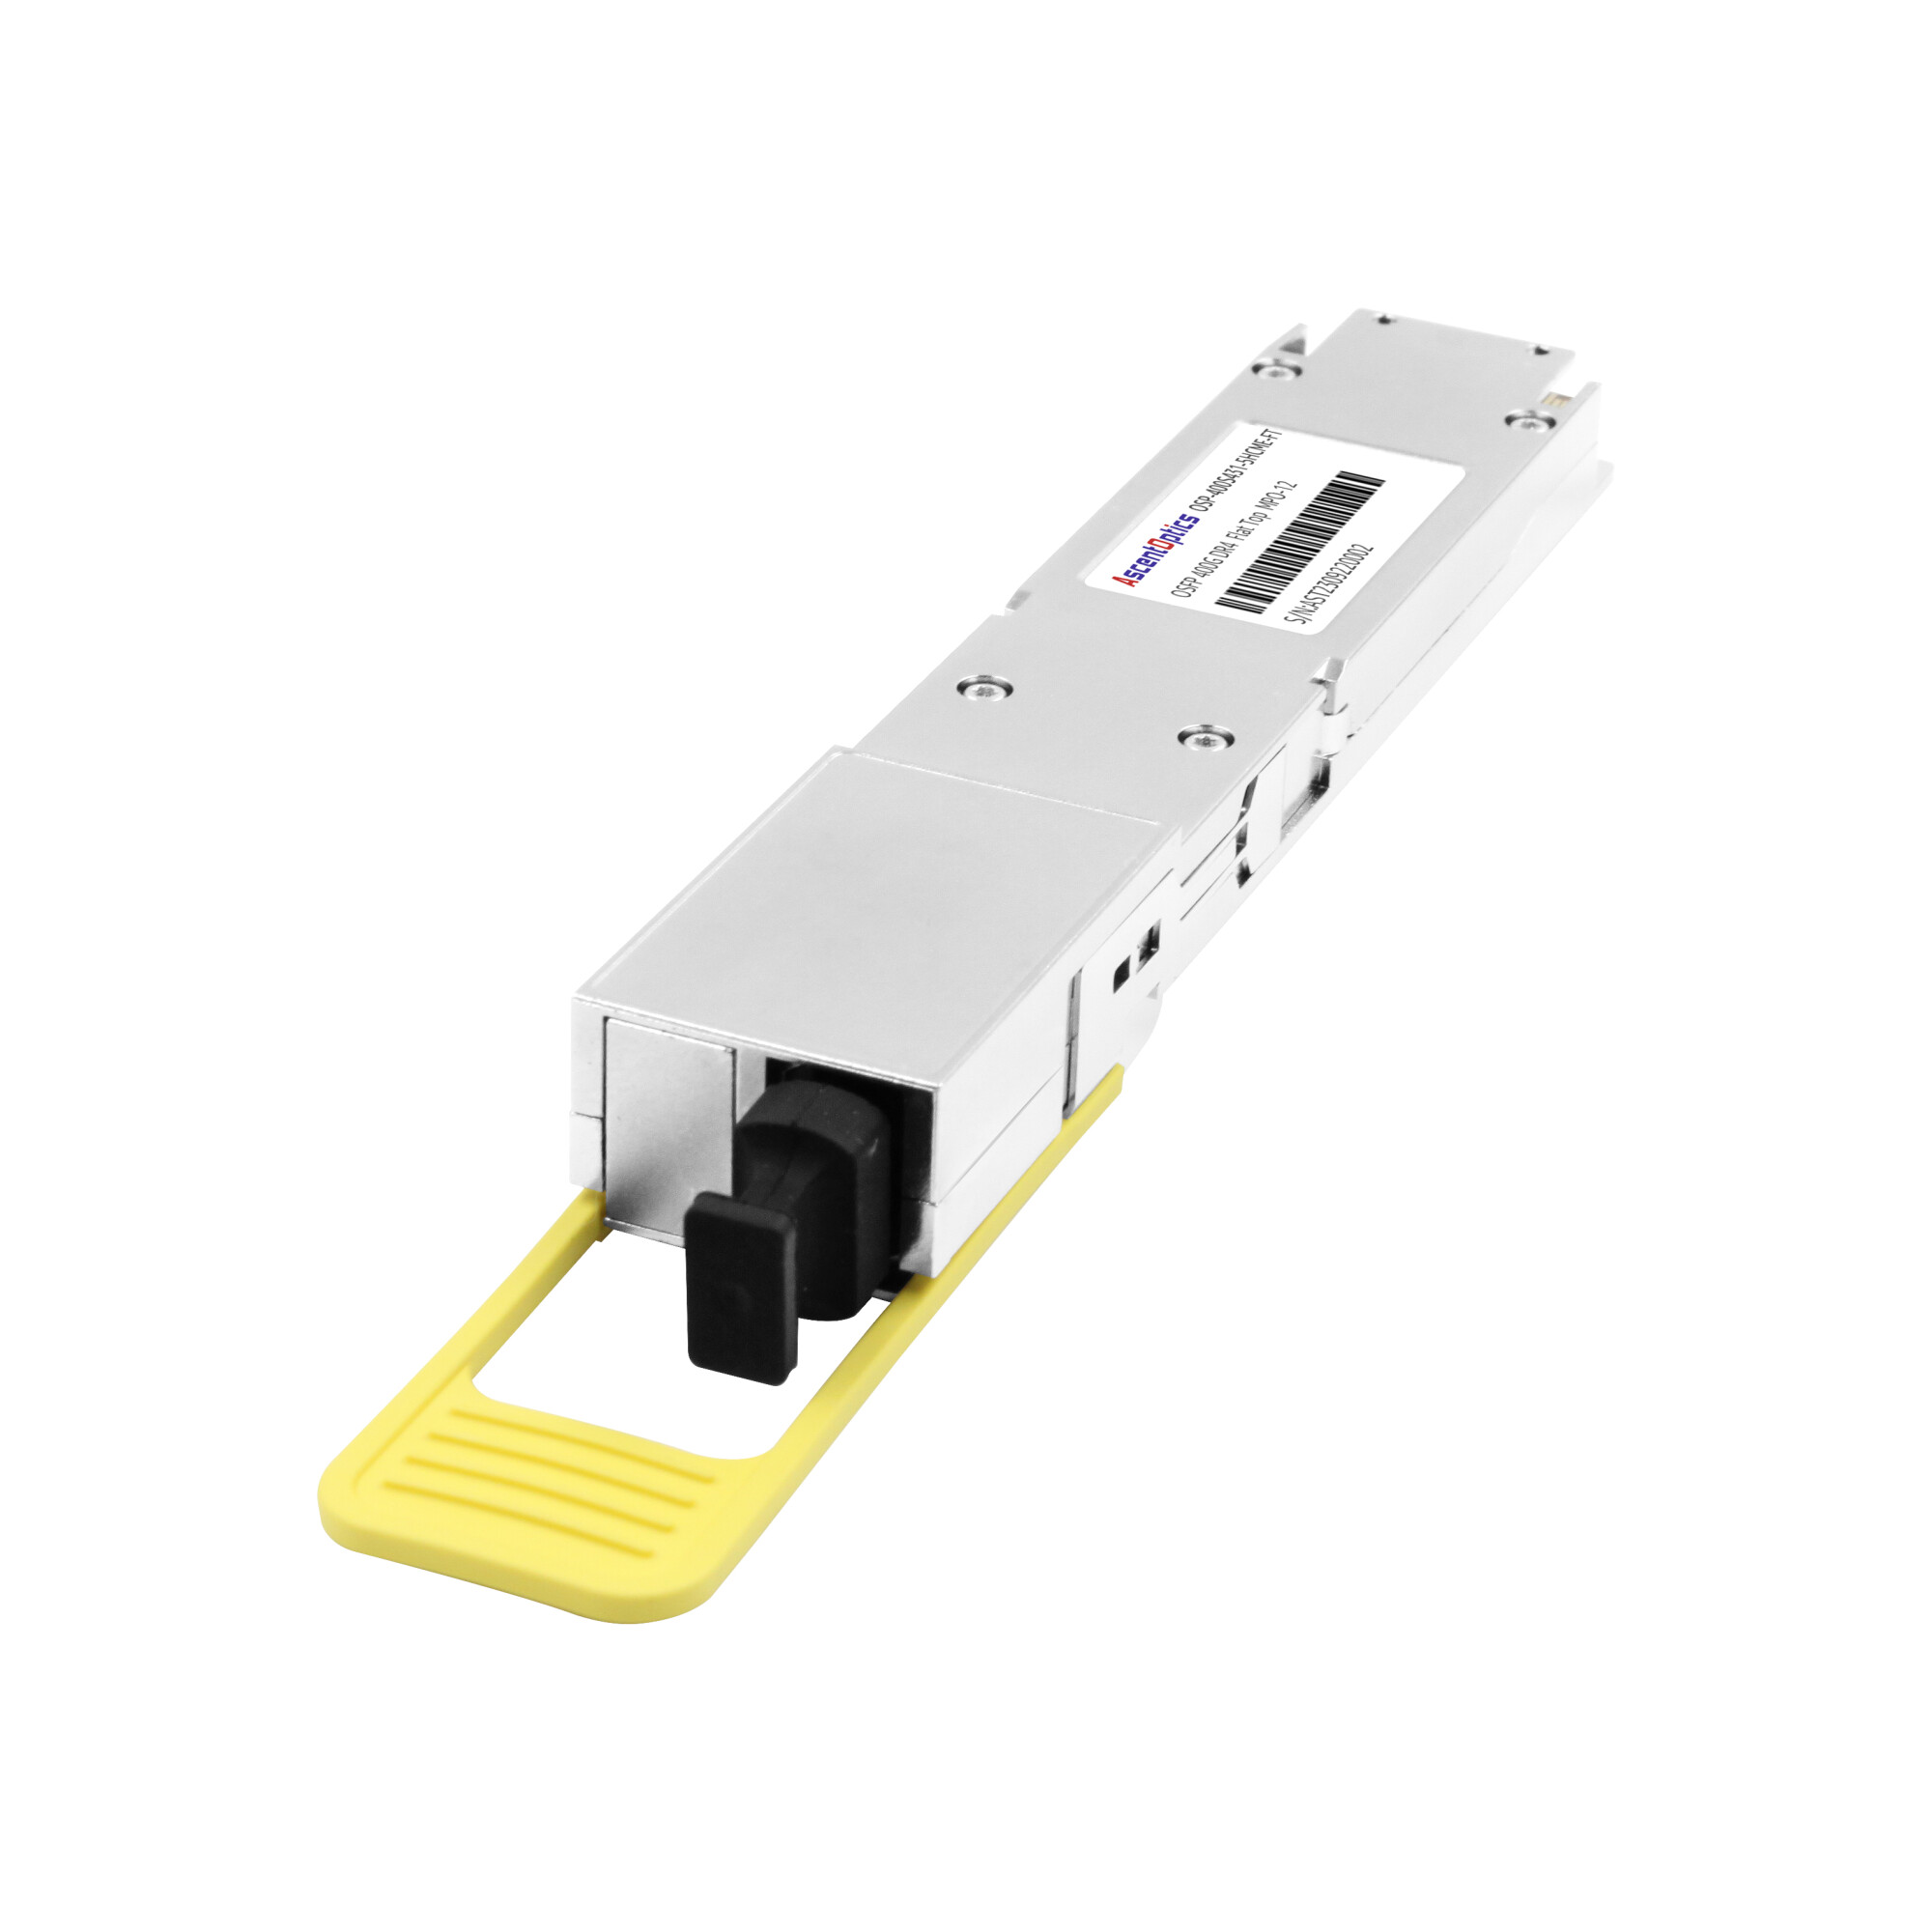
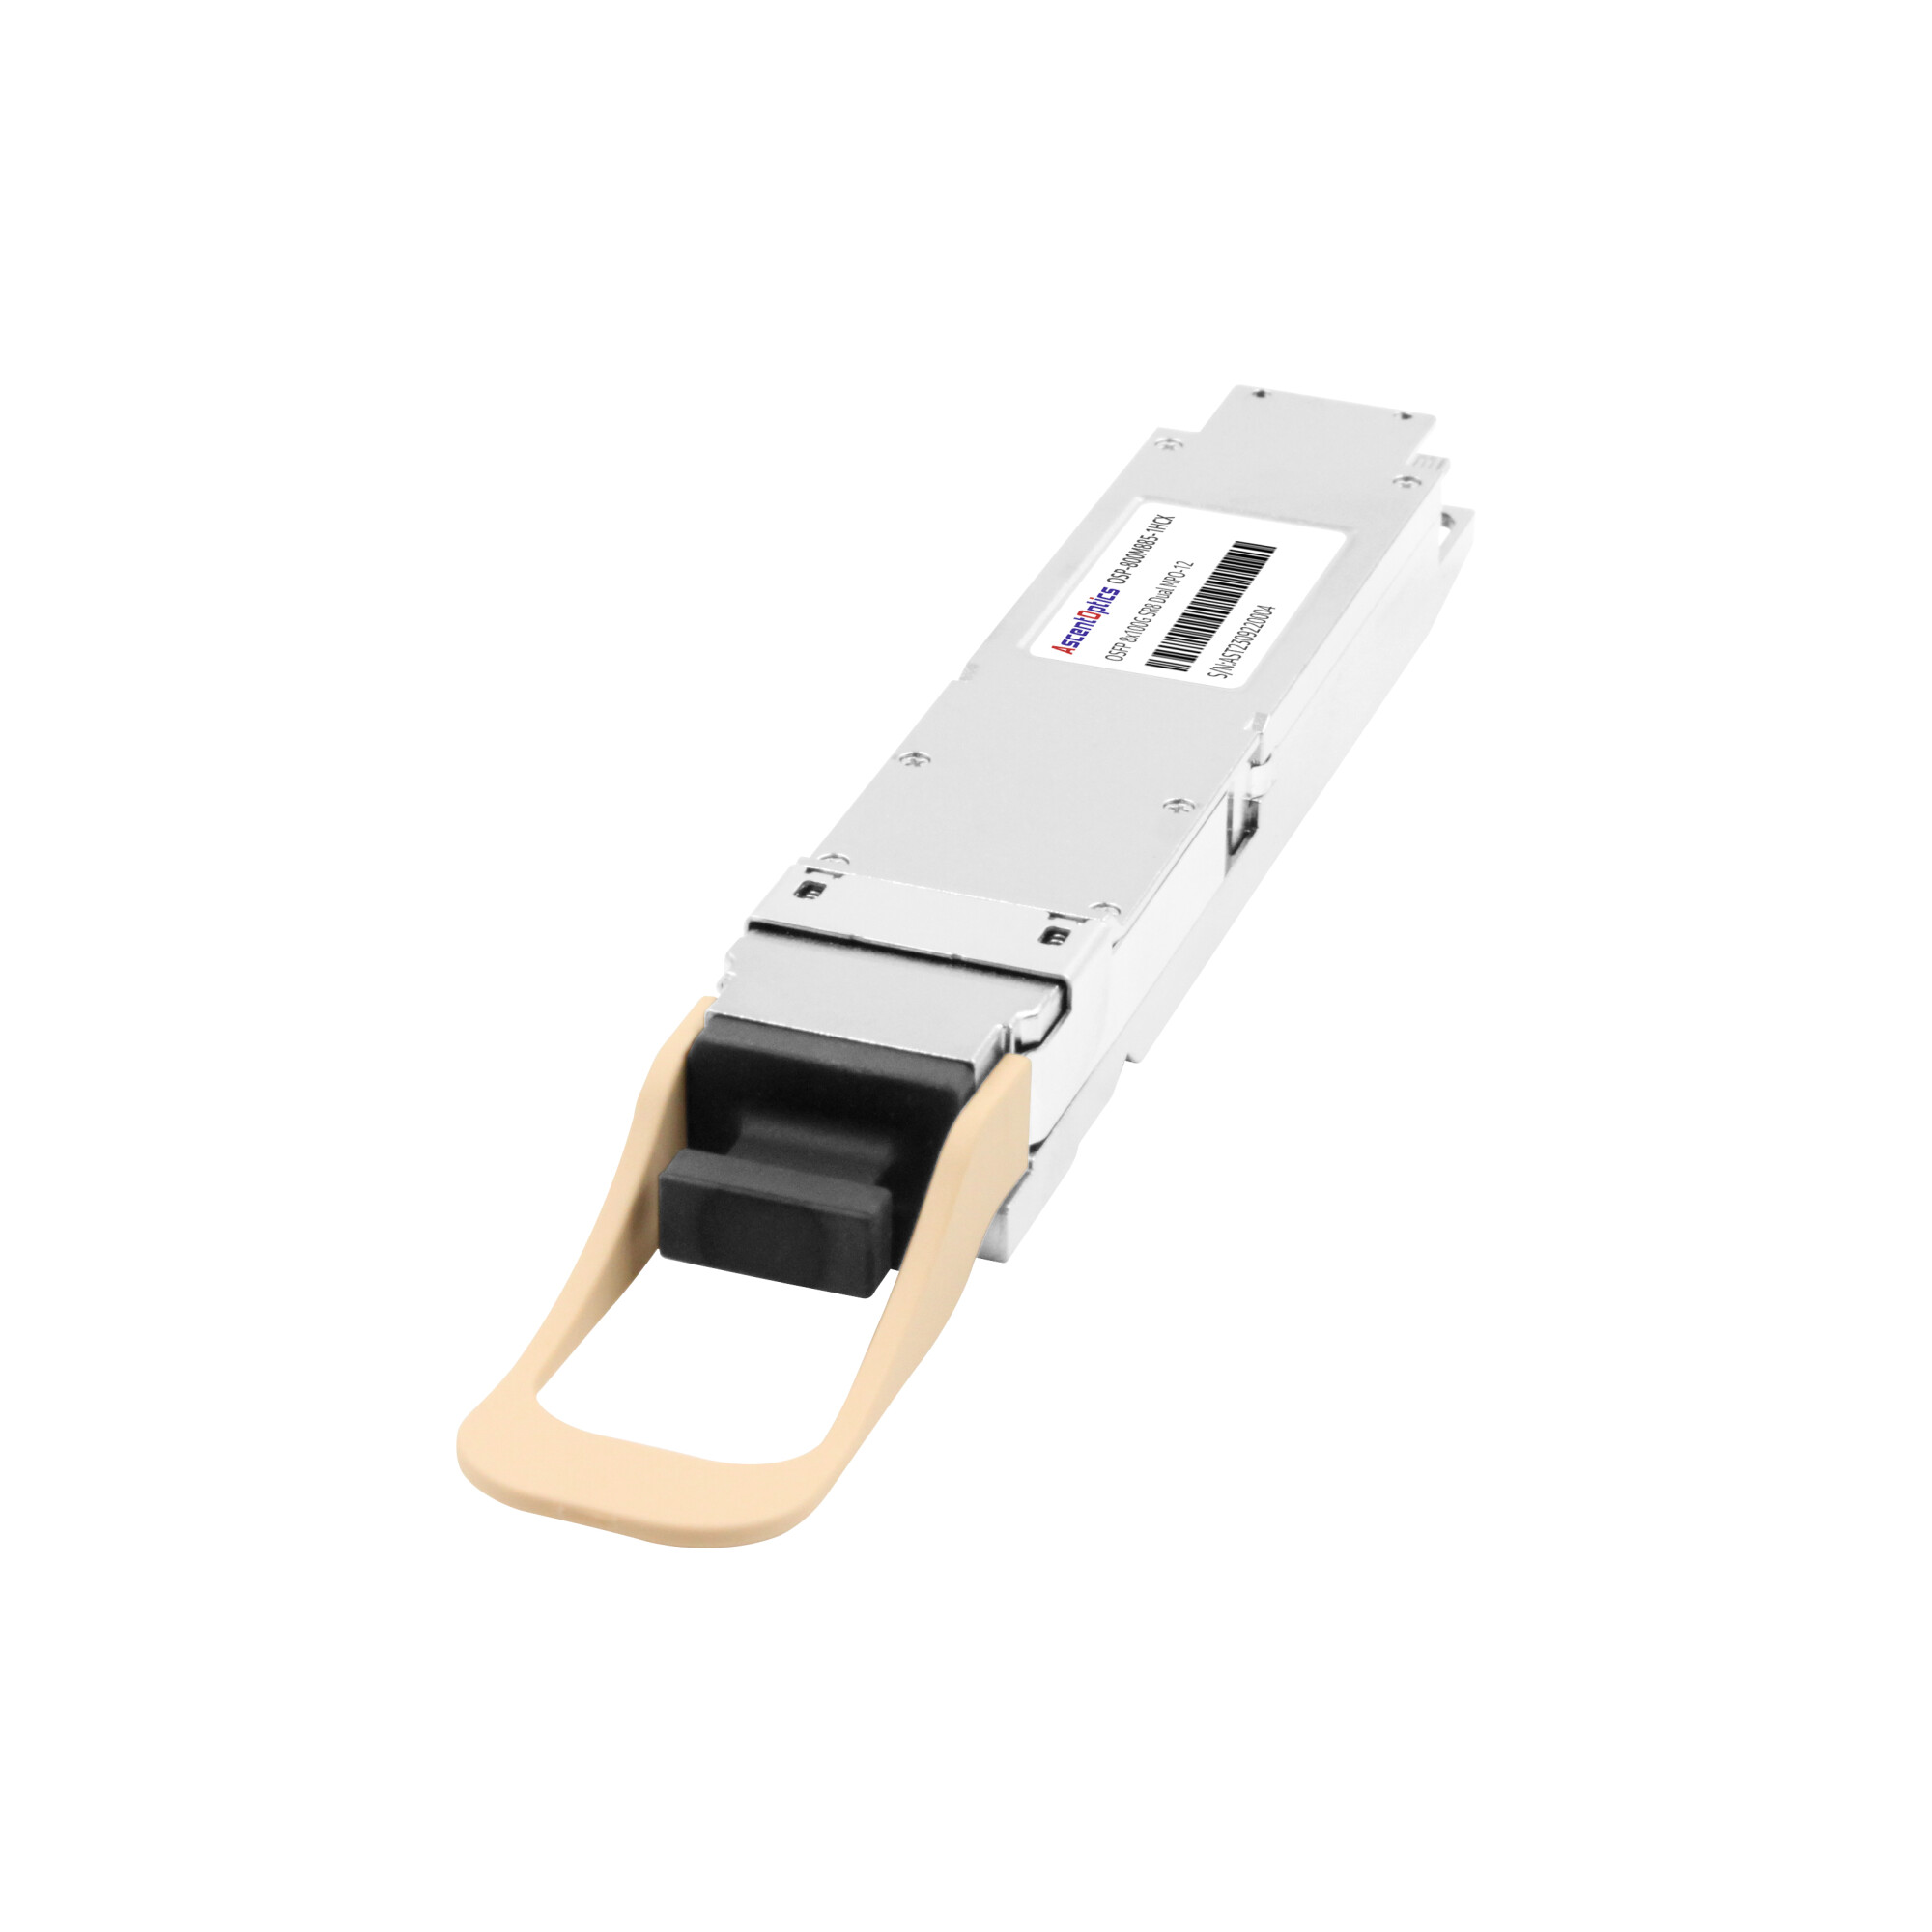
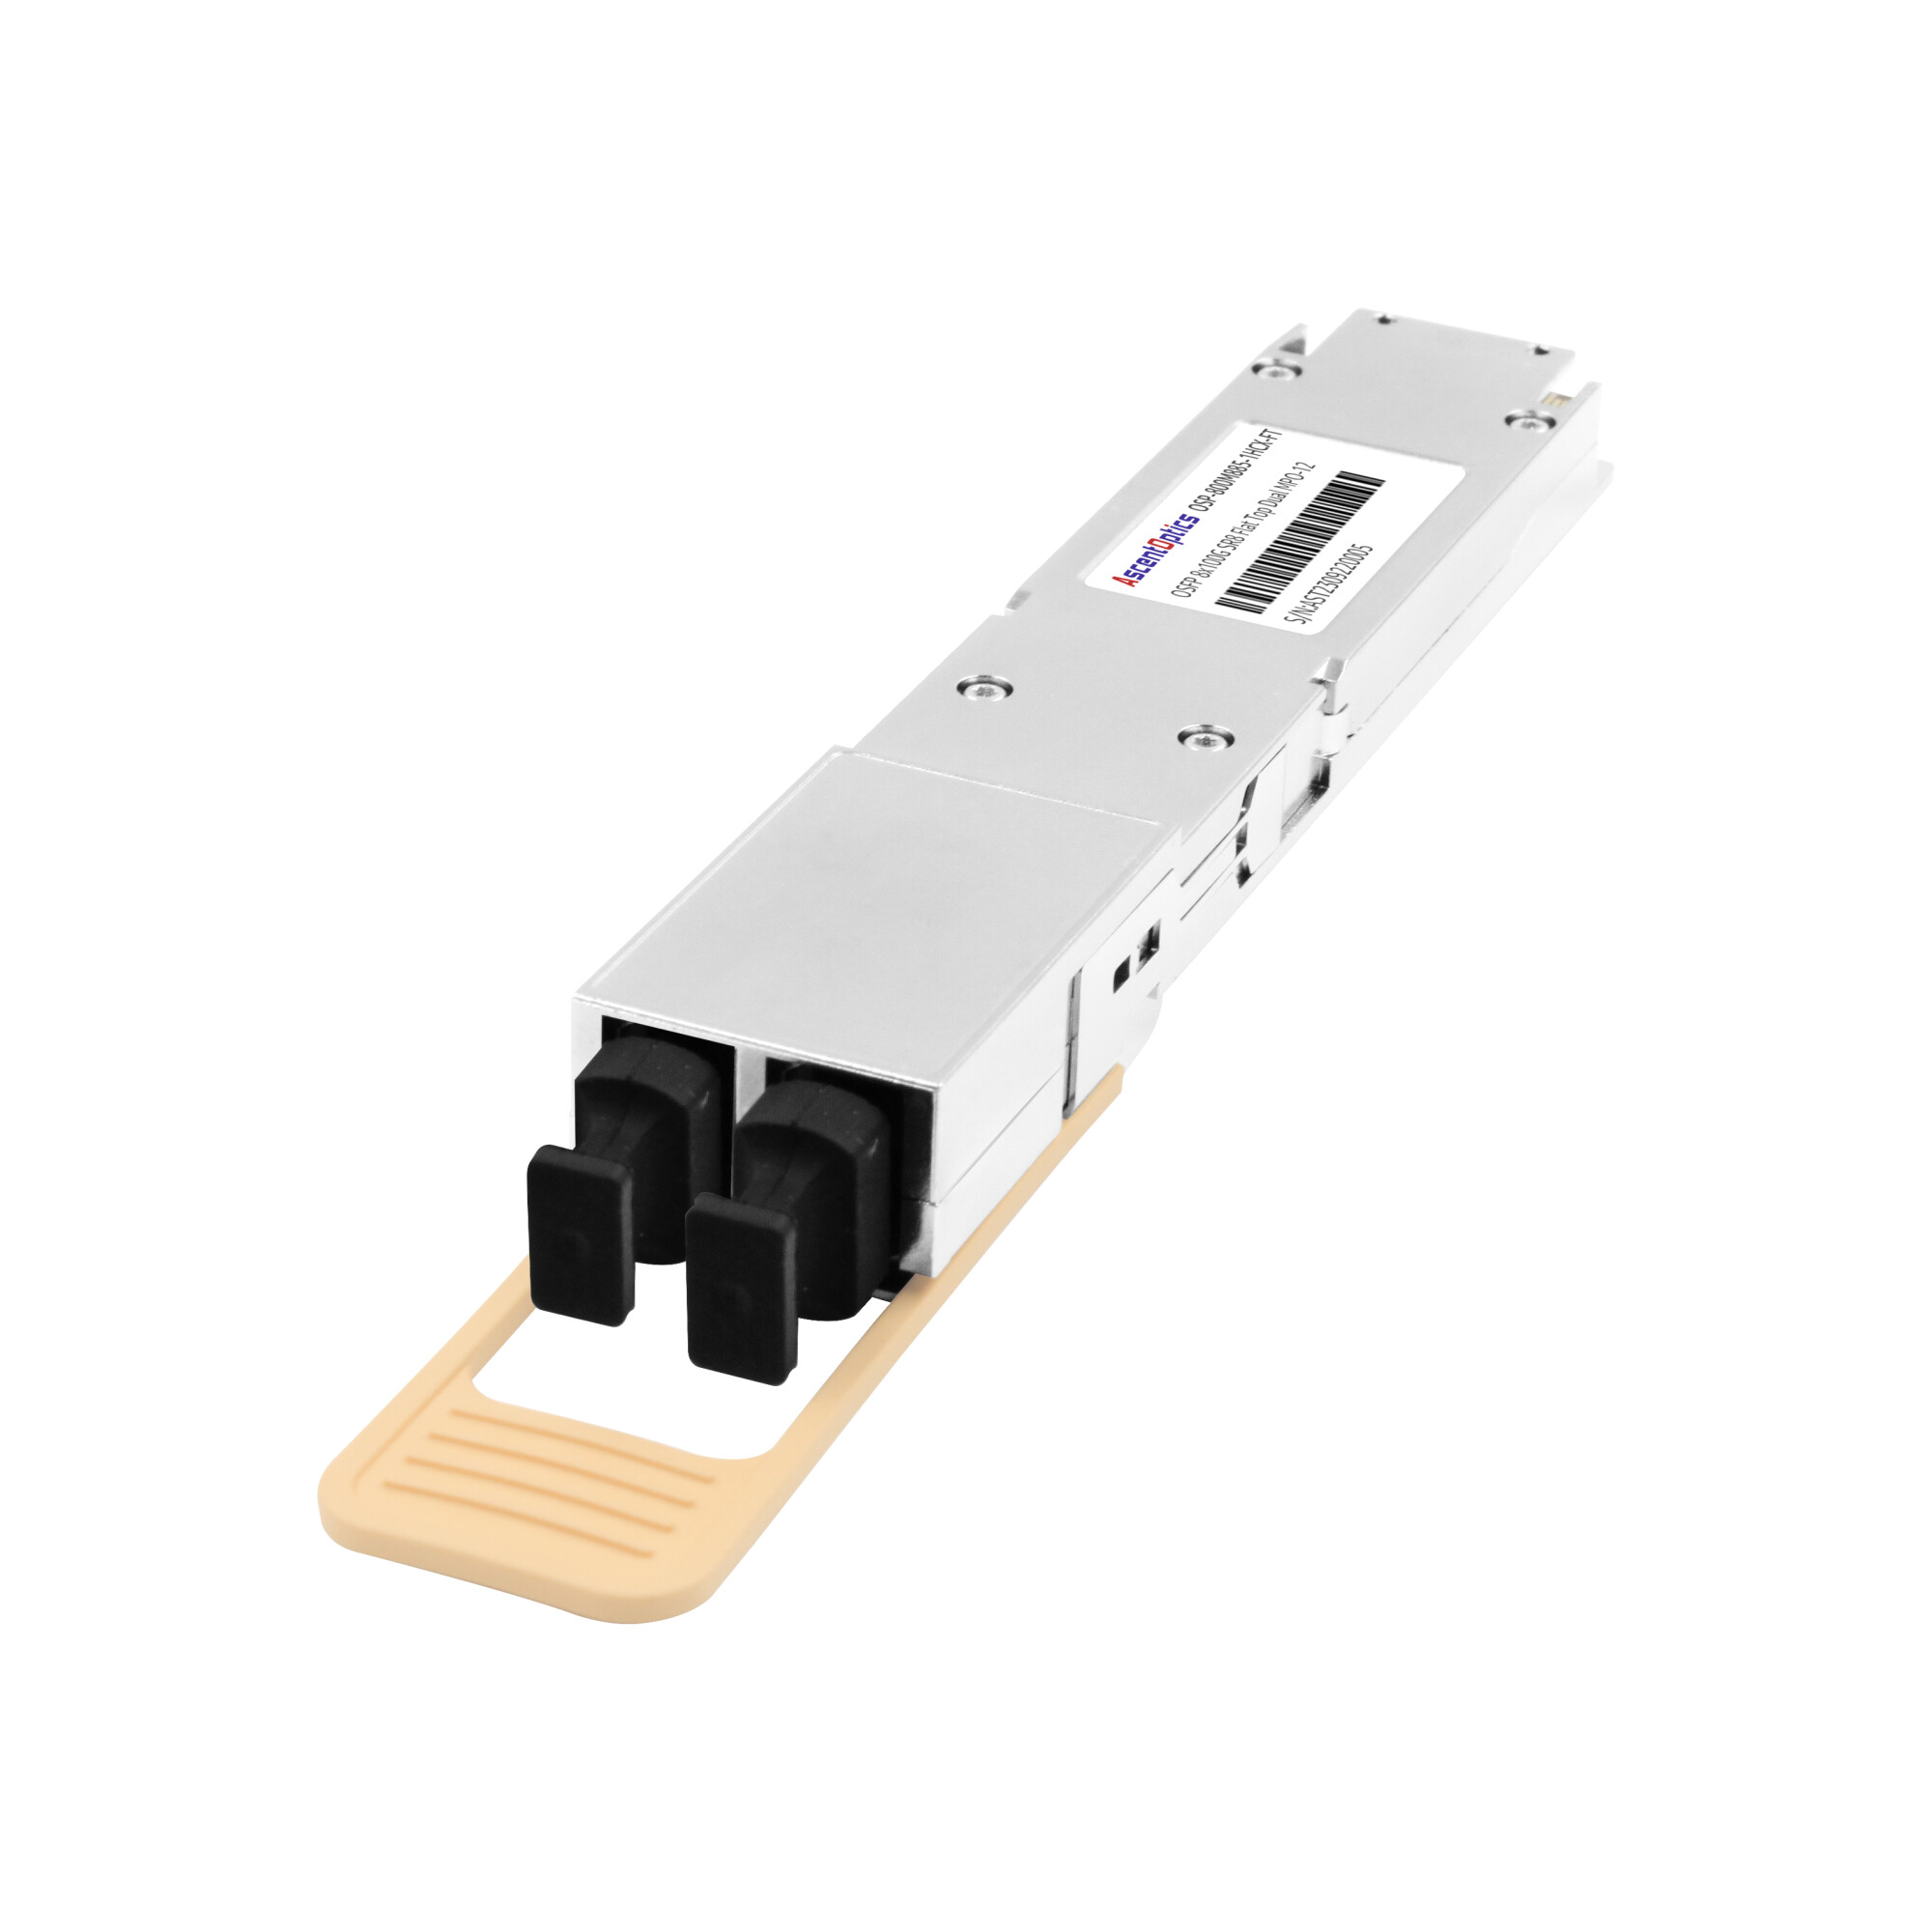
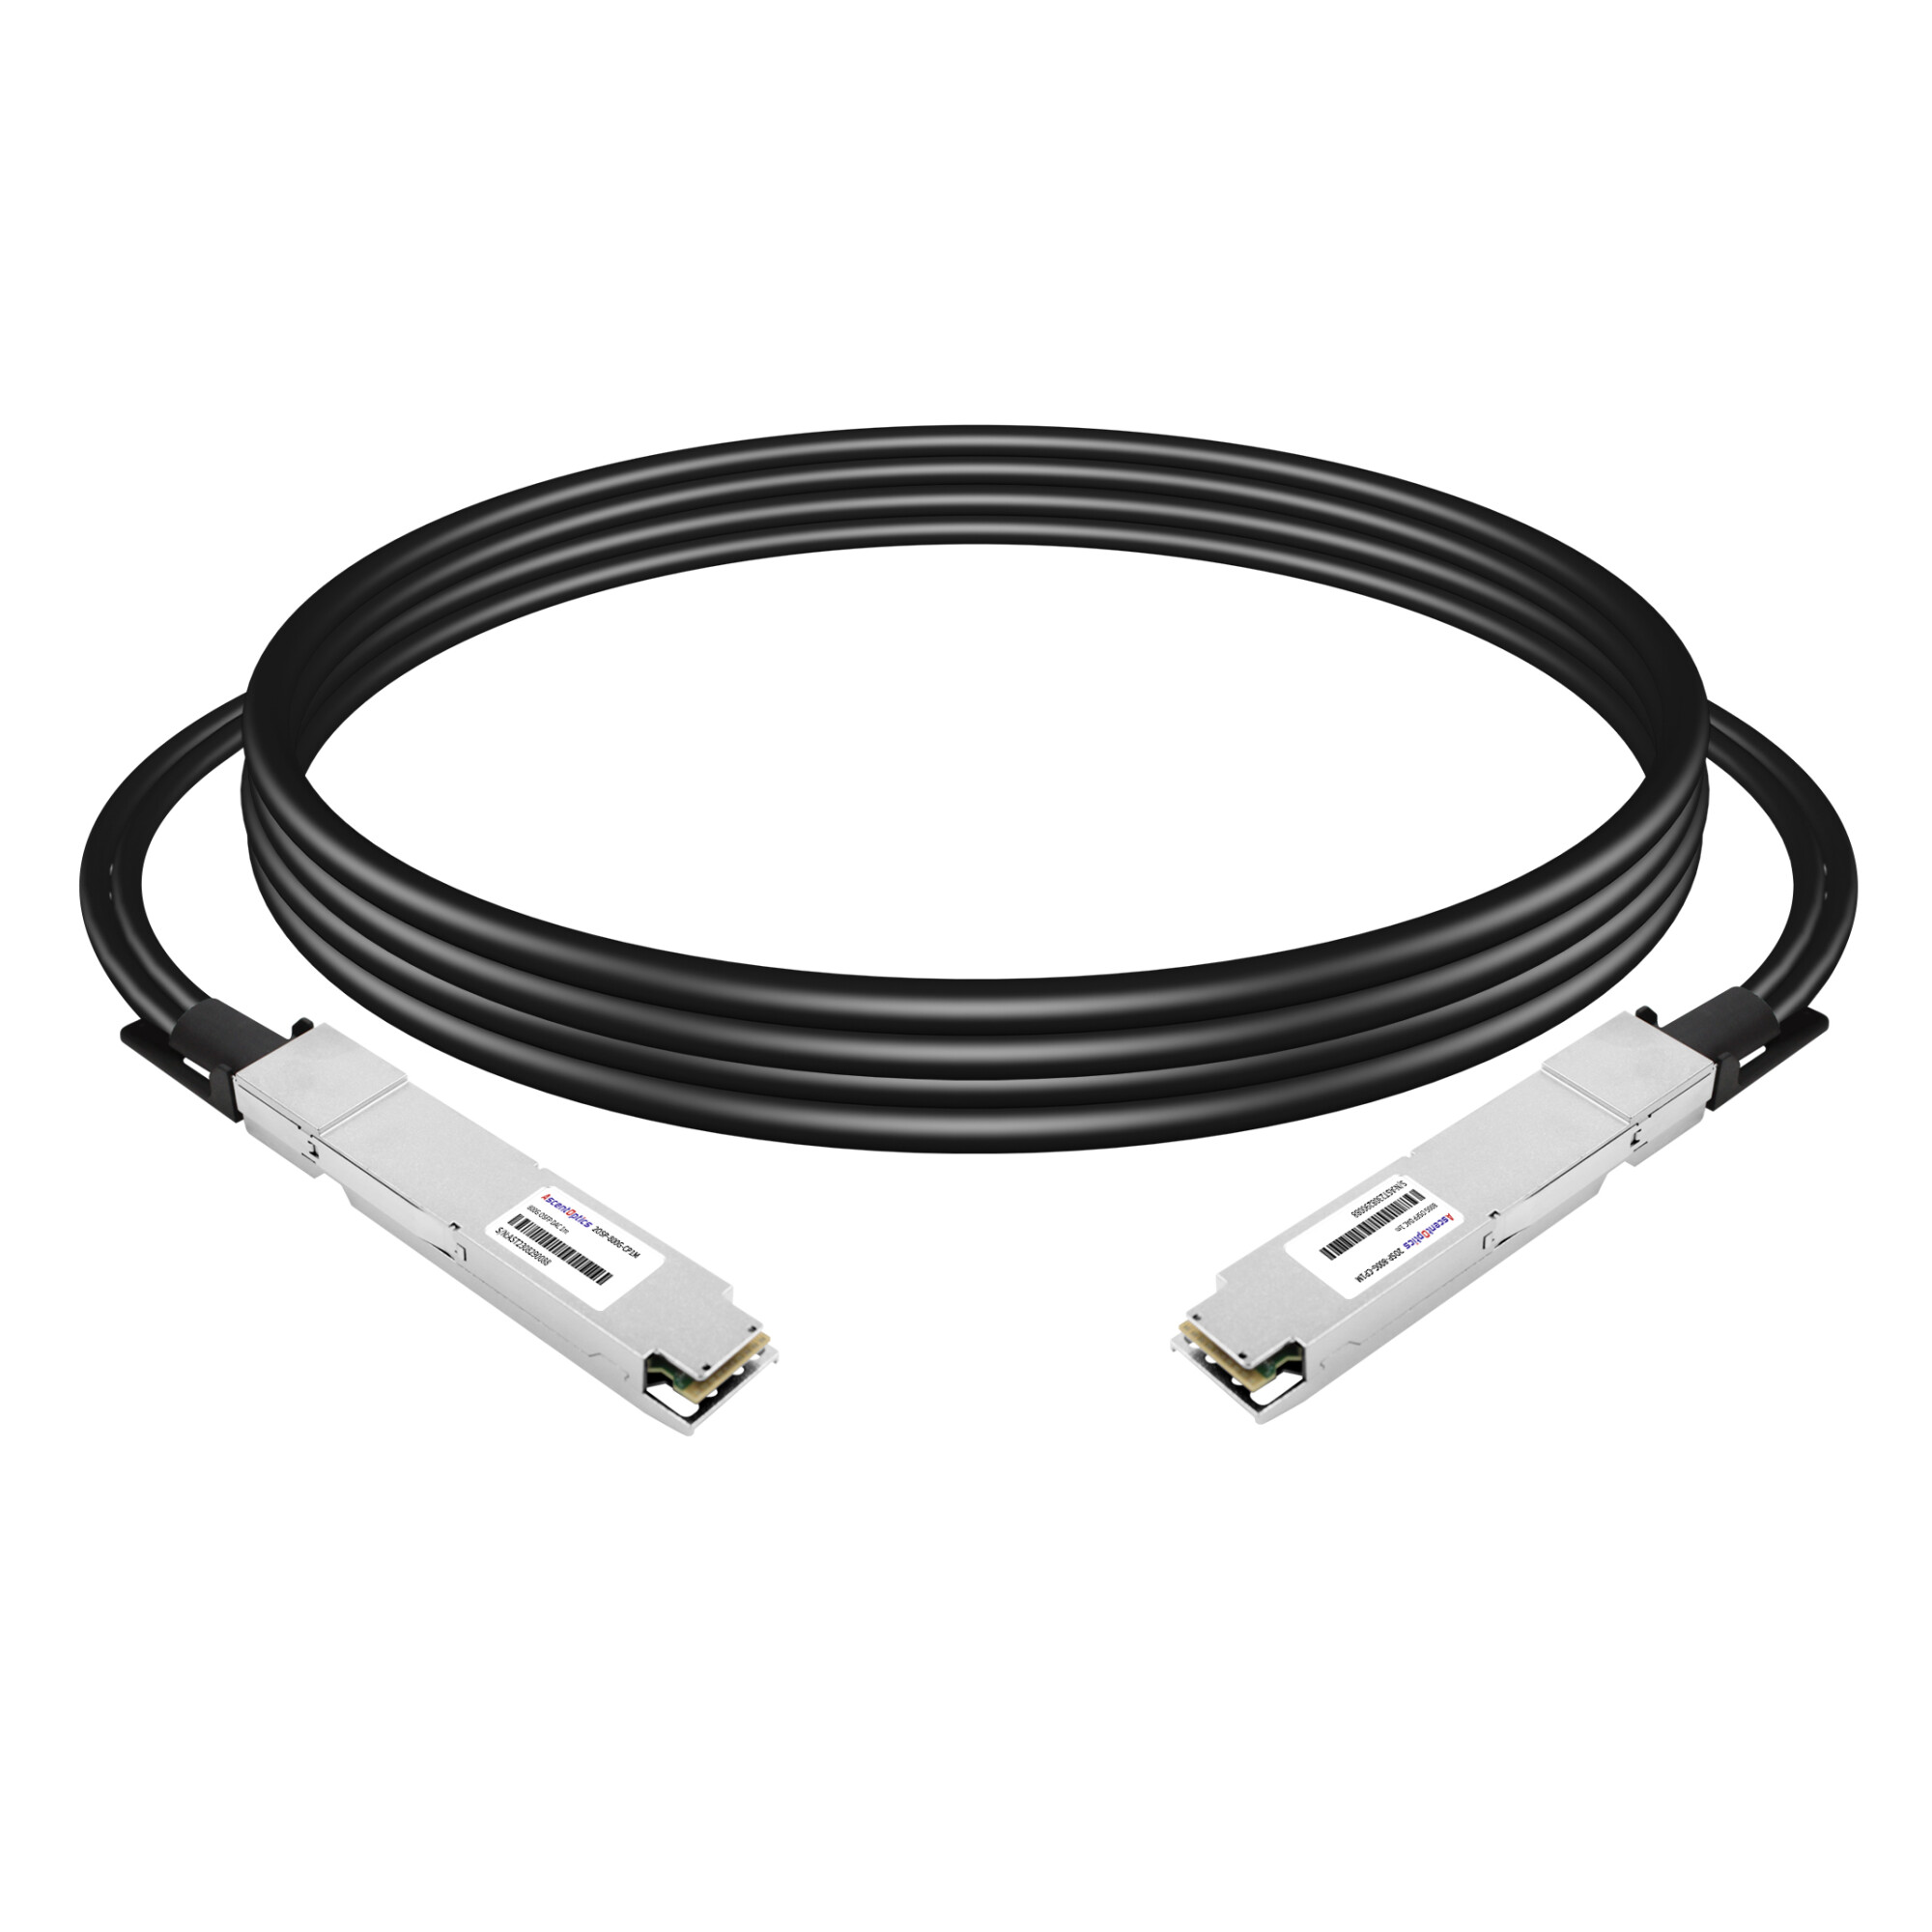
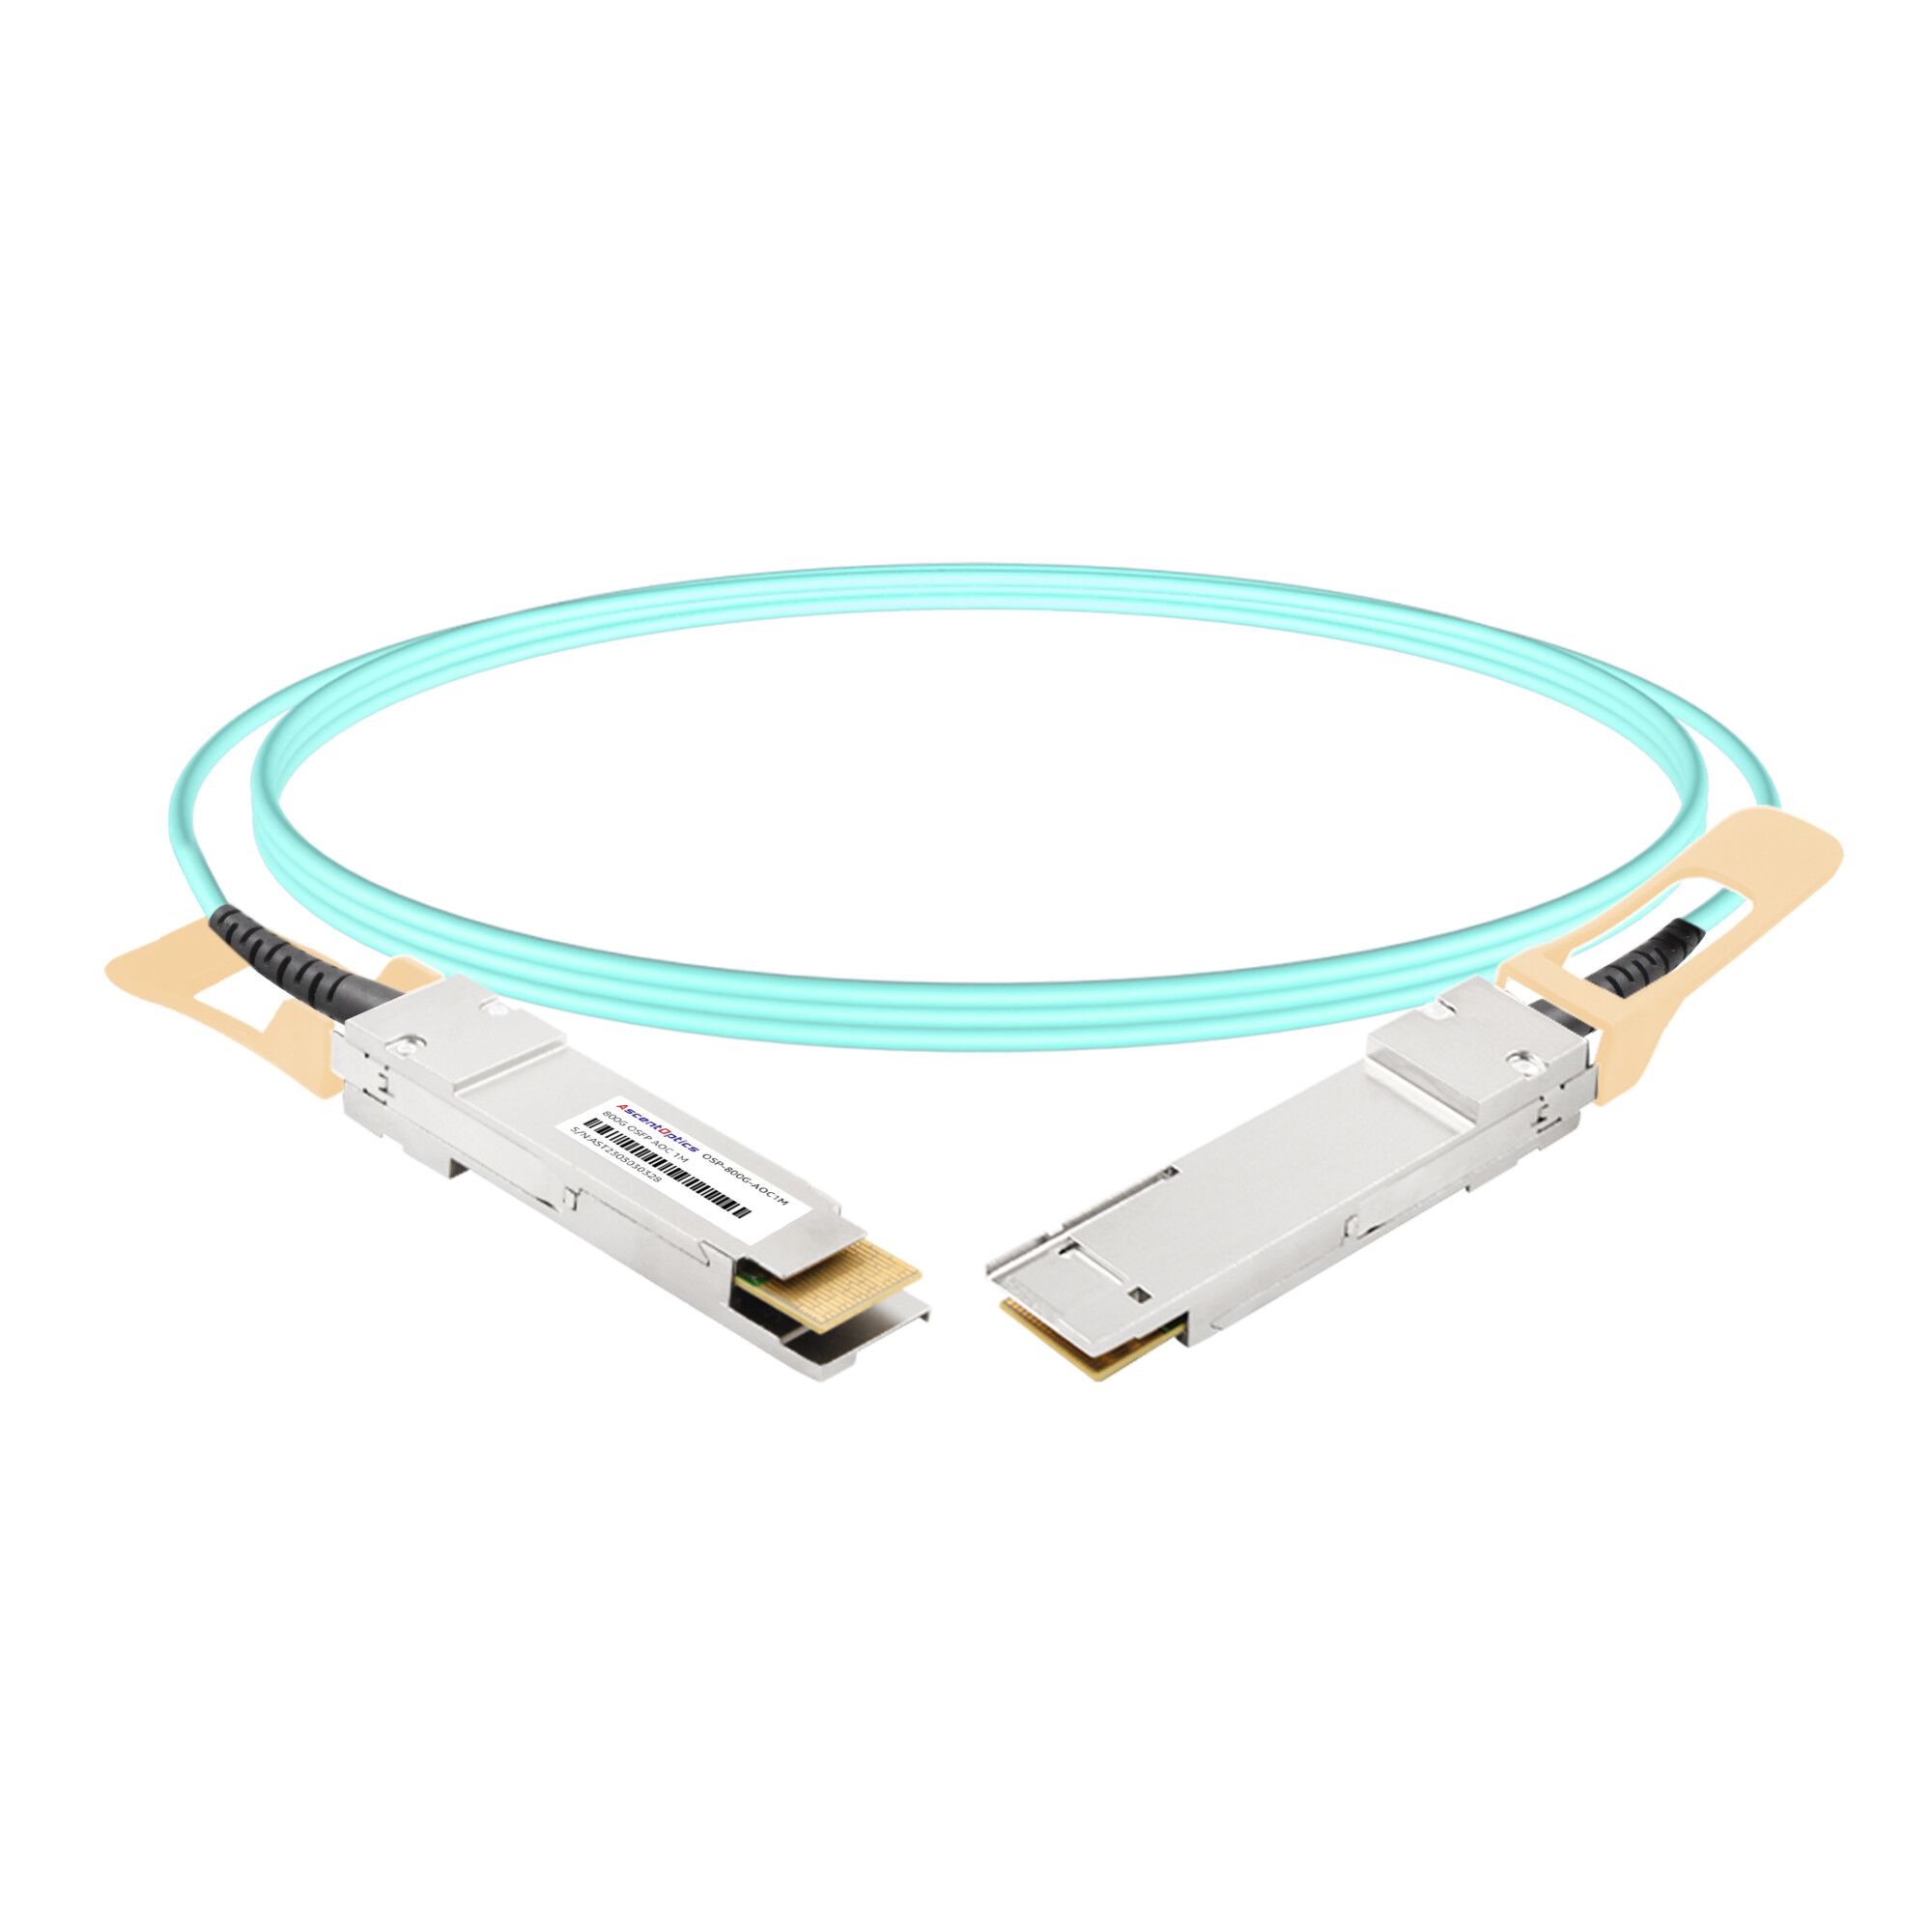
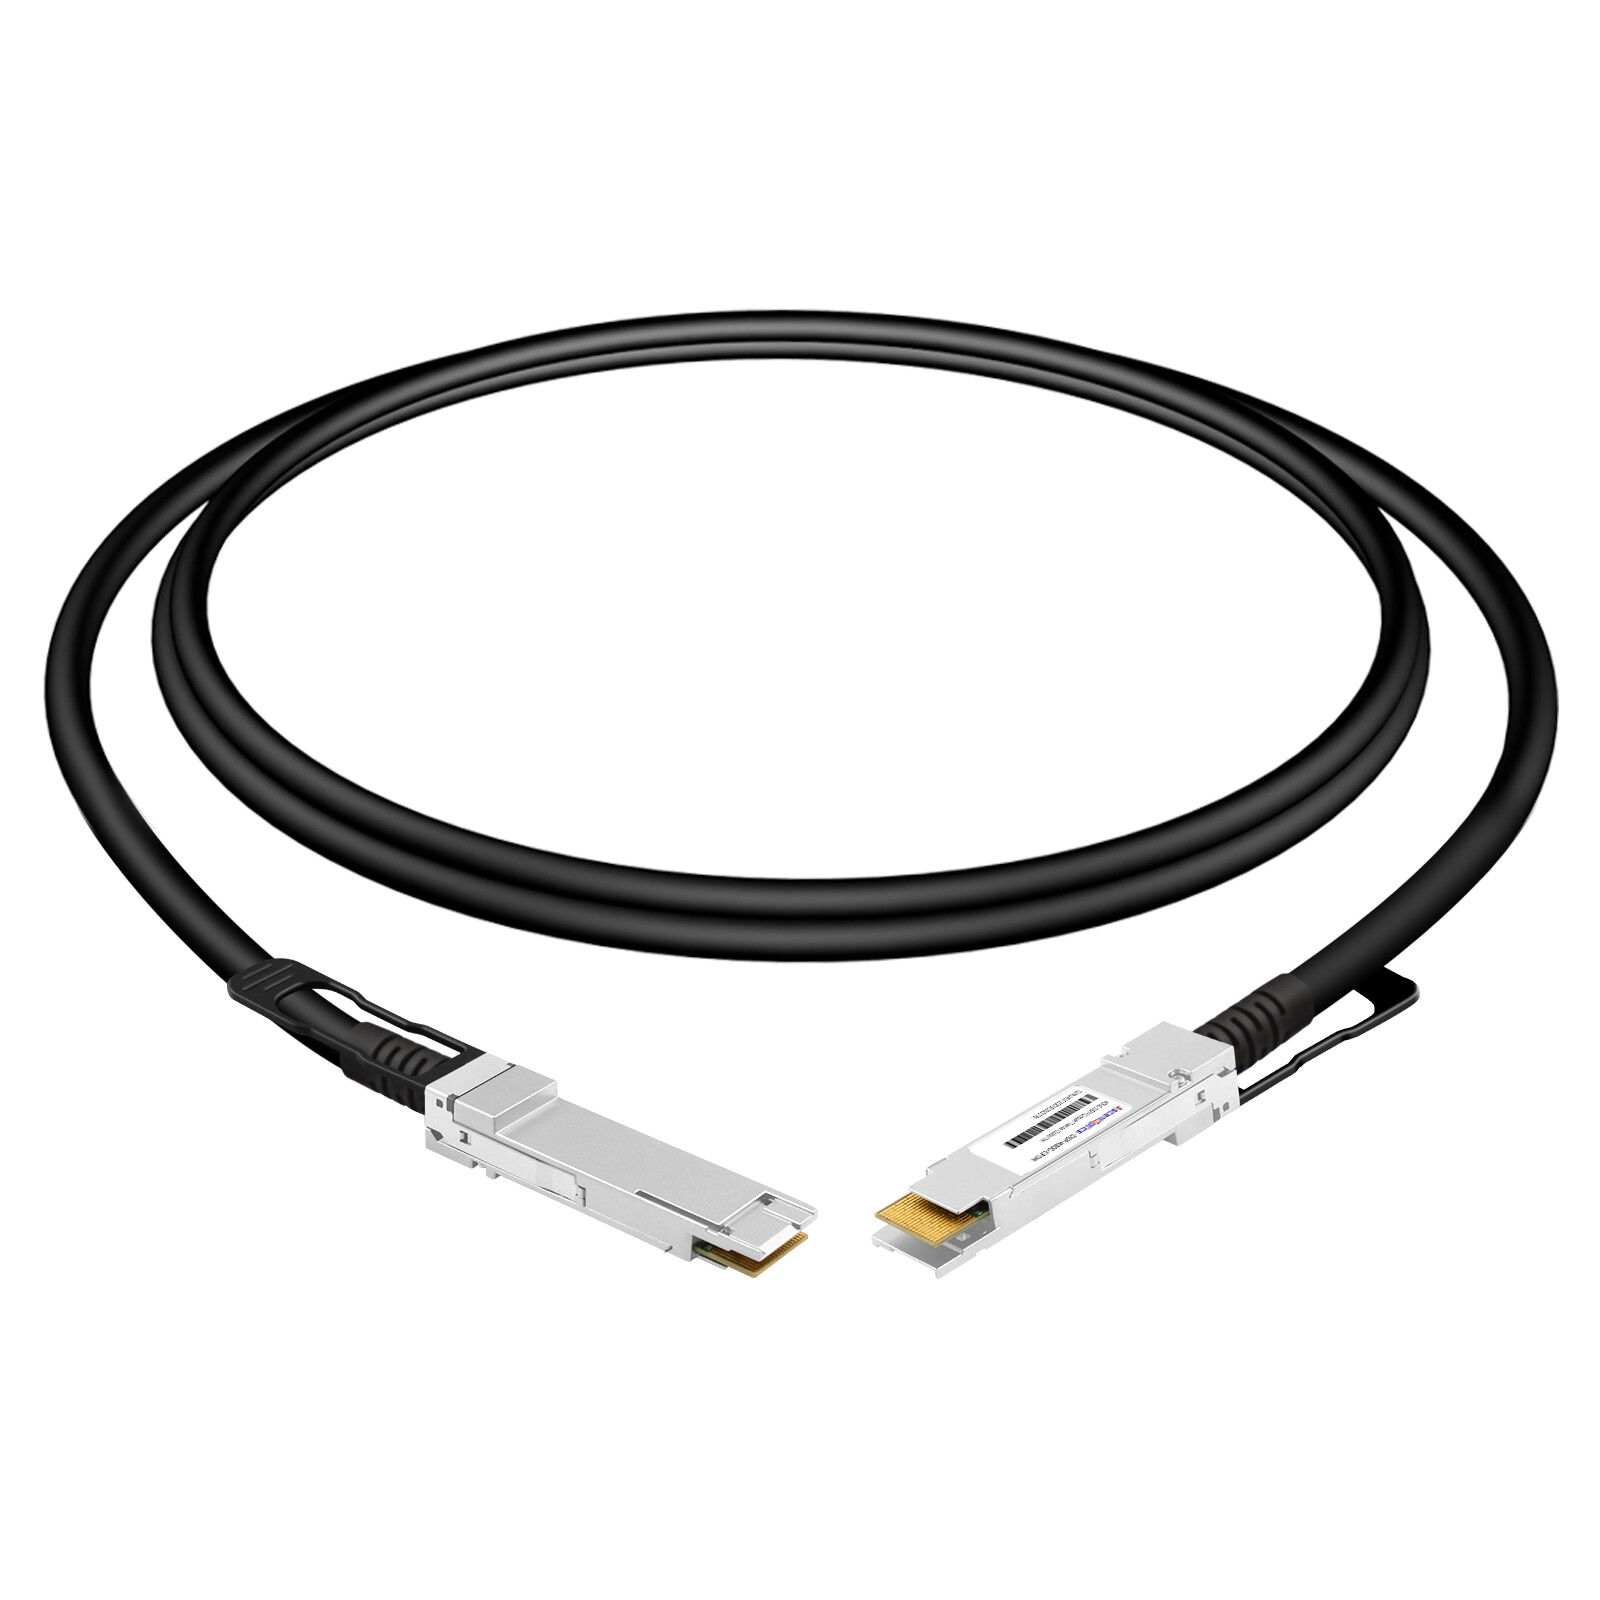
In questo contesto, le tradizionali interconnessioni di rete 100G/200G non sono più in grado di soddisfare i requisiti. I moduli ottici OSFP 400G/800G offrono una soluzione di interconnessione più compatta ed efficiente, mentre DAC (Direct Attach Cable) e AOC (Active Optical Cable) sono le opzioni preferite per le connessioni a corto raggio, ottimizzando efficacemente costi e consumi energetici. L'intelligenza artificiale non riguarda più solo l'innovazione algoritmica, ma un'attività ingegneristica a livello di sistema profondamente integrata con l'infrastruttura fisica.
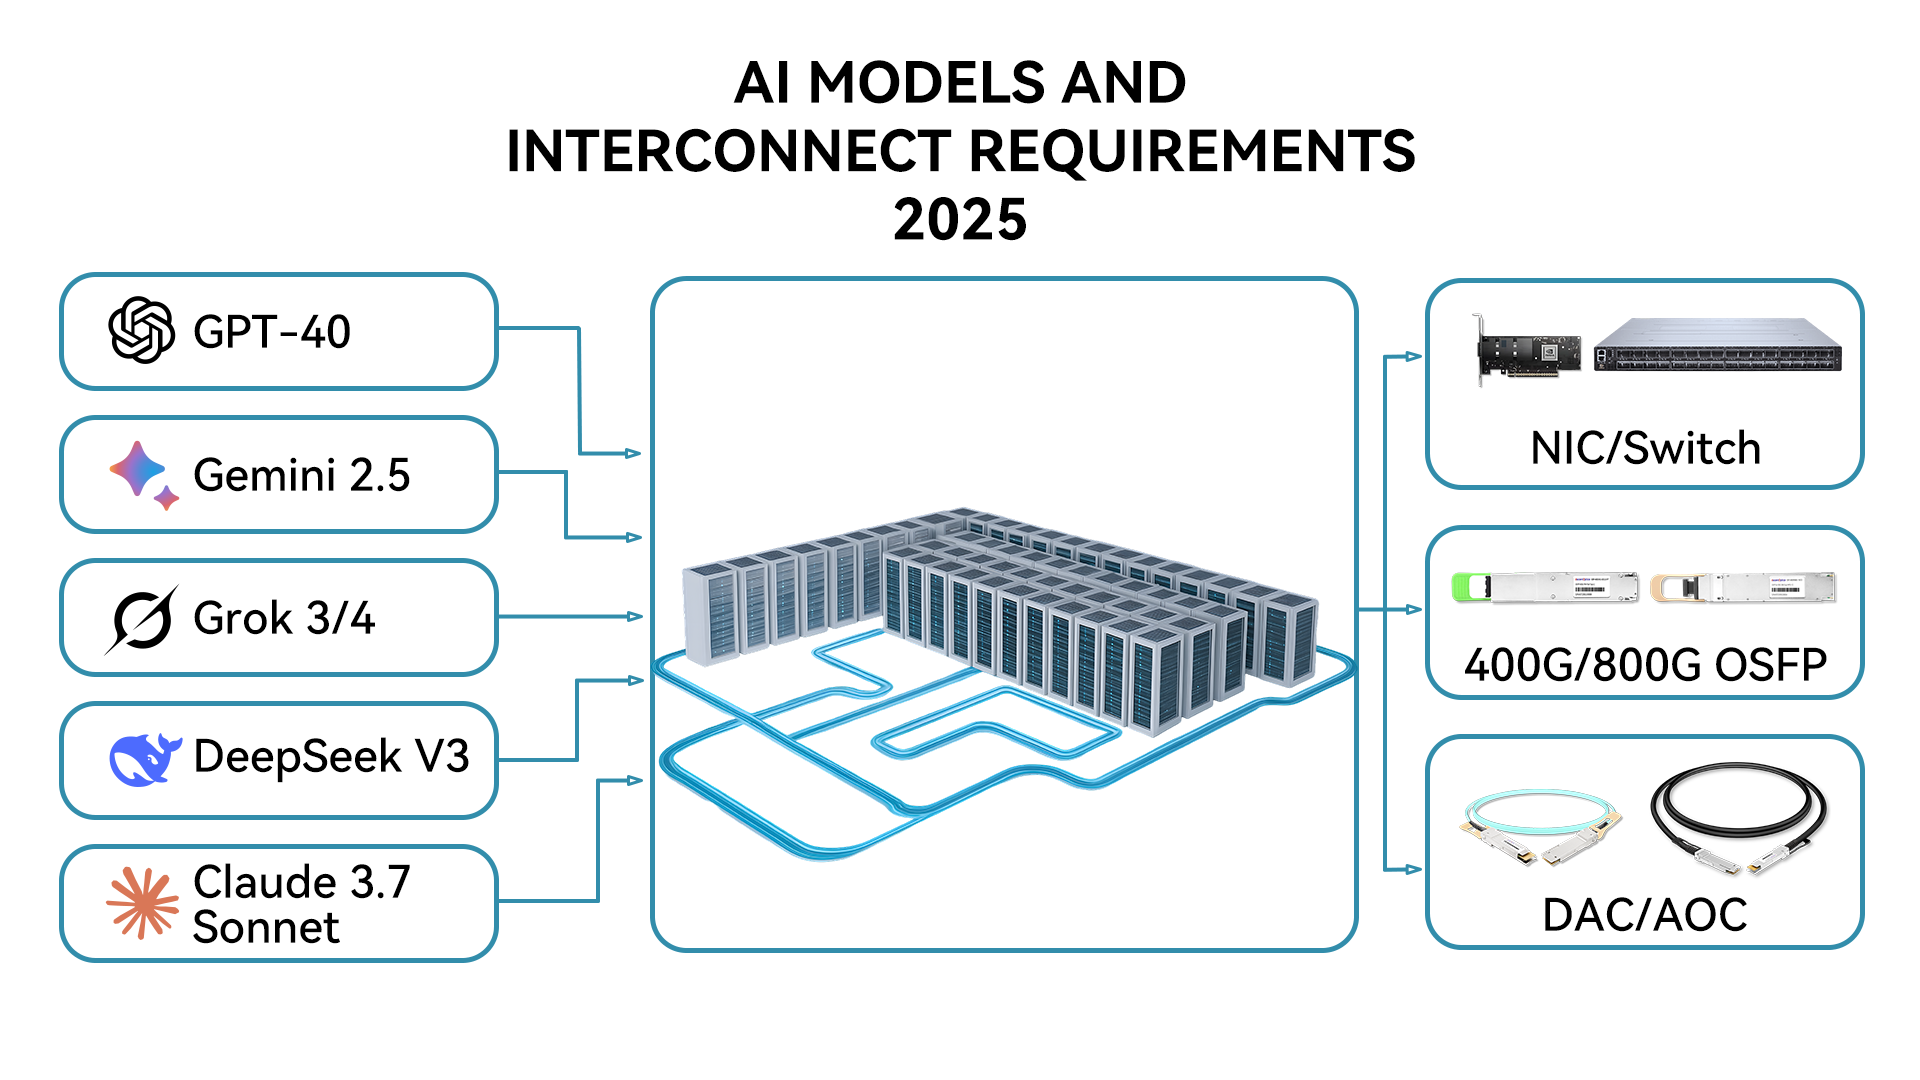
Il panorama dell'intelligenza artificiale nel 2025 è caratterizzato da versatilità e innovazione open source. Diversi modelli di riferimento evidenziano come questi progressi stiano rimodellando la domanda di interconnessione:
GPT-4o (OpenAI)
Rinomato per le sue elevate capacità di elaborazione multimodale di testo, immagini e parlato, GPT-4o si basa sull'addestramento sincronizzato su migliaia di GPU. Ogni GPU richiede uno scambio di dati a centinaia di GB/s e qualsiasi collo di bottiglia di interconnessione può prolungare significativamente i tempi di addestramento.
Claude 3.7 Sonetto (Antropico)
Specializzato in attività di codifica e ragionamento complesso, Claude 3.7 Sonnet richiede flussi di dati in tempo reale per supportare un'inferenza efficiente. Le interconnessioni a bassissima latenza sono essenziali, con moduli ottici da 800G che consentono un'efficienza energetica di circa 5 pJ/bit.
Gemelli 2.5 (Google)
Eccellendo nell'inferenza multimodale e nelle applicazioni di ricerca scientifica, Gemini 2.5 punta sull'elevata larghezza di banda e sulla comunicazione distribuita su larga scala. Le sue prestazioni dipendono in larga misura dai sistemi DWDM e dalle interconnessioni Ethernet ad alta velocità.
Grok 3/4 (xAI)
Grazie alla modalità vocale integrata e alle efficienti capacità di inferenza, Grok 3/4 viene solitamente implementato in cluster GB200. Ogni GPU richiede un'interfaccia 800GbE per ottenere prestazioni raddoppiate.
Lama 3 / DeepSeek V3 (Meta / DeepSeek)
In qualità di principali rappresentanti dei modelli open source, Llama 3 e DeepSeek V3 puntano su prestazioni elevate e personalizzazione. Il loro training distribuito si basa su interconnessioni 400G/800G, aumentando l'efficienza complessiva del 20-25%.
| Modello AI | Sviluppatore | Funzionalità principali | Requisiti di elaborazione e interconnessione |
| GPT-4o | OpenAI | Multimodale (testo, immagine, parlato); ragionamento avanzato; supporta varianti o1/o3 | Richiede la sincronizzazione di cluster GPU su larga scala, con uno scambio di dati per GPU che raggiunge centinaia di GB/s durante l'addestramento; i colli di bottiglia di interconnessione possono prolungare il tempo di addestramento di 2–3 volte. |
| Claude 3.7 Sonetto | Antropico | Forte nella codifica e nei compiti complessi; conveniente | L'inferenza si basa sullo streaming di dati in tempo reale, richiedendo interconnessioni a bassissima latenza per supportare query simultanee; l'ottica 800G può ridurre i costi energetici a circa 5 pJ/bit. |
| Gemini 2.5 | Elaborazione multimodale efficiente; ottimizzata per sviluppatori e ricerca | La formazione pone l'accento sul calcolo parallelo, con requisiti di interconnessione focalizzati sull'elevata larghezza di banda per gestire la trasmissione multi-lunghezza d'onda DWDM (Dense Wavelength Division Multiplexing). | |
| Grok 3/4 | xAI | Inferenza efficiente, supporto della modalità vocale, compatibile con l'open source | Solitamente distribuito in cluster su larga scala (ad esempio, GB200), in cui ogni GPU richiede connettività 800GbE per ottenere una scalabilità delle prestazioni pari a 2 volte. |
| Llama 3 / DeepSeek V3 | Meta / DeepSeek | Formazione open source, ad alte prestazioni e personalizzabile | La formazione distribuita si basa sulla comunicazione tra nodi, con interconnessioni 400G/800G che aumentano l'efficienza complessiva di circa il 25%. |
Questi modelli condividono una caratteristica comune: si basano su architetture Mixture of Experts (MoE) o simili, che richiedono frequenti comunicazioni All-to-All. L'addestramento di modelli ultra-grandi come GPT-4 può comportare scambi di dati a livello di petabyte e interconnessioni insufficienti possono far aumentare i costi di rete di oltre il 70%.
Al centro dell'addestramento e dell'inferenza dell'IA c'è la sincronizzazione di enormi cluster di GPU. Ad esempio, in un cluster NVIDIA GB200, ogni GPU richiede una connettività 800 GbE (2×400 GbE) per supportare la comunicazione diretta PCIe Gen6, evitando colli di bottiglia della CPU. Le principali sfide includono:
1. Moduli ottici OSFP
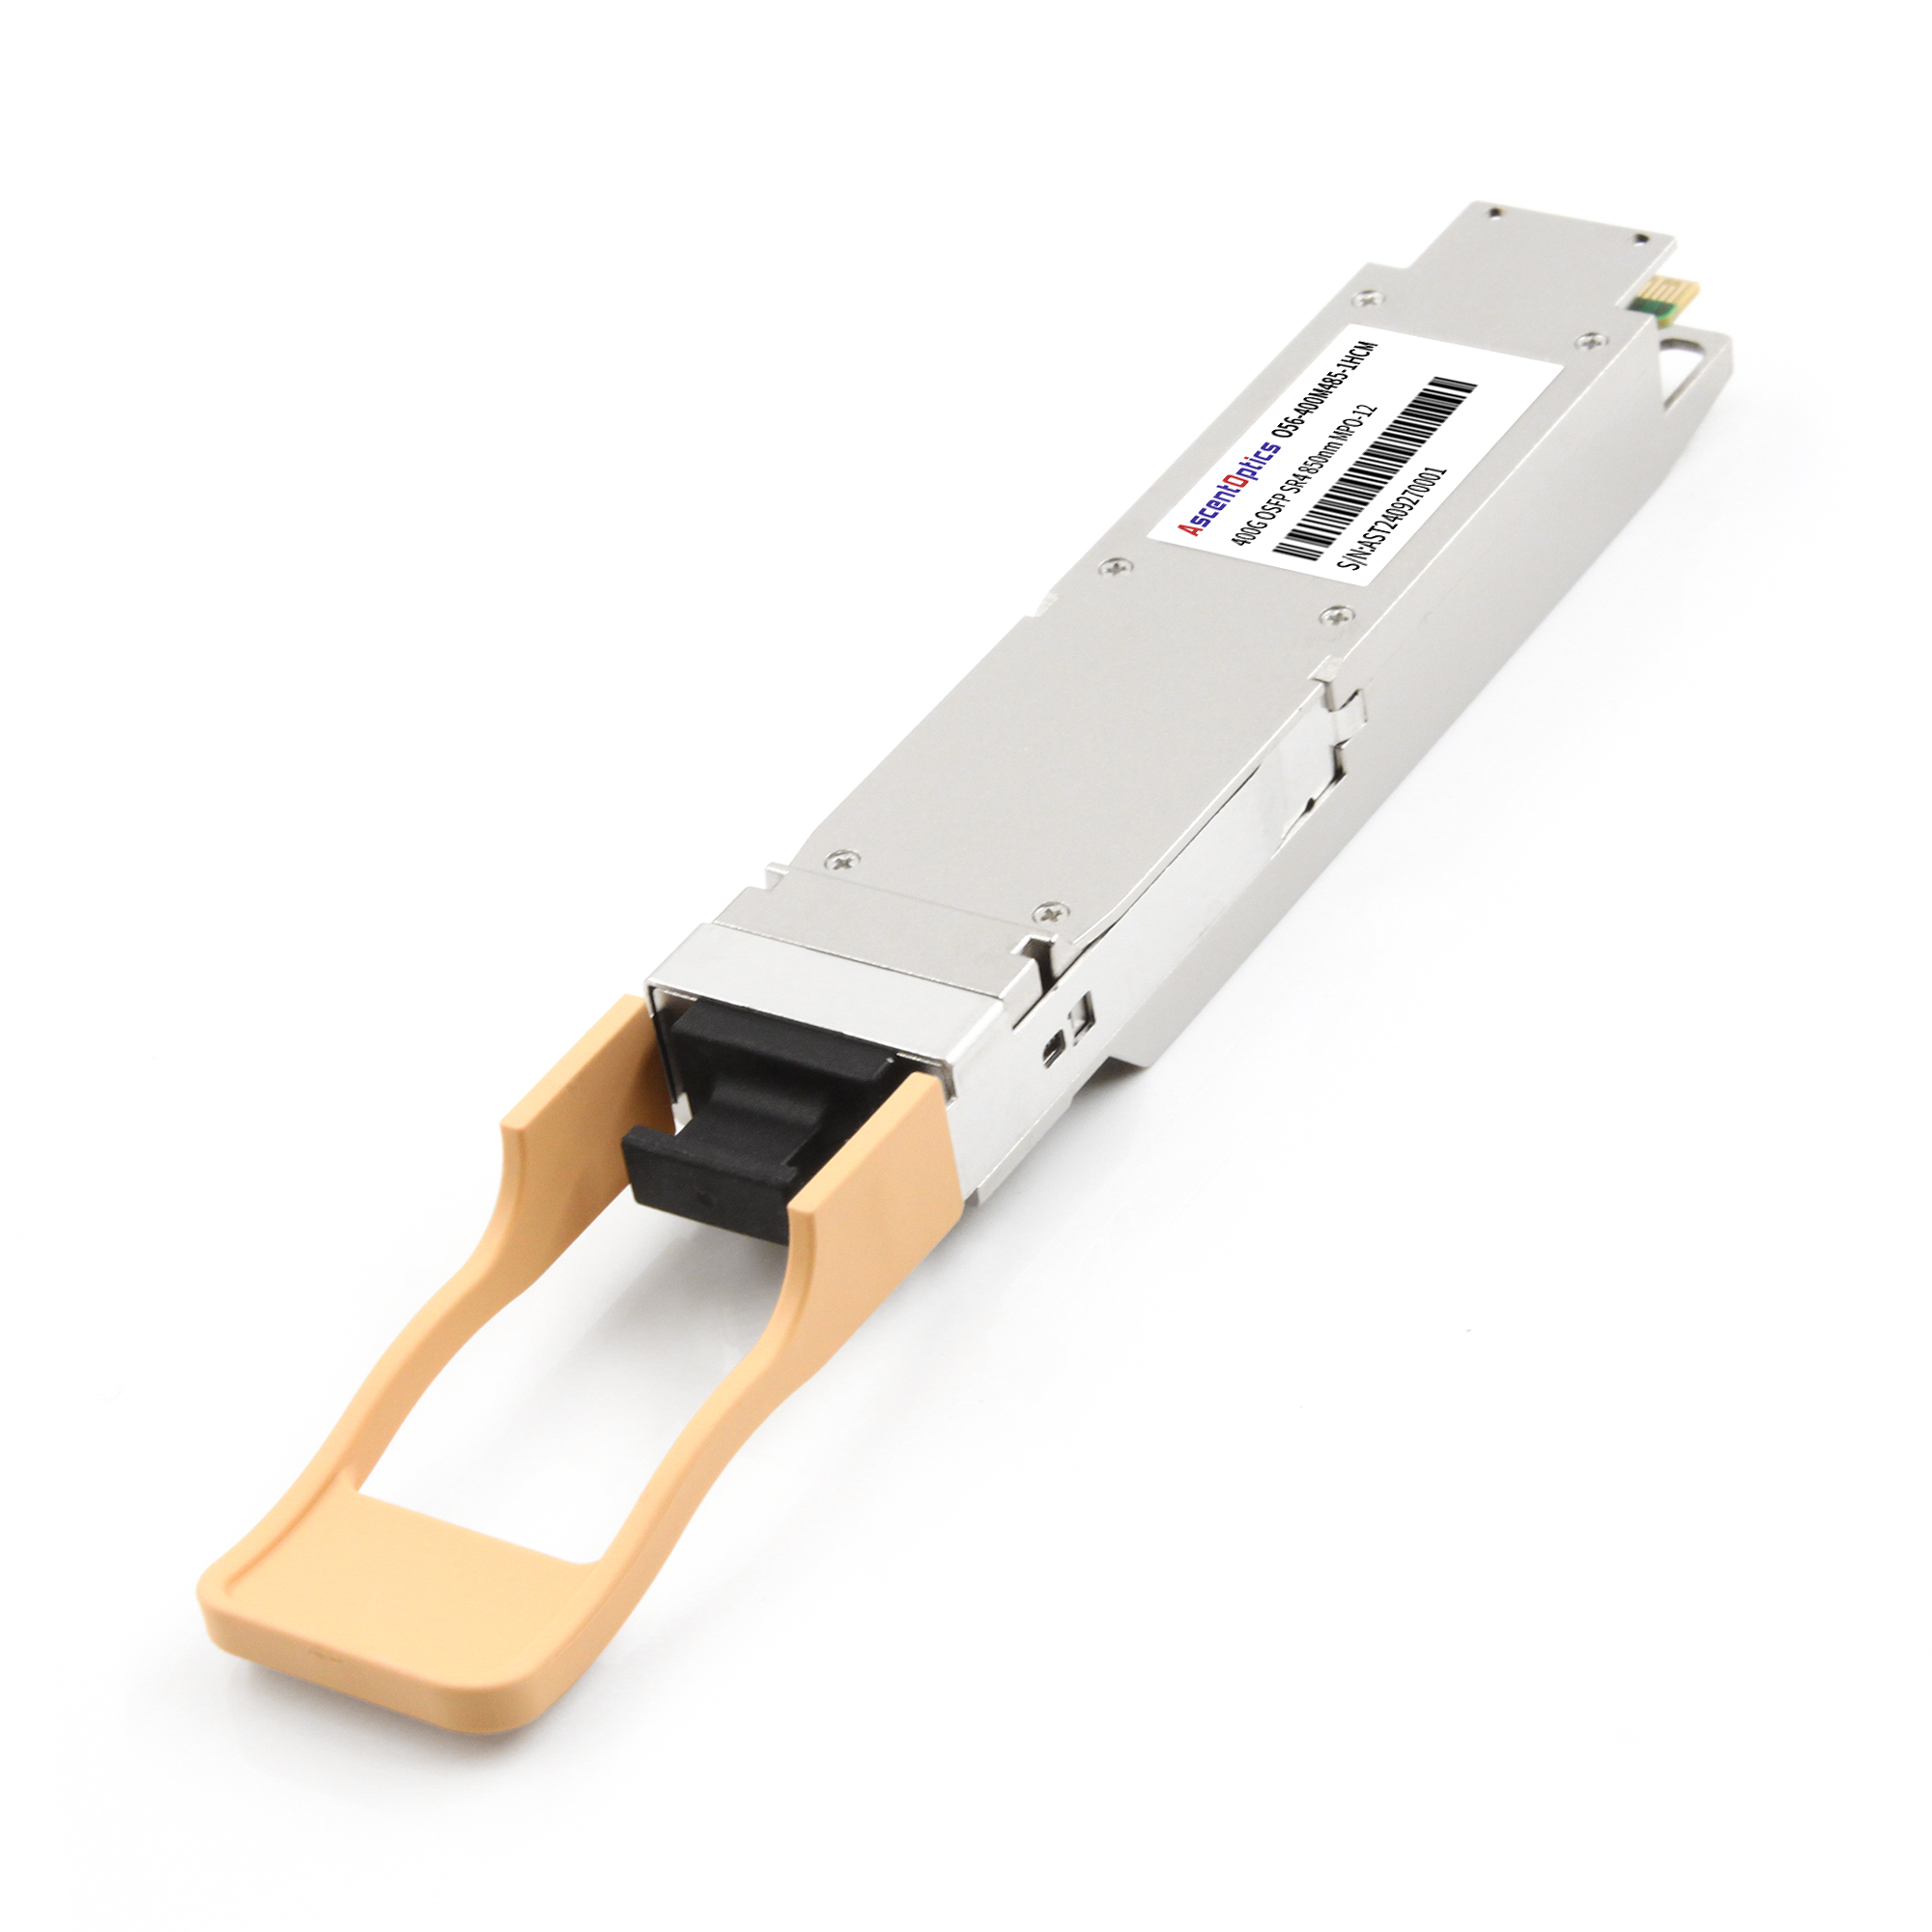
L'Optical Small Form-factor Pluggable (OSFP) supporta velocità 400G/800G e sfrutta la fotonica al silicio (SiPh) o i modulatori EML. Nelle implementazioni AI, i moduli OSFP vengono utilizzati per la trasmissione a lunga distanza (>100 m), consentendo una connettività bidirezionale fino a 4 Tbps. Ad esempio, i chipset OCI di Intel utilizzano DWDM per ottenere un basso consumo energetico (~5 pJ/bit).
2. DAC (cavo di collegamento diretto)
Una soluzione basata su rame progettata per connessioni in-rack a corto raggio (<7 m), il DAC offre un'opzione conveniente senza richiedere la conversione ottico-elettrica. Nei cluster AI, soluzioni come la scheda di rete AMD Pensando Pollara 400 utilizzano i DAC per fornire una larghezza di banda di 400 Gbps, supportando al contempo RDMA (Remote Direct Memory Access) per accelerare i trasferimenti di dati.
3. AOC (cavo ottico attivo)
Dotati di transceiver ottici integrati, gli AOC sono adatti per connessioni a media portata (7-100 m). Offrono maggiore affidabilità e contribuiscono a evitare la contaminazione delle porte. Negli ambienti di intelligenza artificiale, gli AOC sono ampiamente utilizzati per il cablaggio parallelo, supportando implementazioni di data center a 800G.
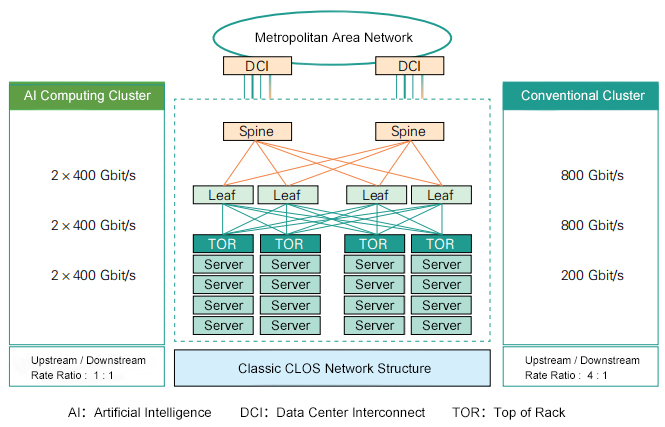
Nelle applicazioni pratiche, queste tecnologie migliorano direttamente le prestazioni dell'IA:
Fase di addestramento: ad esempio, nell'addestramento distribuito di Llama 3, vengono utilizzati moduli SR4 da 400G per garantire una comunicazione a bassa latenza tra le GPU, migliorandone l'utilizzo.
Fase di inferenza: l'elaborazione in tempo reale di Gemini 2.5 si basa su 800G AOC per raggiungere un trasferimento dati di 3200 Gbps.
Caso di studio: il cluster Stargate di OpenAI utilizza schede di rete 800GbE personalizzate, con ogni GPU dotata di 8 porte OSFP, offrendo prestazioni di rete doppie. La scheda di rete Vulcano di AMD fornisce una velocità di trasmissione di 800 Gbps e supporta lo standard UC 1.0.
Open source e scalabilità: ad esempio, DeepSeek V3 sfrutta RDMA per ottimizzare le interconnessioni, riducendo i costi di bridging.
Nelle implementazioni pratiche, queste tecnologie di interconnessione vengono spesso utilizzate in combinazione: DAC e AOC sono più adatte per connessioni a breve distanza all'interno o tra rack adiacenti, offrendo costi contenuti, bassa latenza e cablaggio semplificato su larga scala. I moduli ottici OSFP, invece, vengono utilizzati principalmente per connessioni inter-rack o persino inter-data hall, offrendo maggiore larghezza di banda, stabilità e scalabilità su lunghe distanze. Questo approccio a più livelli consente ai data center di bilanciare costi, consumi energetici e prestazioni, supportando così le esigenze di training e inferenza dei cluster di intelligenza artificiale su larga scala.
In sintesi, l'integrazione di tecnologie di interconnessione ad alta velocità con modelli di intelligenza artificiale avanzati sta plasmando la prossima era dell'innovazione nei data center. Combinare i più recenti modelli di intelligenza artificiale con interconnessioni 400G/800G non solo dimostra la sinergia tecnologica, ma evidenzia anche il ruolo cruciale dell'infrastruttura nell'ecosistema dell'intelligenza artificiale. La tecnologia di interconnessione non è solo un fattore abilitante dell'intelligenza artificiale, ma è la pietra angolare del suo futuro sviluppo.