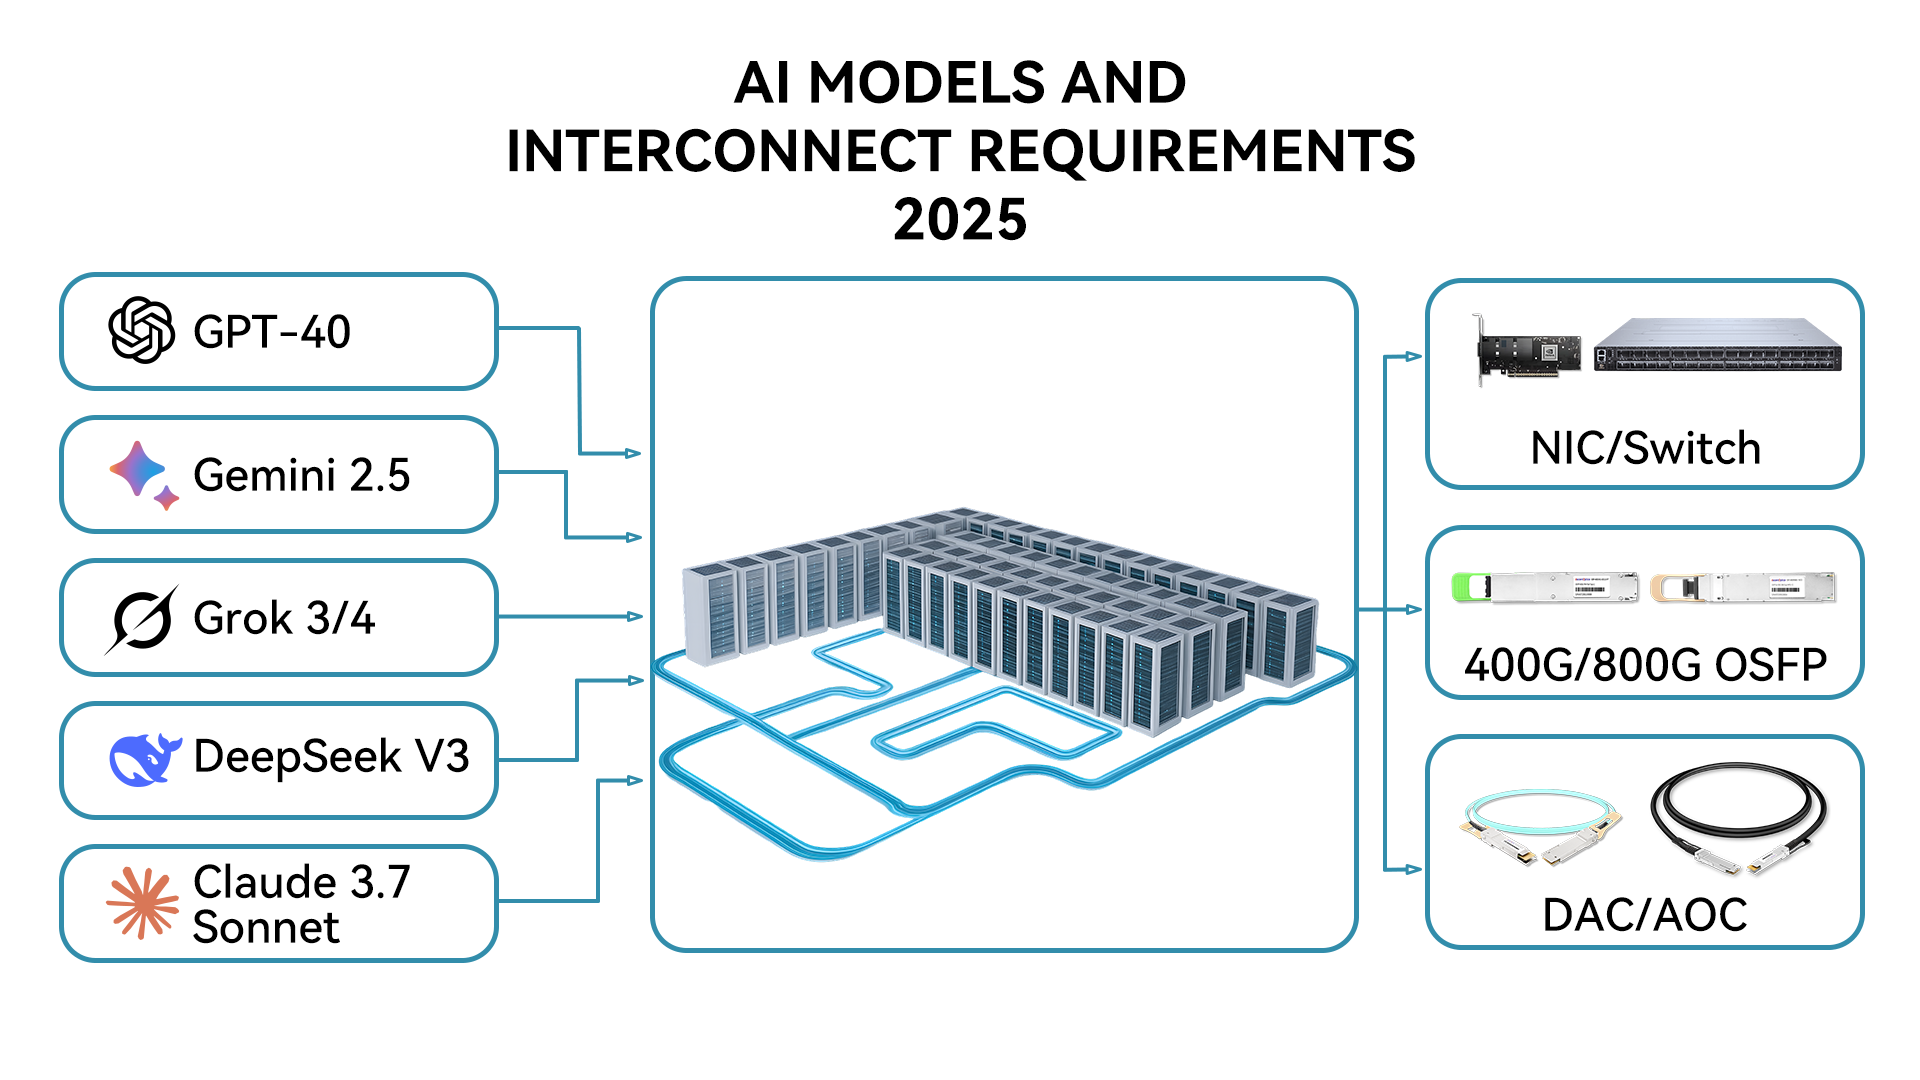
در سال ۲۰۲۵، توسعه سریع هوش مصنوعی (AI) در حال تغییر شکل معماری مراکز داده است. از مدلهای زبانی بزرگ چندوجهی گرفته تا چارچوبهای باز و کارآمد، هوش مصنوعی به نیروی محرکه اصلی نوآوری تبدیل شده است. مقیاس مدلهای هوش مصنوعی از صدها میلیون پارامتر به سطح تریلیون در حال گسترش است، و آموزش شامل هزاران یا حتی دهها هزار پردازنده گرافیکی به صورت موازی است. به عنوان مثال، GPT-4o شرکت OpenAI و مدلهای مشابه آن برای امکان استنتاج و آموزش کارآمد، به همگامسازی دادهها در زمان واقعی نیاز دارند. این امر نه تنها به توان عملیاتی دادهها در سطح ترابایت بر ثانیه نیاز دارد، بلکه به تأخیر در سطح میکروثانیه و قابلیت اطمینان بالا برای از بین بردن هرگونه گلوگاه نیز نیاز دارد.
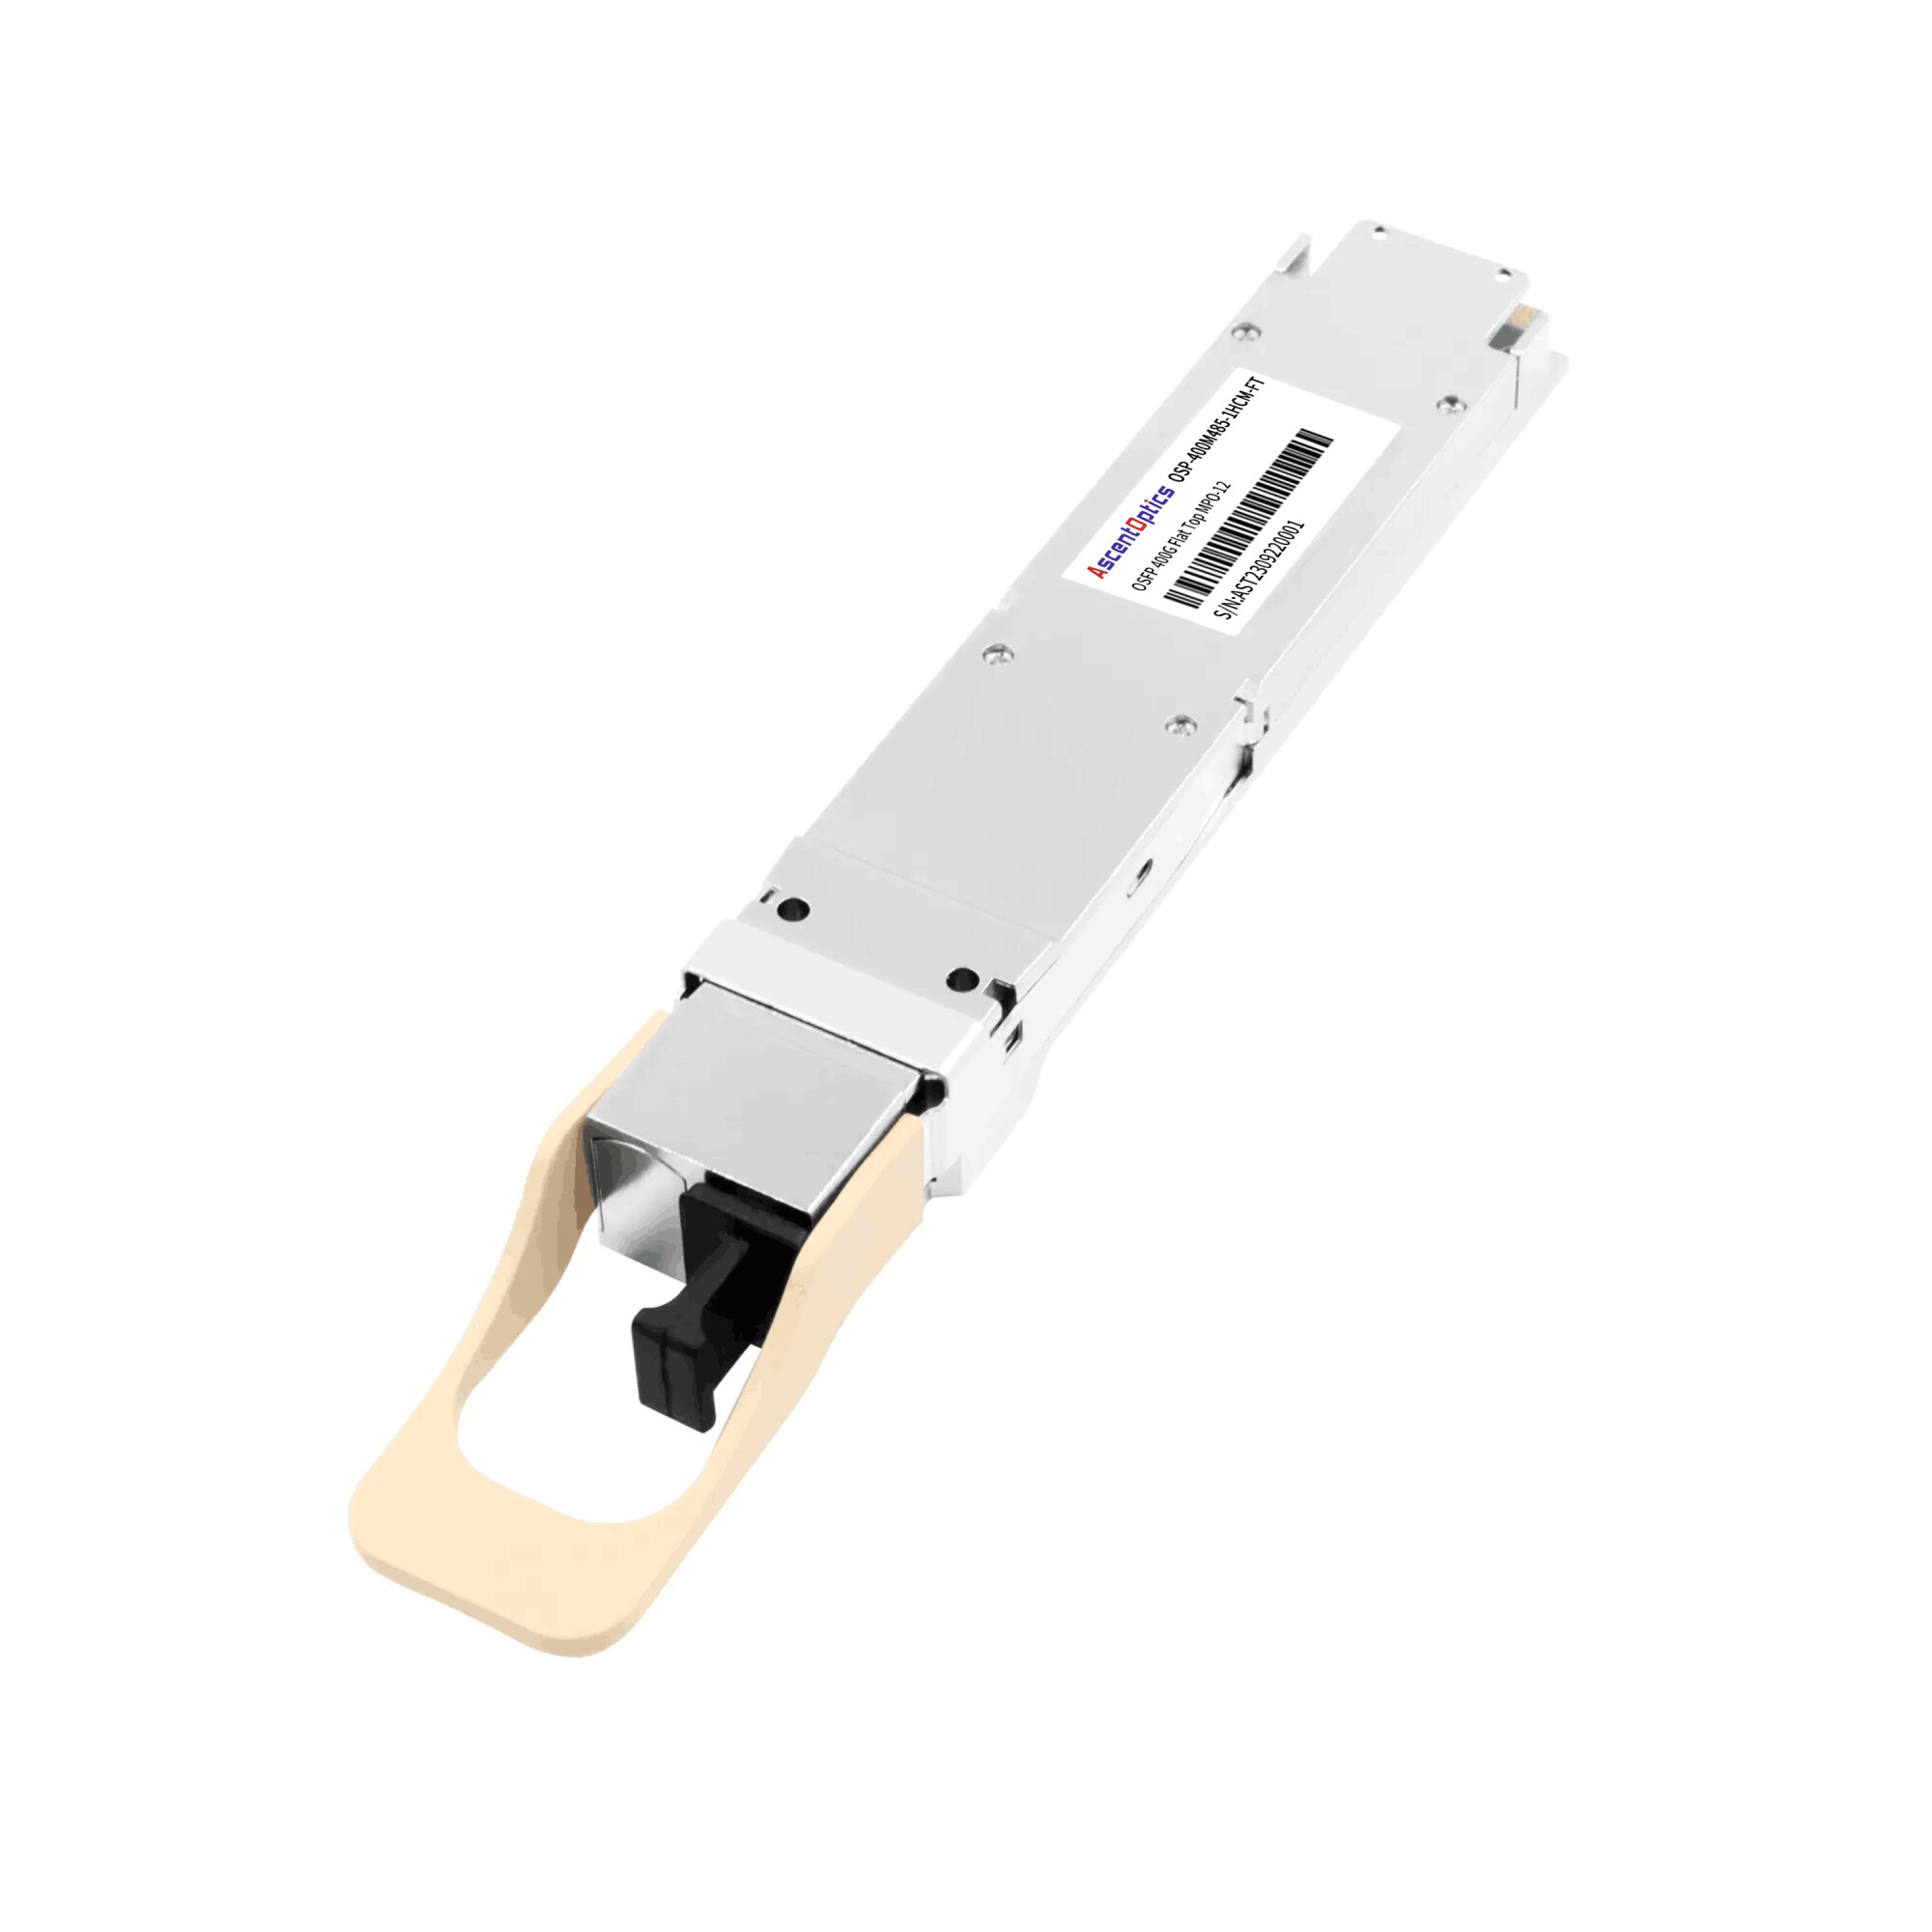
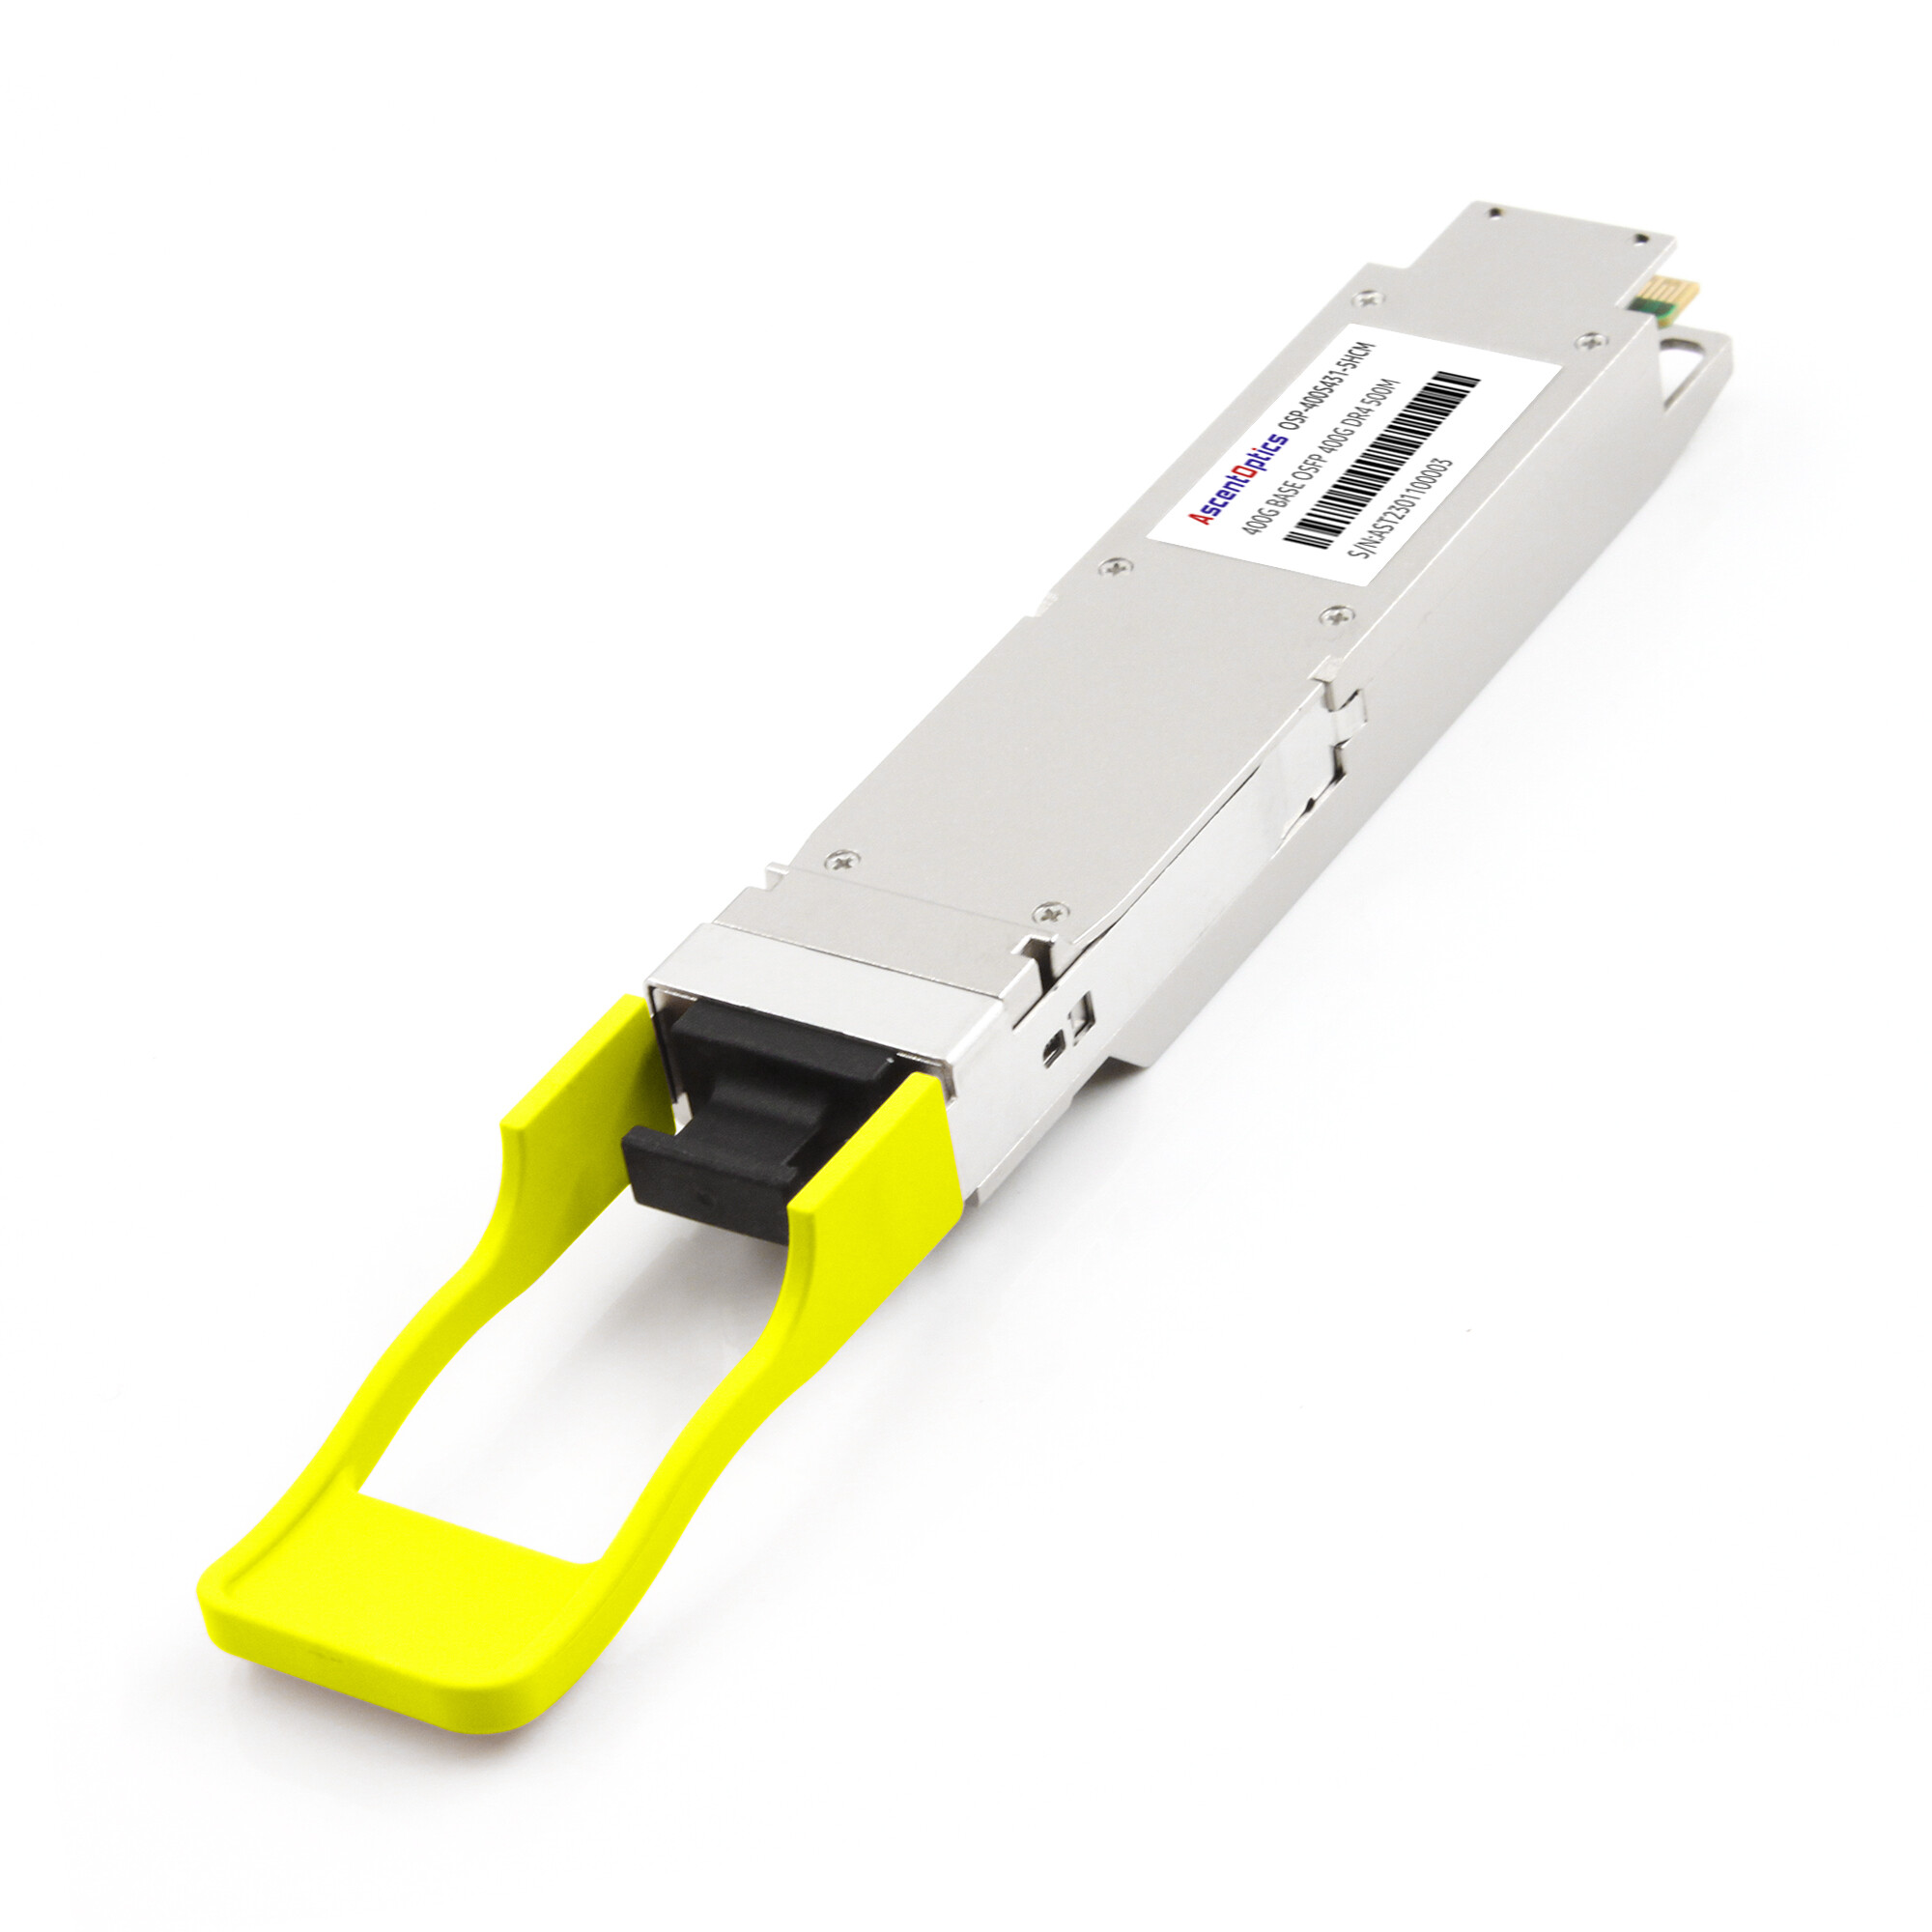
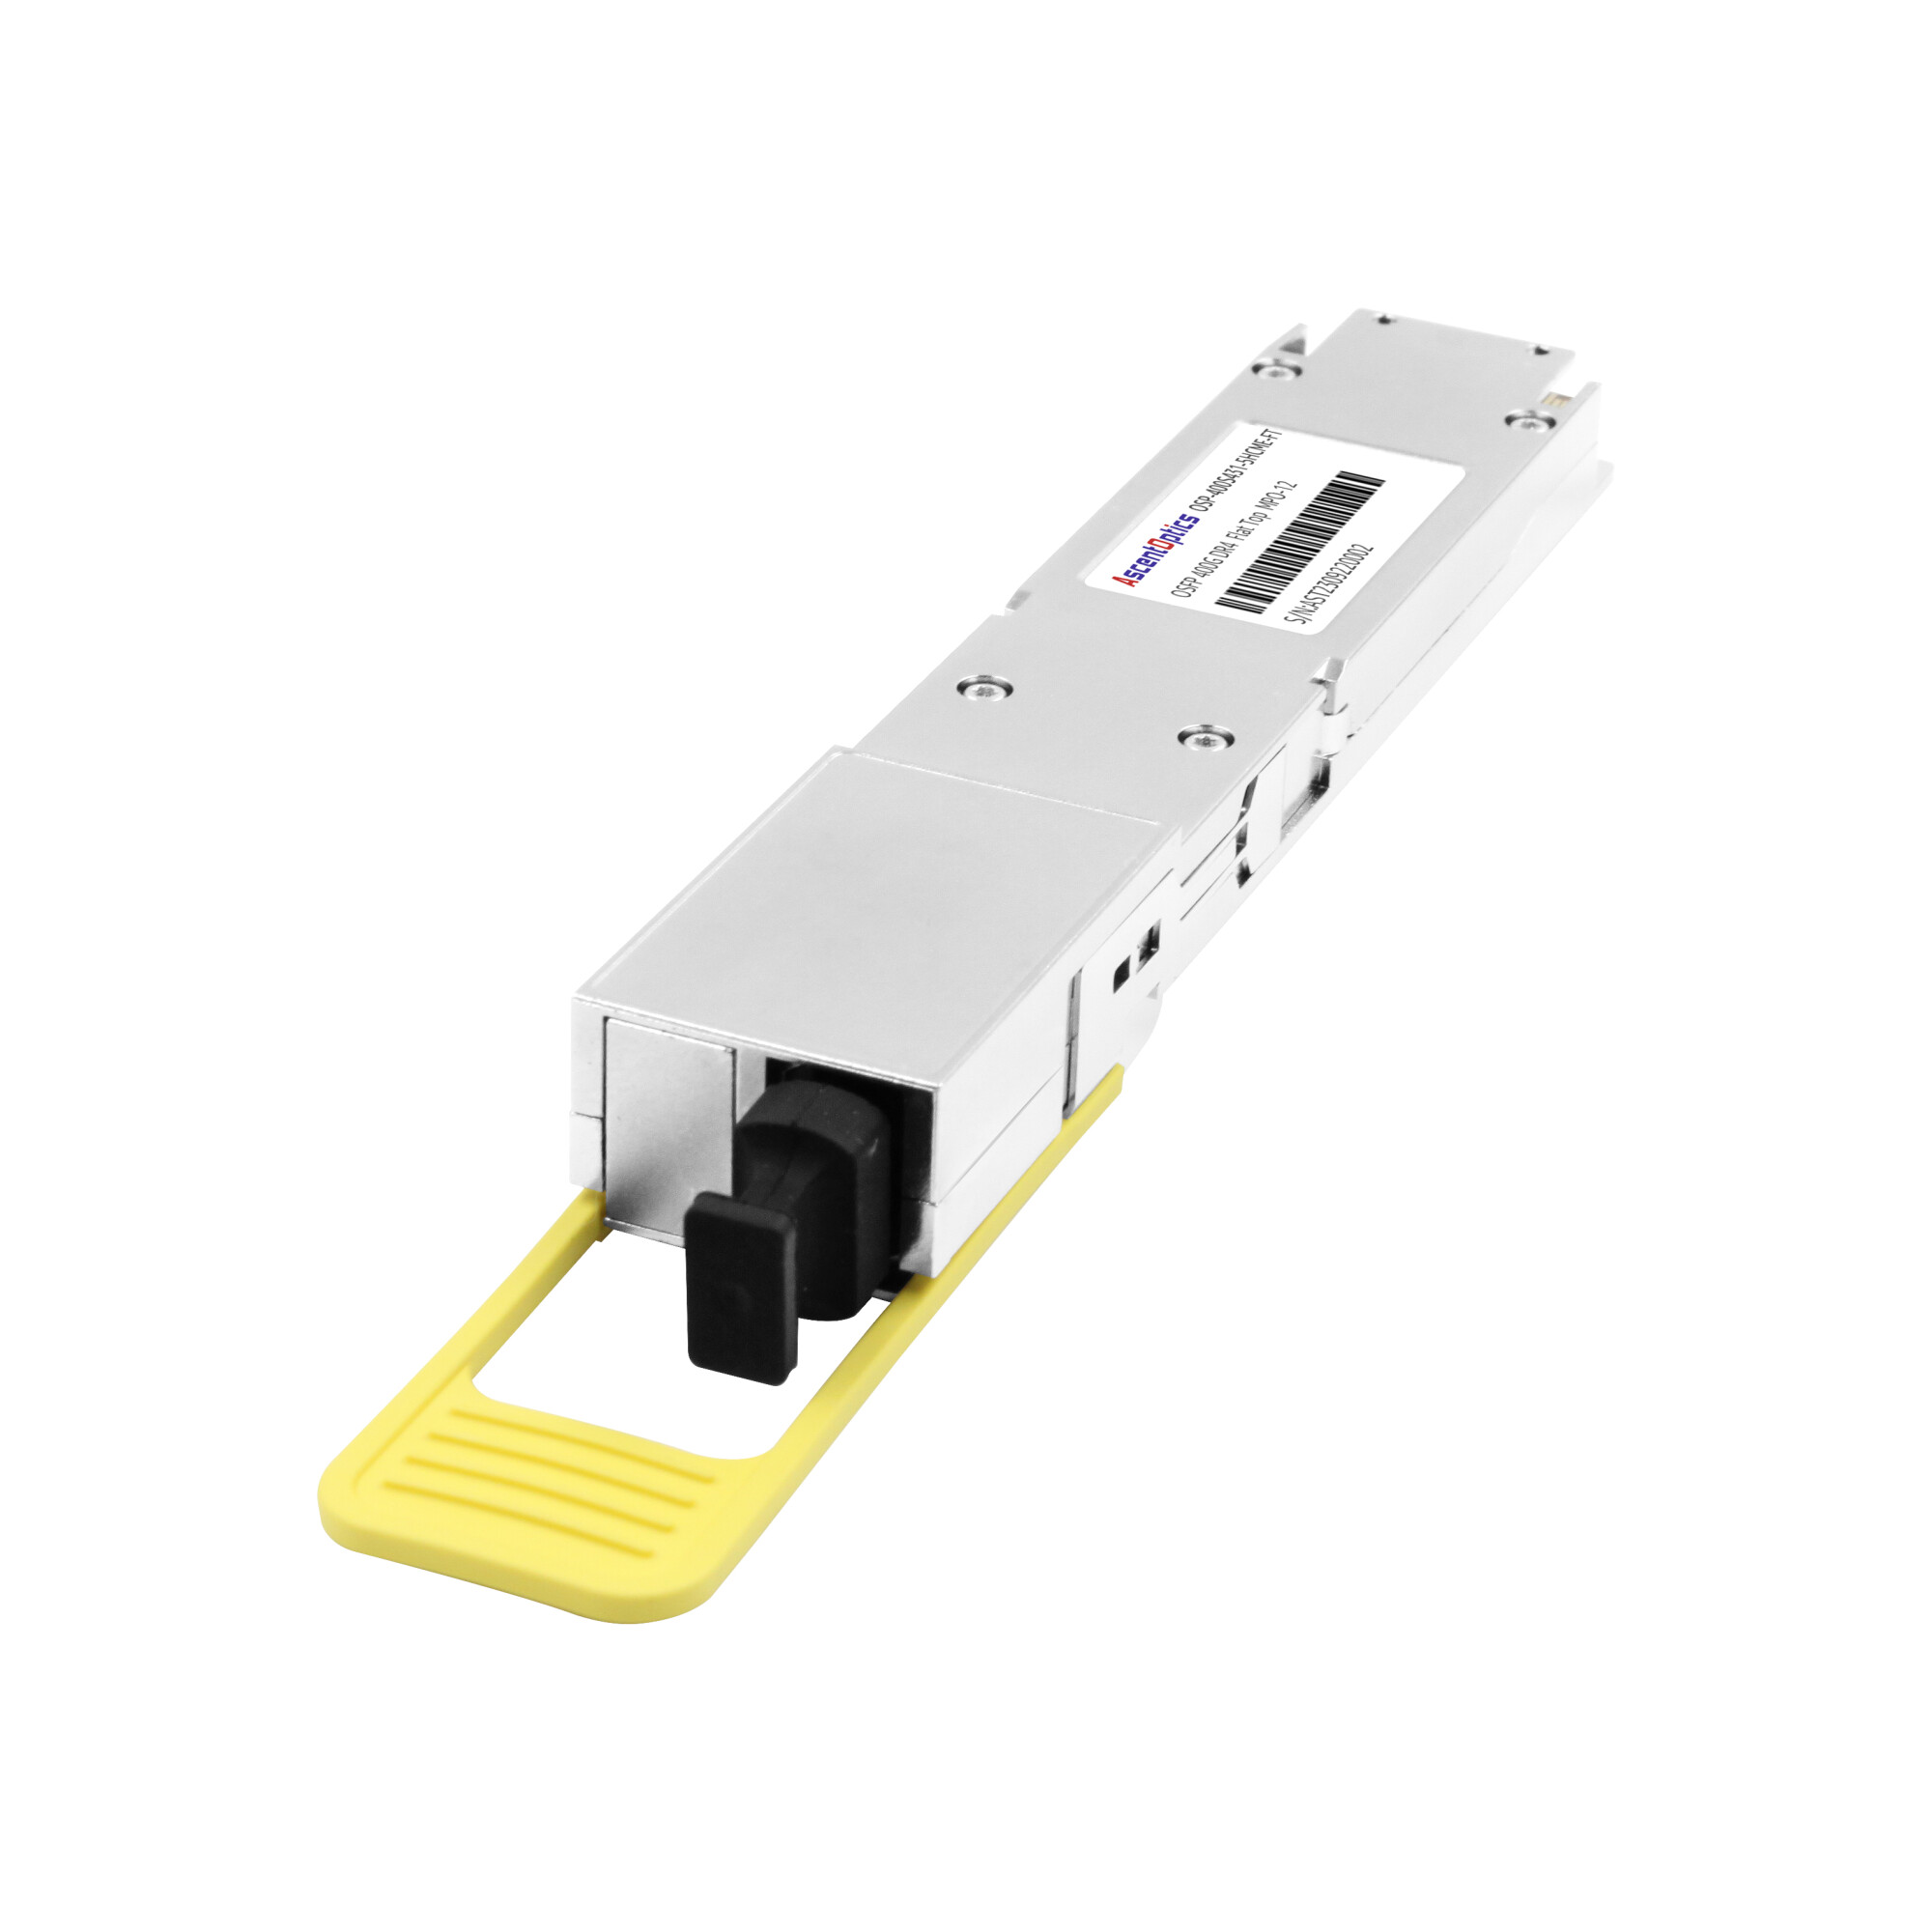
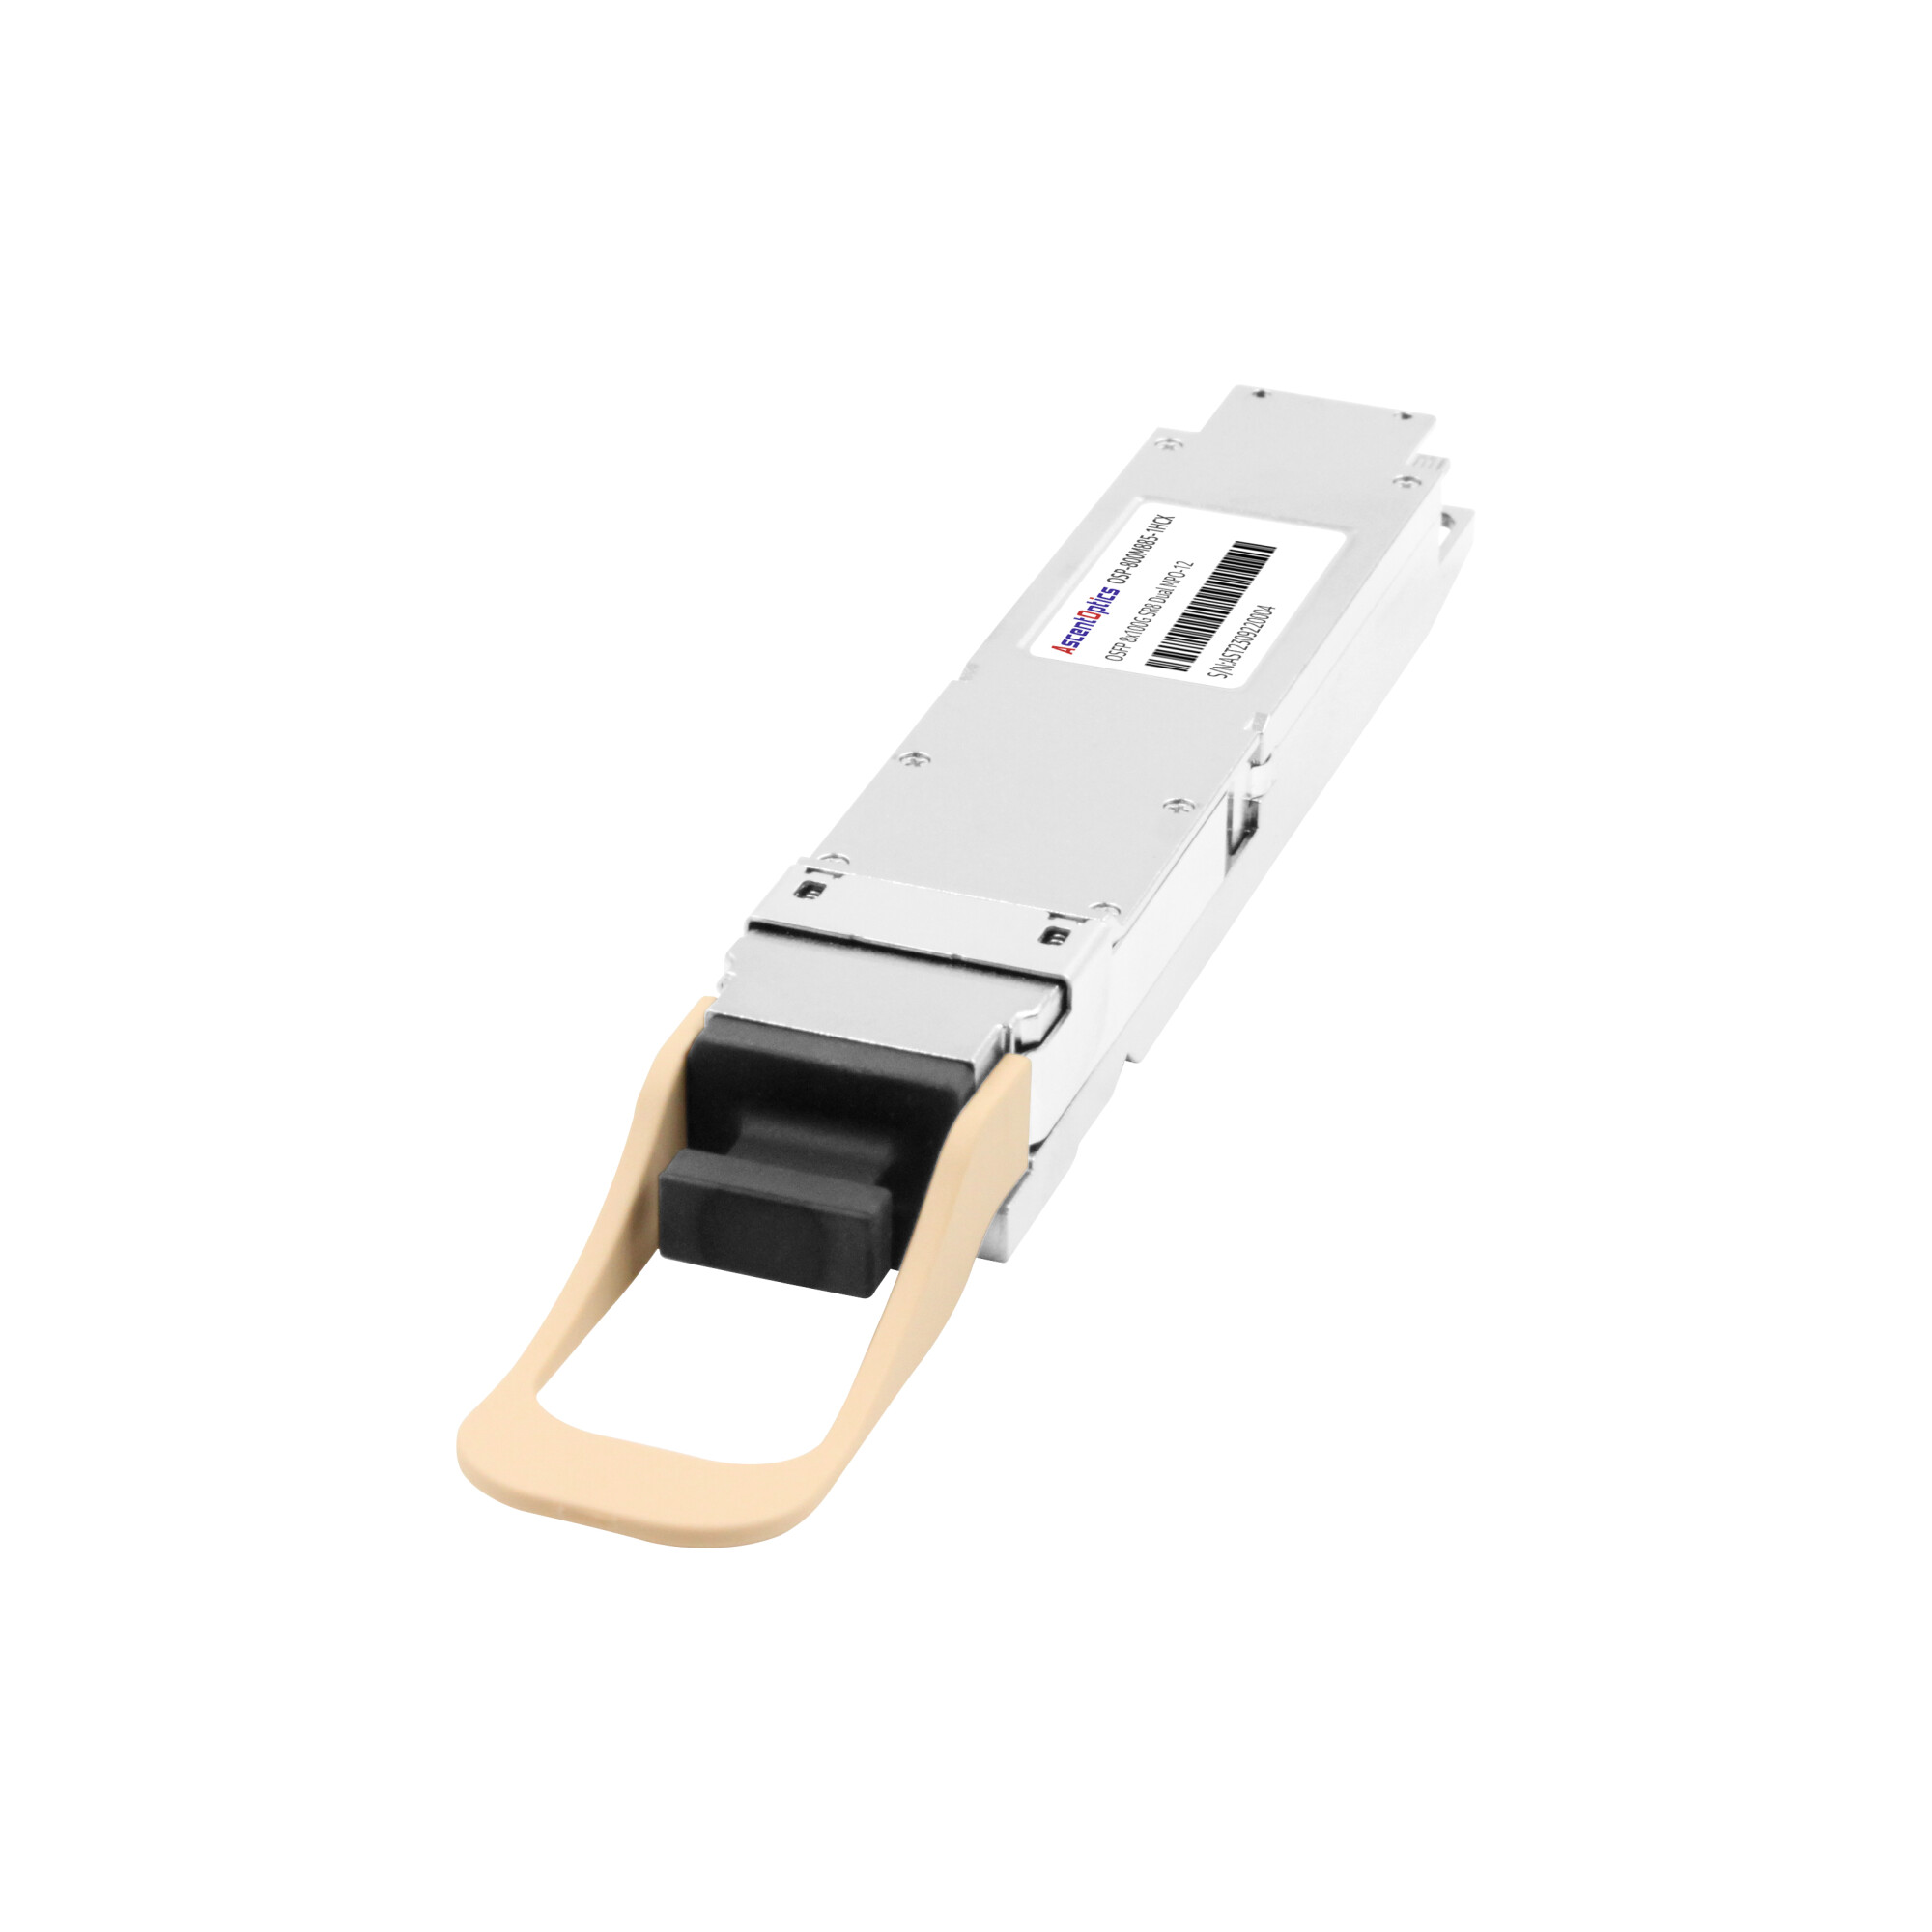
در این زمینه، اتصالات شبکه سنتی 100G/200G دیگر نمیتوانند الزامات را برآورده کنند. ماژولهای نوری OSFP 400G/800G یک راهکار اتصال فشردهتر و کارآمدتر ارائه میدهند، در حالی که DAC (کابل اتصال مستقیم) و AOC (کابل نوری فعال) گزینههای ارجح برای اتصالات کوتاهبرد هستند که به طور موثر هزینه و مصرف برق را بهینه میکنند. هوش مصنوعی دیگر فقط مربوط به نوآوری الگوریتمی نیست، بلکه یک تلاش مهندسی در سطح سیستم است که عمیقاً با زیرساختهای فیزیکی ادغام شده است.
مروری بر جدیدترین مدلهای هوش مصنوعی و نیازهای محاسباتی آنها
چشمانداز هوش مصنوعی در سال ۲۰۲۵ با تطبیقپذیری و نوآوری متنباز تعریف میشود. چندین مدل پیشرو نشان میدهند که چگونه این پیشرفتها، تقاضا برای اتصال متقابل را تغییر میدهند:
GPT-4o (اوپنایآی)
GPT-4o که به خاطر قابلیتهای پردازش چندوجهی قوی خود در متن، تصویر و گفتار مشهور است، به آموزش همزمان در هزاران پردازنده گرافیکی (GPU) متکی است. هر پردازنده گرافیکی نیاز به تبادل داده با سرعت صدها گیگابایت بر ثانیه دارد و هرگونه تنگنای اتصال داخلی میتواند زمان آموزش را به طور قابل توجهی طولانی کند.
غزل کلود ۳.۷ (انسانگرایانه)
Claude 3.7 Sonnet که در کدنویسی و وظایف استدلال پیچیده تخصص دارد، برای حفظ استنتاج کارآمد، به جریانهای داده بلادرنگ نیاز دارد. اتصالات داخلی با تأخیر بسیار کم ضروری هستند، به طوری که ماژولهای نوری ۸۰۰G بهرهوری انرژی را در حدود ۵ پیکوژول بر بیت امکانپذیر میسازند.
جمینی ۲.۵ (گوگل)
Gemini 2.5 که در استنتاج چندوجهی و کاربردهای تحقیقات علمی سرآمد است، بر پهنای باند بالا و ارتباطات توزیعشده در مقیاس بزرگ تأکید دارد. عملکرد آن به شدت به سیستمهای DWDM و اتصالات اترنت پرسرعت وابسته است.
گروک ۳/۴ (xAI)
با حالت صوتی داخلی و قابلیتهای استنتاج کارآمد، Grok 3/4 معمولاً در کلاسترهای GB200 مستقر میشود. هر پردازنده گرافیکی برای دستیابی به عملکرد دو برابر به یک رابط 800GbE نیاز دارد.
Llama 3 / DeepSeek V3 (Meta / DeepSeek)
به عنوان نمایندگان برجسته مدلهای متنباز، Llama 3 و DeepSeek V3 بر عملکرد بالا و قابلیت سفارشیسازی تأکید دارند. آموزش توزیعشده آنها به اتصالات 400G/800G وابسته است و کارایی کلی را 20 تا 25 درصد افزایش میدهد.
مدل هوش مصنوعی
توسعه دهنده
ویژگی های کلیدی
الزامات محاسبه و اتصال
GPT-4o
OpenAI
چندوجهی (متن، تصویر، گفتار)؛ استدلال پیشرفته؛ از انواع o1/o3 پشتیبانی میکند
نیاز به همگامسازی خوشههای GPU در مقیاس بزرگ دارد، به طوری که تبادل داده به ازای هر GPU در طول آموزش به صدها گیگابایت بر ثانیه میرسد؛ گلوگاههای اتصال داخلی میتوانند زمان آموزش را ۲ تا ۳ برابر افزایش دهند.
غزل کلود 3.7
آنتروپیک
قوی در کدنویسی و کارهای پیچیده؛ مقرون به صرفه
استنتاج به جریانسازی دادههای بلادرنگ متکی است و برای پشتیبانی از پرسوجوهای همزمان، به اتصالات داخلی با تأخیر بسیار کم نیاز دارد؛ اپتیک ۸۰۰G میتواند هزینه انرژی را تا حدود ۵ پیکوژول بر بیت کاهش دهد.
جوزا 2.5
گوگل
پردازش چندوجهی کارآمد؛ بهینه شده برای توسعهدهندگان و محققان
آموزش بر محاسبات موازی تأکید دارد و الزامات اتصال داخلی بر پهنای باند بالا برای مدیریت انتقال چند طول موجی DWDM (مالتیپلکسینگ تقسیم طول موج متراکم) متمرکز است.
گروک ۳/۴
xAI
استنتاج کارآمد، پشتیبانی از حالت صوتی، متنباز و کاربرپسند
معمولاً در کلاسترهای بزرگ (مثلاً GB200) مستقر میشوند، که در آن هر پردازنده گرافیکی برای دستیابی به مقیاسبندی عملکرد ۲ برابر به اتصال ۸۰۰ گیگابیت اترنت نیاز دارد.
لاما ۳ / دیپسیک V3
متا / جستجوی عمیق
آموزش متنباز، با کارایی بالا و قابل تنظیم
آموزش توزیعشده به ارتباط بین گرهها وابسته است، و اتصالات 400G/800G راندمان کلی را حدود 25٪ افزایش میدهند.
این مدلها یک ویژگی مشترک دارند: آنها به معماری ترکیبی از متخصصان (MoE) یا معماریهای مشابه متکی هستند که نیاز به ارتباط مکرر همهجانبه دارند. آموزش مدلهای بسیار بزرگ مانند GPT-4o ممکن است شامل تبادل داده در سطح پتابایت باشد و اتصالات ناکافی میتوانند هزینههای شبکه را بیش از 70 درصد افزایش دهند.
چالشهای اتصال متقابل در محاسبات هوش مصنوعی
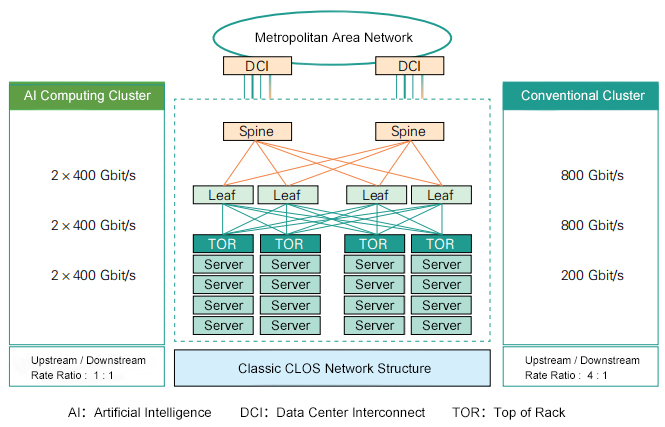
در هسته آموزش و استنتاج هوش مصنوعی، همگامسازی خوشههای عظیم پردازندههای گرافیکی (GPU) قرار دارد. به عنوان مثال، در یک خوشه NVIDIA GB200، هر پردازنده گرافیکی برای پشتیبانی از ارتباط مستقیم PCIe Gen800 و جلوگیری از گلوگاههای پردازنده، به اتصال 2GbE (400×6GbE) نیاز دارد. چالشهای اصلی عبارتند از:
تقاضای بالای پهنای باندحجم کاری هوش مصنوعی برای همگامسازی پارامترهای مدل به ترابایتها در ثانیه انتقال داده نیاز دارد.
تأخیر بسیار کموظایف استنتاج، مانند تولید کد با مدلهایی مانند کلود، به پاسخ در سطح میکروثانیه نیاز دارند. حتی تأخیرهای کوچک میتوانند زمان آموزش را دو برابر کنند.
مقیاس پذیری: از صدها تا دهها هزار پردازنده گرافیکی، که نیاز به پشتیبانی از شبکههای Rail-Only دارند، که در آنها اتصالات فقط بین گرههای ضروری برقرار میشود.
بهره وری انرژی و هزینه: مراکز داده هوش مصنوعی مقدار زیادی برق مصرف میکنند و بهبود راندمان اتصال میتواند تا 50٪ در مصرف انرژی صرفهجویی کند.
راهکارهای کلیدی اتصال متقابل برای هوش مصنوعی: OSFP، DAC و AOC
۱. ماژولهای نوری OSFP
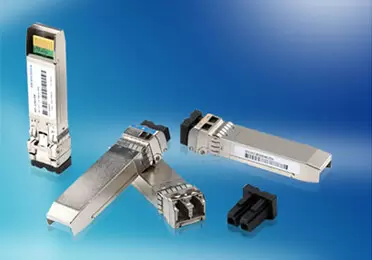
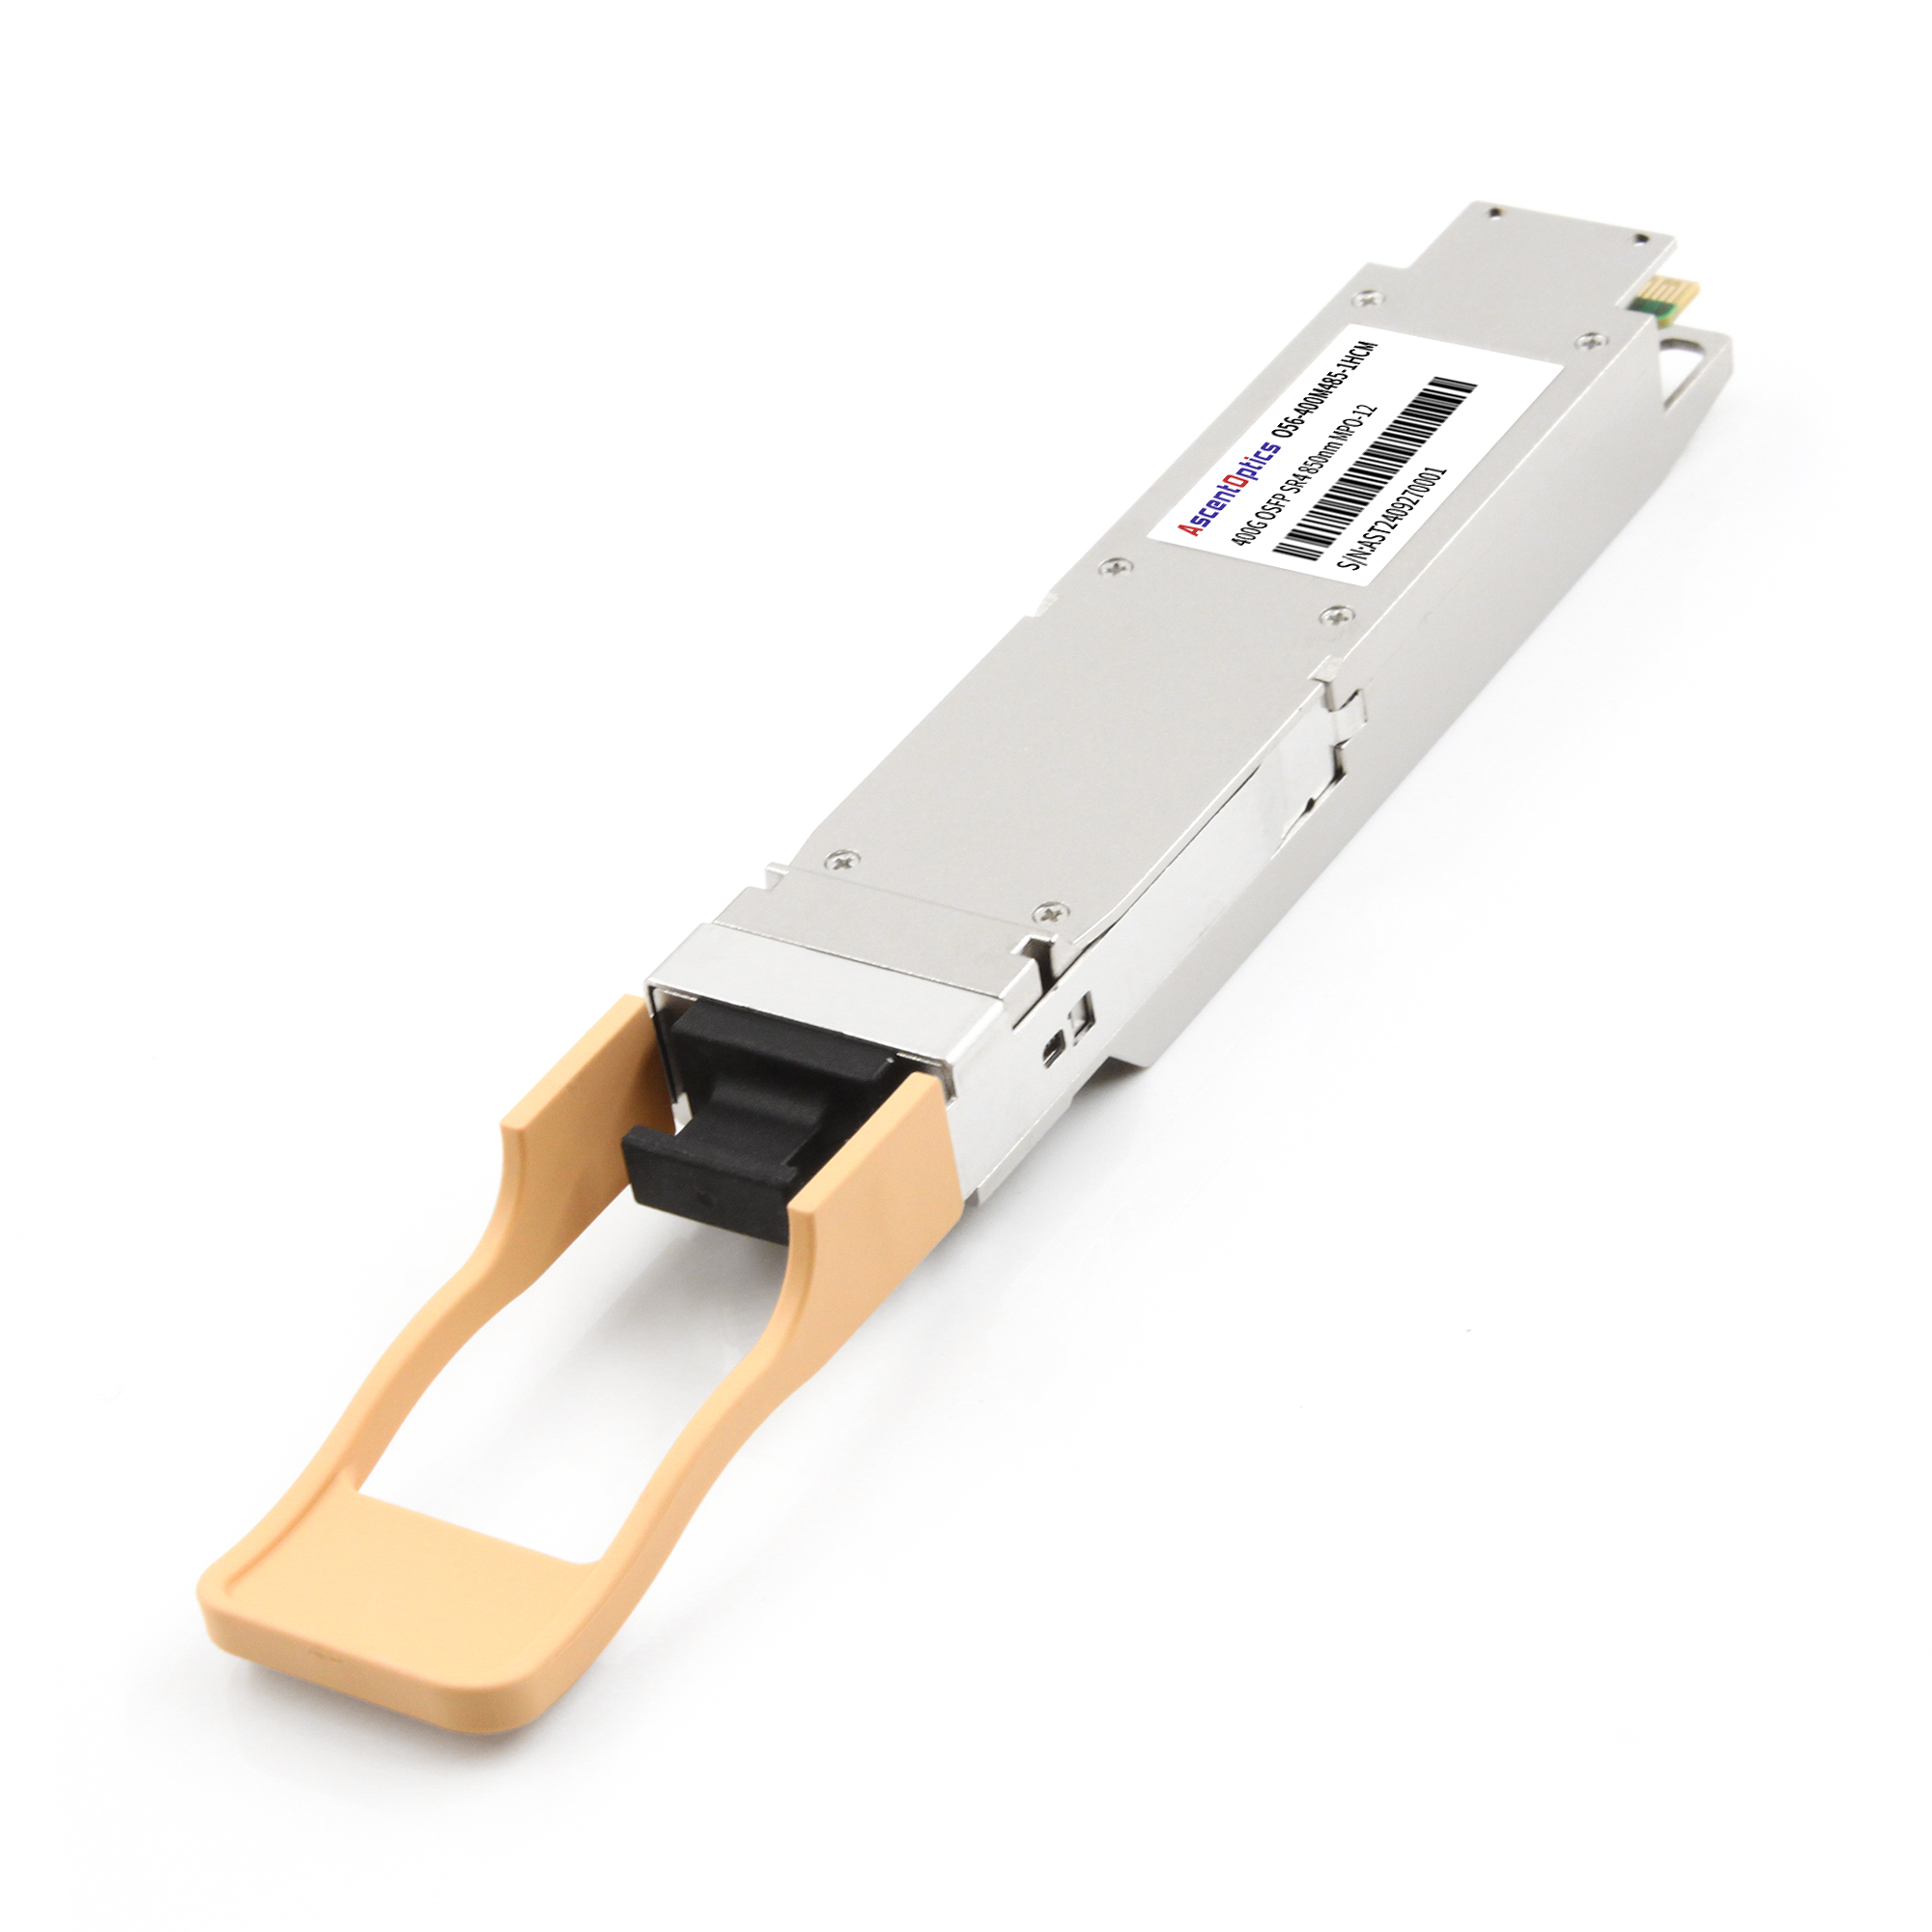
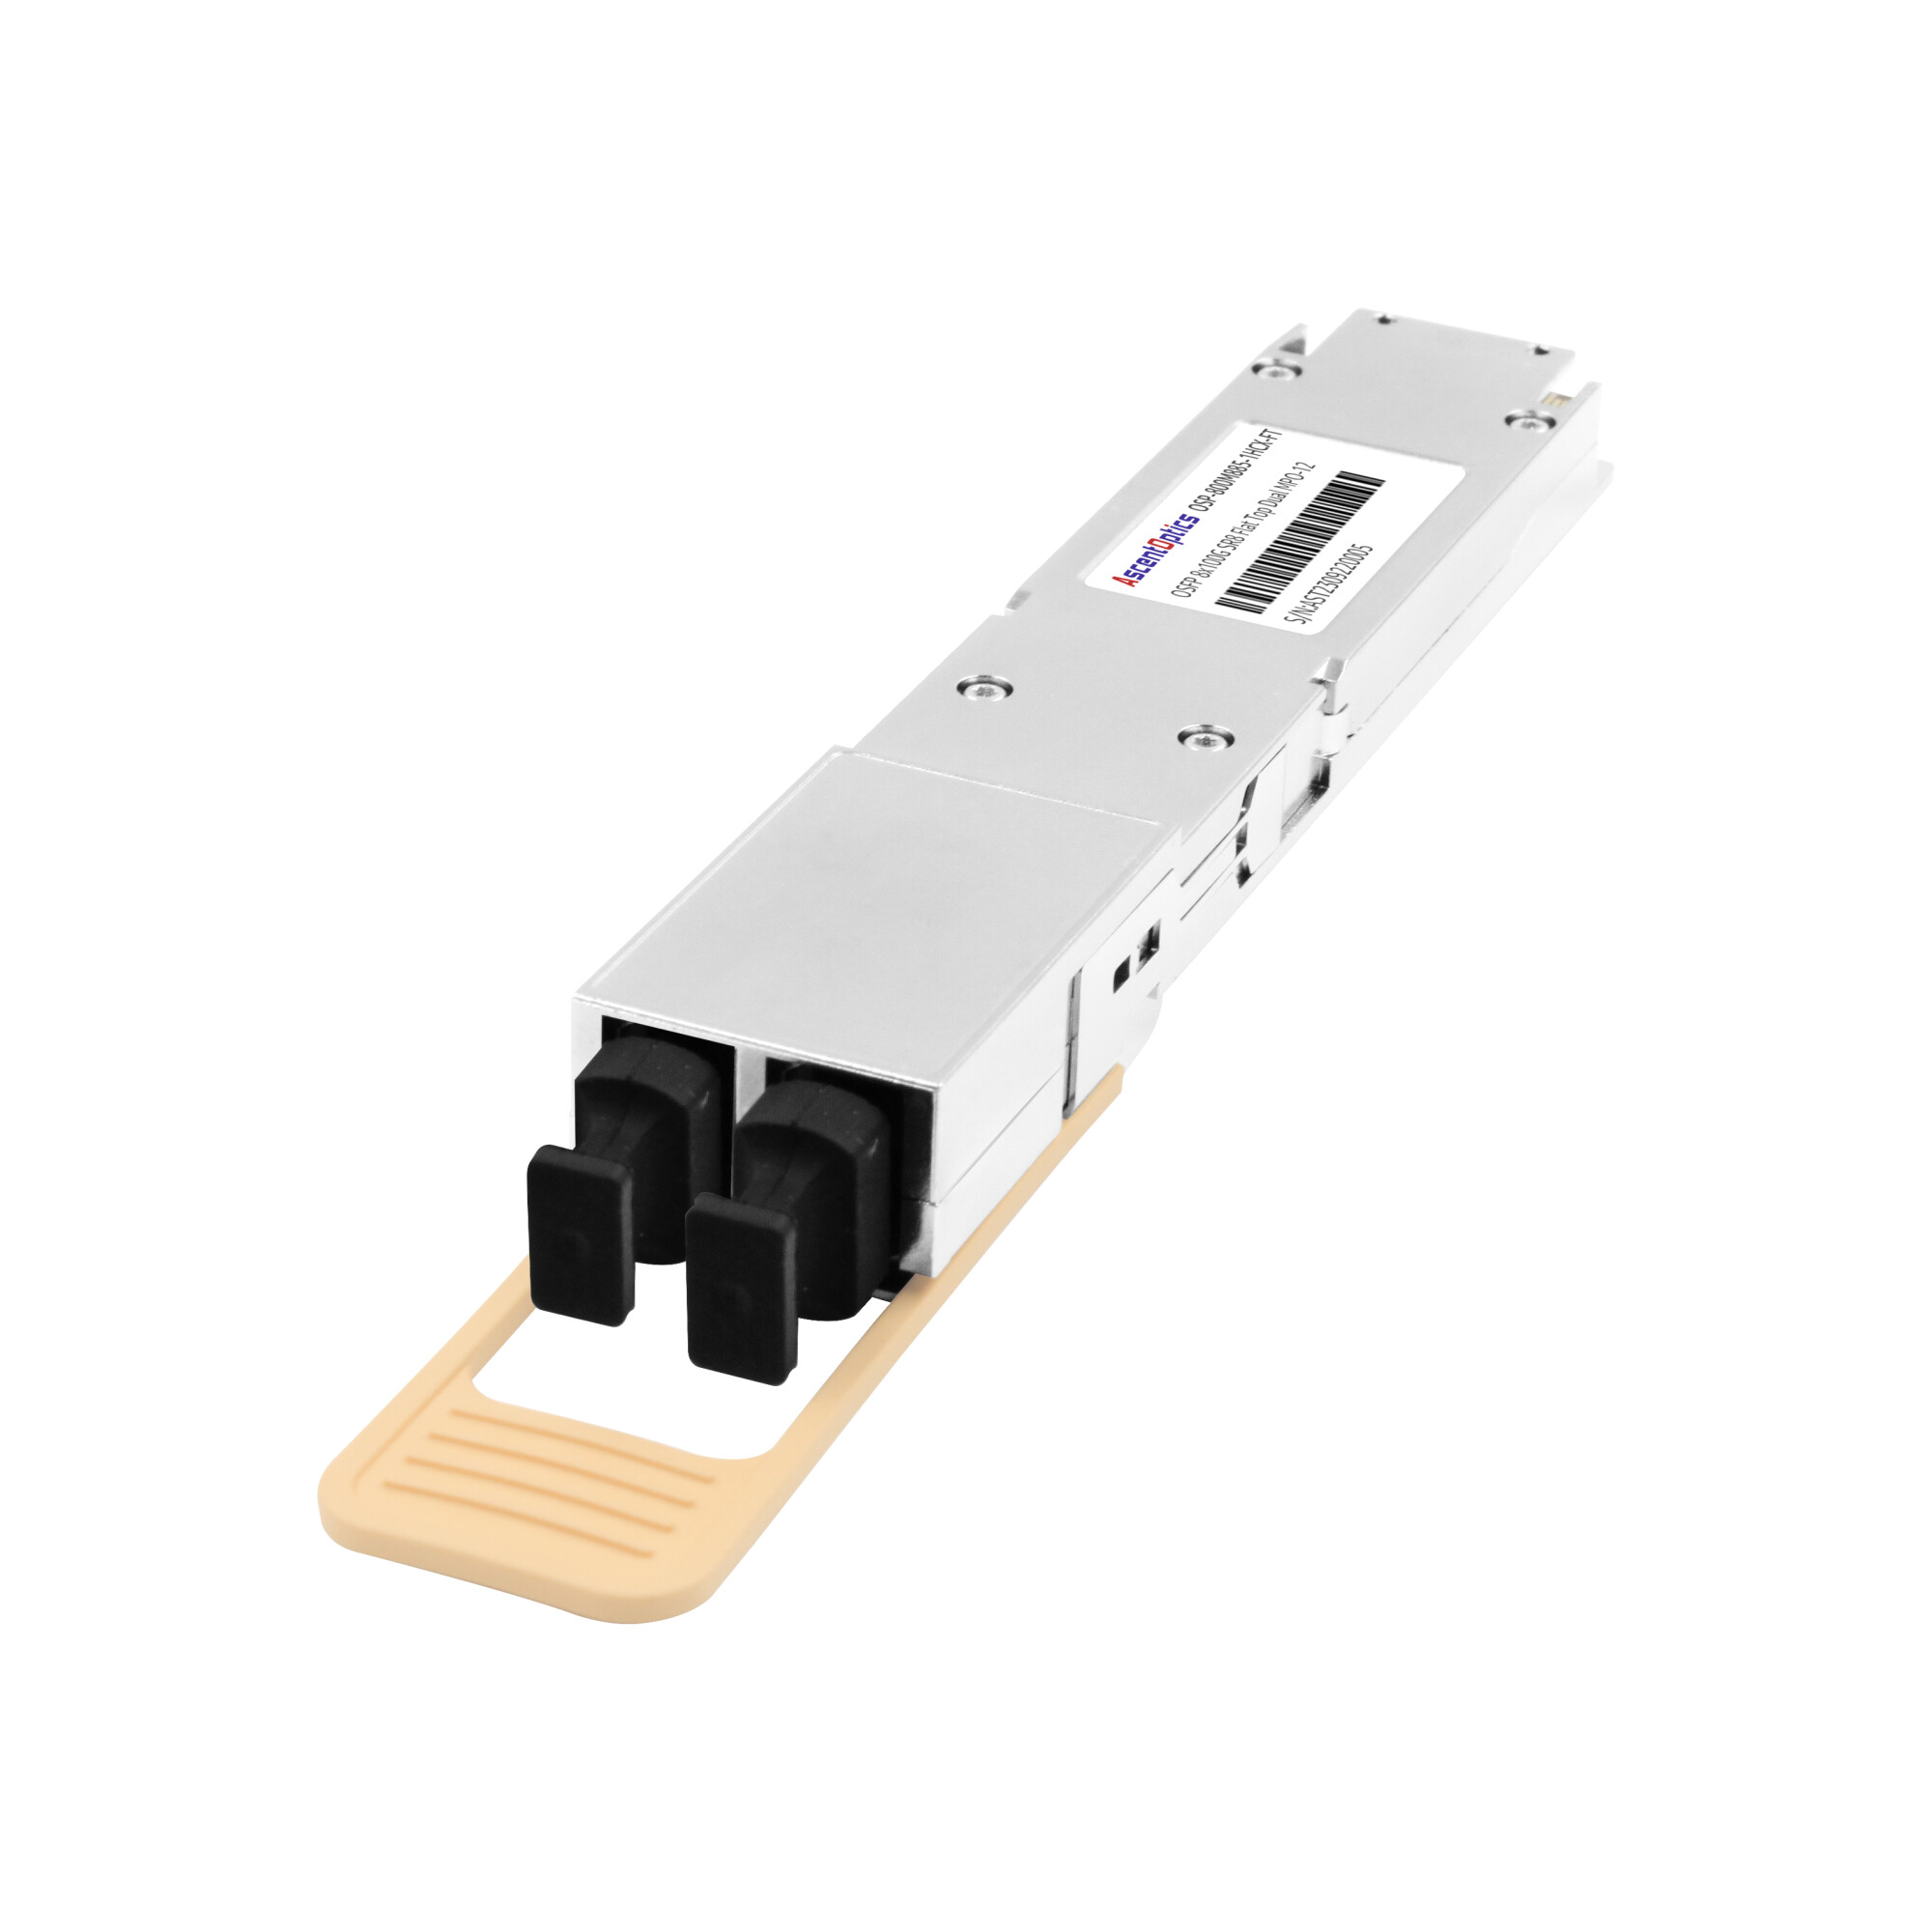
ماژول نوری با فرم فاکتور کوچک قابل اتصال (OSFP) از سرعتهای ۴۰۰ گیگابیت/۸۰۰ گیگابیت پشتیبانی میکند و از مدولاتورهای فوتونیک سیلیکونی (SiPh) یا EML بهره میبرد. در استقرارهای هوش مصنوعی، ماژولهای OSFP برای انتقال در فواصل دور (بیش از ۱۰۰ متر) استفاده میشوند و امکان اتصال دو طرفه تا ۴ ترابیت بر ثانیه را فراهم میکنند. به عنوان مثال، چیپستهای OCI اینتل از DWDM برای دستیابی به مصرف برق کم (حدود ۵ پیکوژول بر بیت) استفاده میکنند.
۲. کابل اتصال مستقیم (DAC)
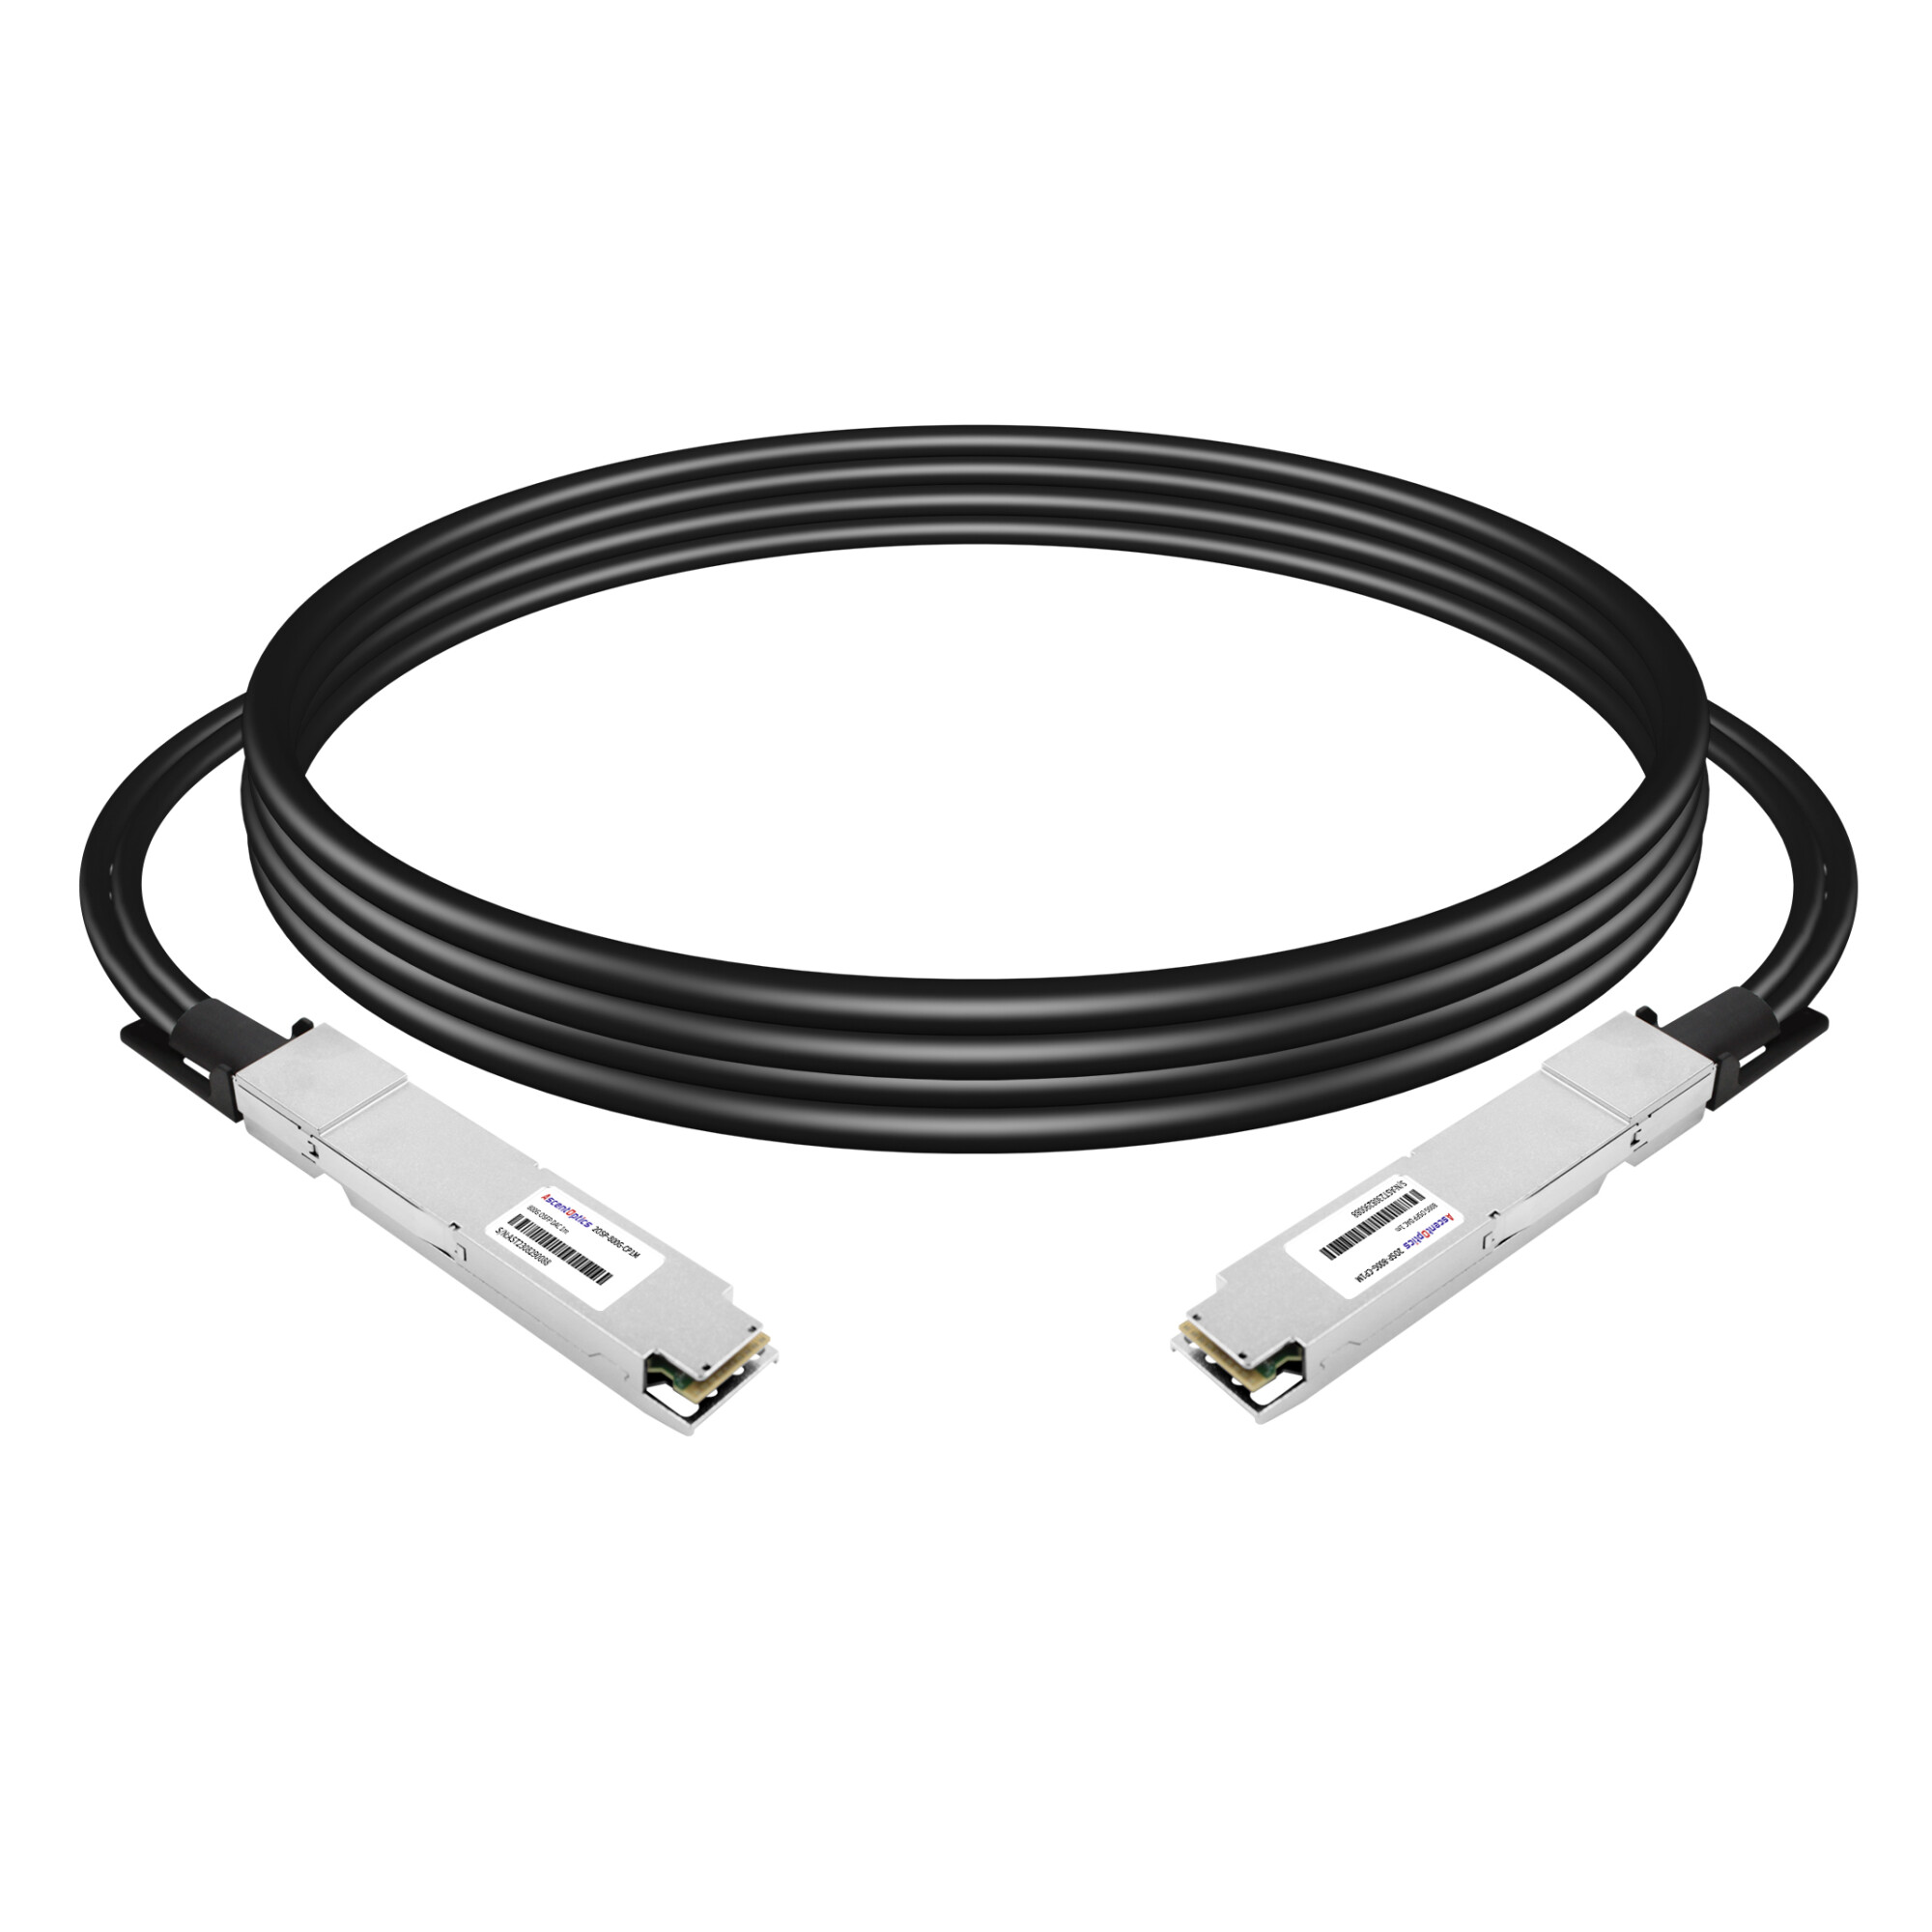
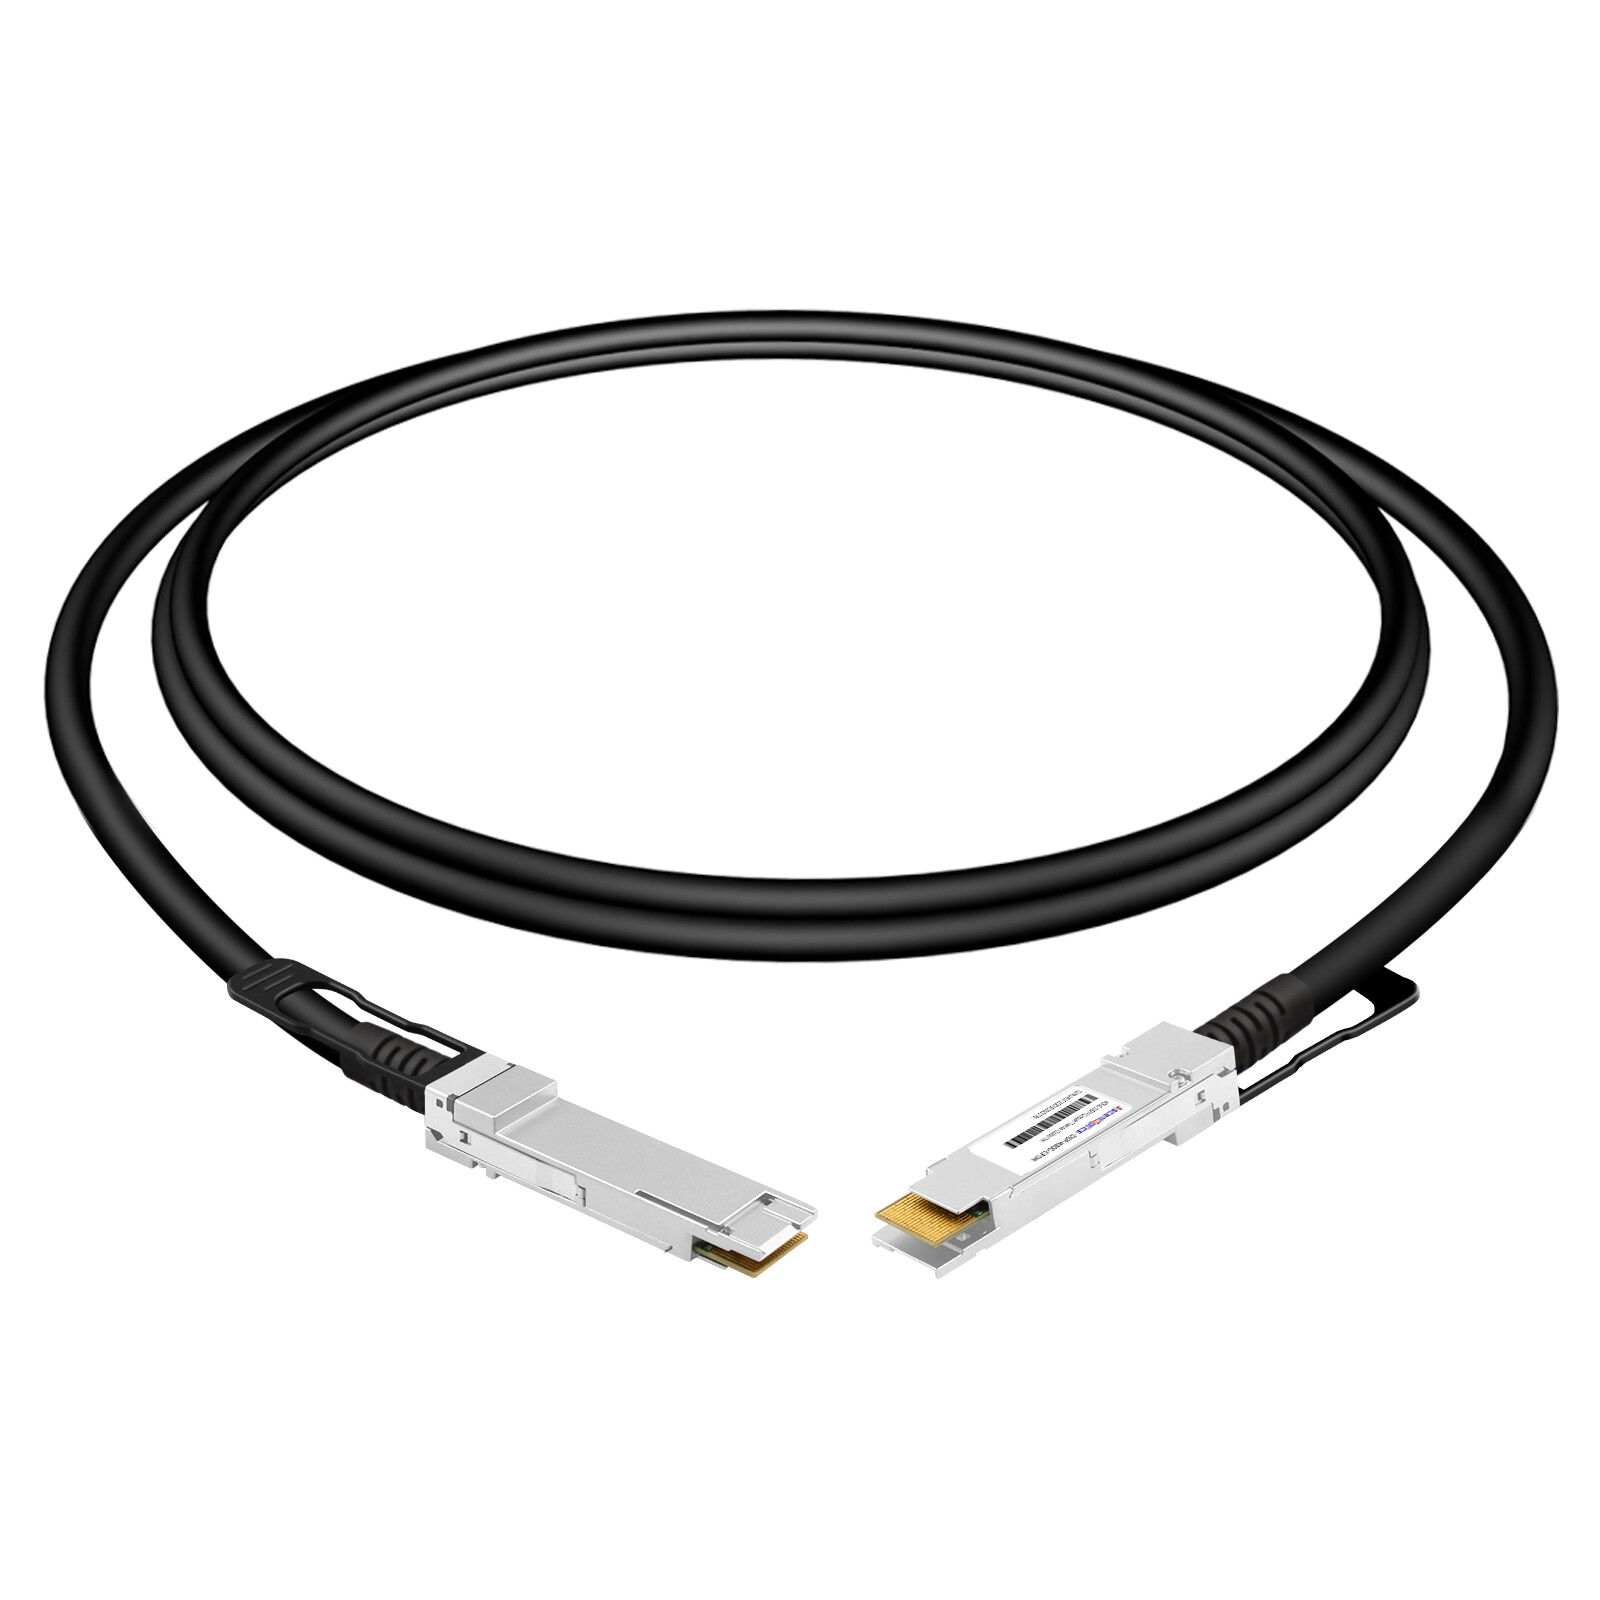
یک راهکار مبتنی بر مس که برای اتصالات درون رک با برد کوتاه (کمتر از 7 متر) طراحی شده است، DAC یک گزینه مقرون به صرفه بدون نیاز به تبدیل نوری-الکتریکی ارائه میدهد. در کلاسترهای هوش مصنوعی، راهکارهایی مانند کارت شبکه AMD Pensando Pollara 400 از DACها برای ارائه پهنای باند 400 گیگابیت بر ثانیه استفاده میکنند و در عین حال از RDMA (دسترسی مستقیم از راه دور به حافظه) برای تسریع انتقال دادهها پشتیبانی میکنند.
3. AOC (کابل نوری فعال)
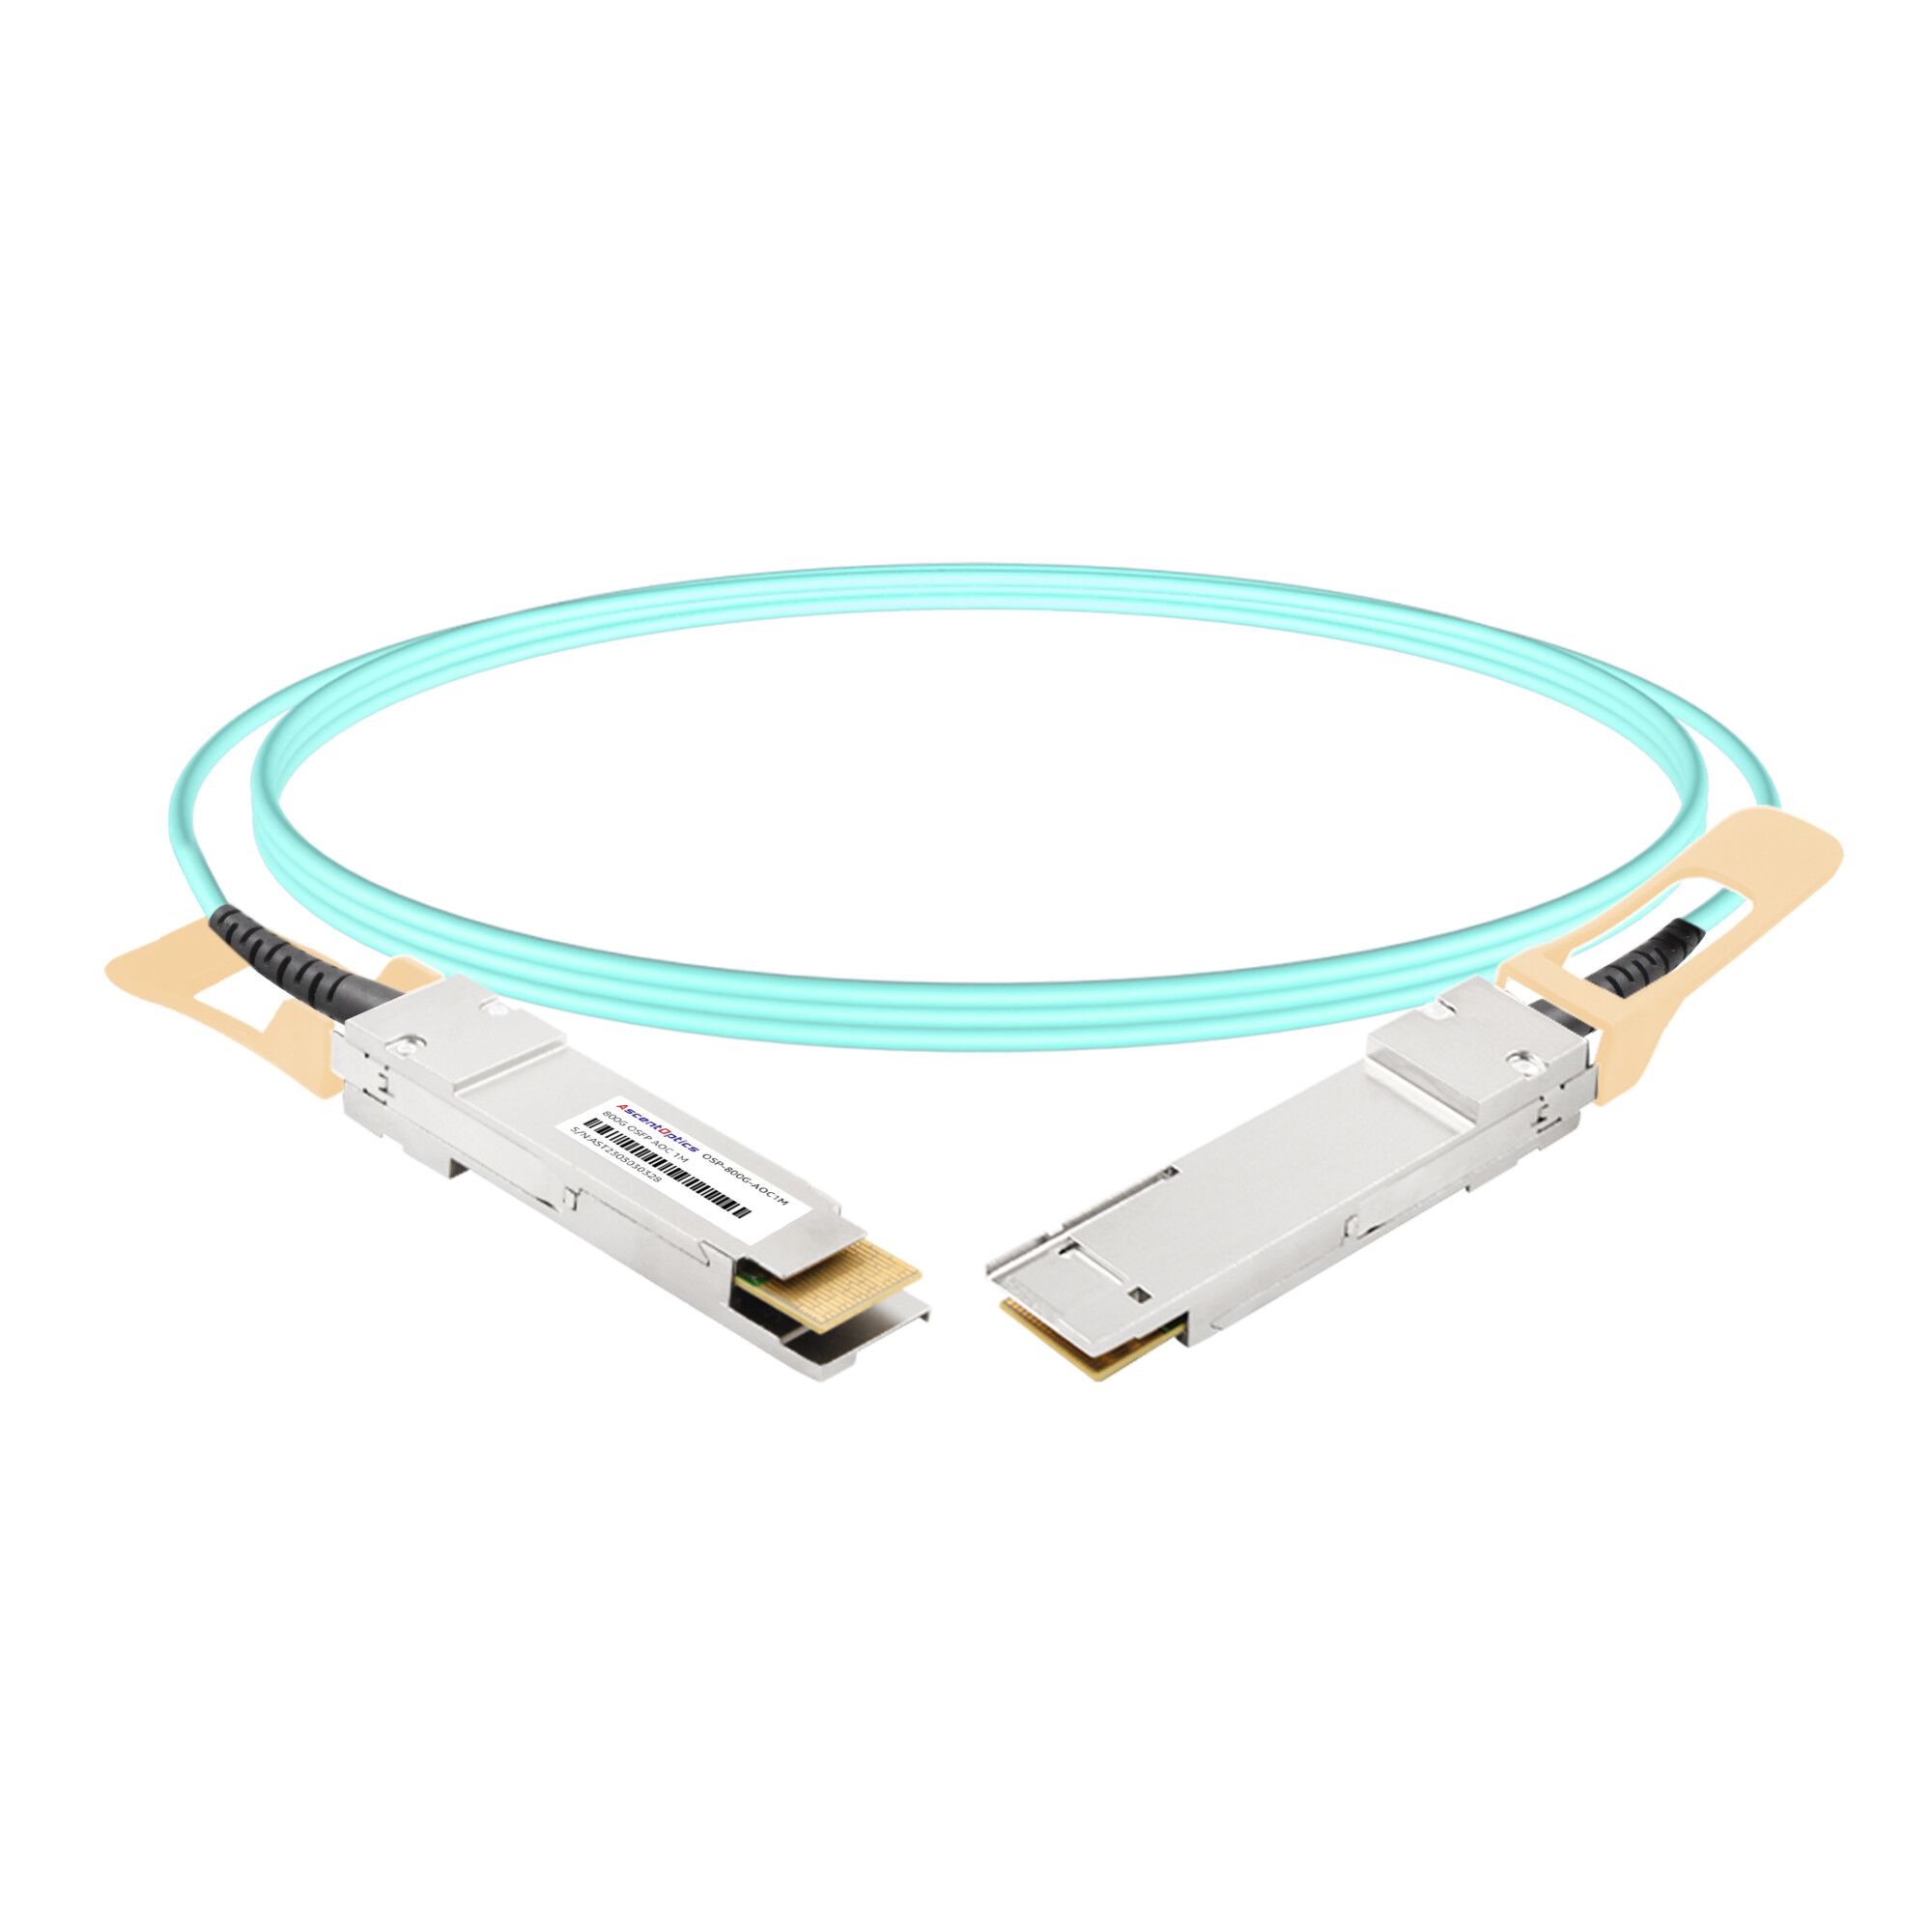
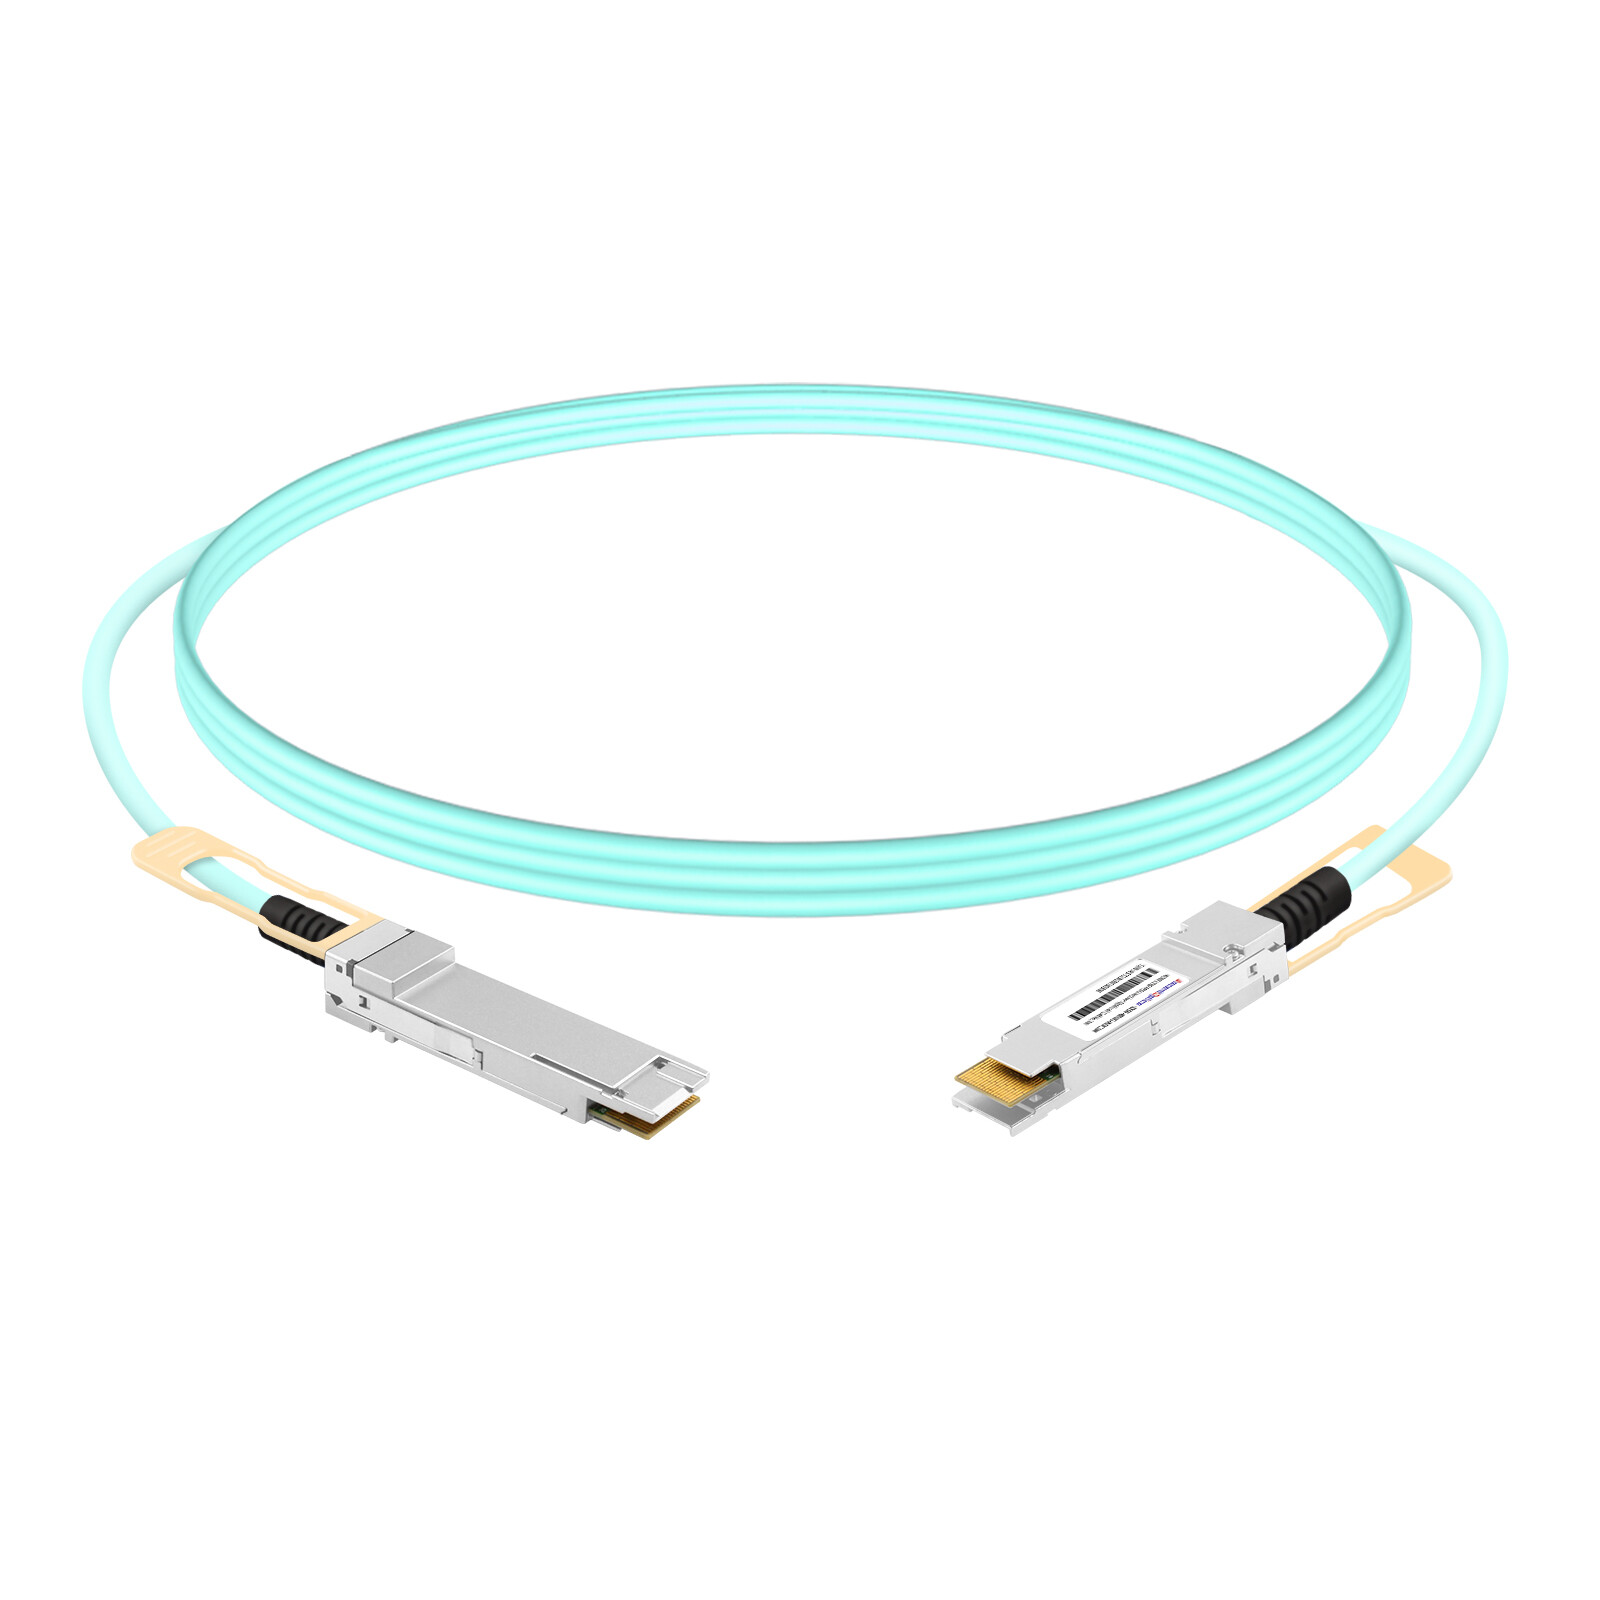
با داشتن فرستنده-گیرندههای نوری یکپارچه، AOCها برای اتصالات با برد متوسط (7 تا 100 متر) مناسب هستند. آنها قابلیت اطمینان بالاتری را فراهم میکنند و به جلوگیری از آلودگی پورت کمک میکنند. در محیطهای هوش مصنوعی، AOCها به طور گسترده برای کابلکشی موازی استفاده میشوند و از استقرار مراکز داده 800G پشتیبانی میکنند.
در کاربردهای عملی، این فناوریها مستقیماً عملکرد هوش مصنوعی را افزایش میدهند:
مرحله آموزش: به عنوان مثال، در آموزش توزیعشده Llama 3، از ماژولهای 400G SR4 برای تضمین ارتباط با تأخیر کم بین پردازندههای گرافیکی (GPU) و بهبود بهرهوری استفاده میشود.
مرحله استنتاج: پردازش بلادرنگ Gemini 2.5 برای دستیابی به انتقال داده ۳۲۰۰ گیگابیت بر ثانیه به AOC 800G متکی است.
مطالعه موردی: کلاستر Stargate شرکت OpenAI از کارتهای شبکه سفارشی ۸۰۰GbE استفاده میکند که هر پردازنده گرافیکی به ۸ پورت OSFP مجهز شده و عملکرد شبکه ۲ برابر را ارائه میدهد. کارت شبکه Vulcano شرکت AMD توان عملیاتی ۸۰۰ گیگابیت بر ثانیه را فراهم میکند و از استاندارد UC 1.0 پشتیبانی میکند.
متنباز و مقیاسپذیری: برای مثال، DeepSeek V3 از RDMA برای بهینهسازی اتصالات داخلی و کاهش هزینههای پلسازی استفاده میکند.
در پیادهسازیهای عملی، این فناوریهای اتصال متقابل اغلب به صورت ترکیبی استفاده میشوند: DAC و AOC برای اتصالات کوتاهبرد درون یا بین رکهای مجاور، با ارائه هزینه کم، تأخیر کم و کابلکشی ساده در مقیاس بزرگ، بهترین گزینه هستند. از سوی دیگر، ماژولهای نوری OSFP در درجه اول برای اتصالات بین رکها یا حتی بین سالنهای داده مستقر میشوند و پهنای باند، پایداری و مقیاسپذیری بالاتری را در فواصل طولانیتر ارائه میدهند. این رویکرد لایهای به مراکز داده اجازه میدهد تا هزینه، مصرف برق و عملکرد را متعادل کنند و در نتیجه از نیازهای آموزش و استنتاج خوشههای هوش مصنوعی در مقیاس بزرگ پشتیبانی کنند.
به طور خلاصه، ادغام فناوریهای اتصال پرسرعت با مدلهای پیشرفته هوش مصنوعی، دوره بعدی نوآوری در مراکز داده را شکل میدهد. ترکیب جدیدترین مدلهای هوش مصنوعی با اتصالات 400G/800G نه تنها همافزایی فناوری را نشان میدهد، بلکه نقش حیاتی زیرساختها را در اکوسیستم هوش مصنوعی برجسته میکند. فناوری اتصال صرفاً یک عامل توانمندساز هوش مصنوعی نیست - بلکه سنگ بنای توسعه آینده آن است.